


Python实现MySQL数据库批量新增数据的实操指南

发布时间:2026-10-12 |
3人浏览过
针对数据压测、模拟登录或脚本初始化等需快速填充大量记录的场景,本文对比了JMeter与存储过程的局限,重点讲解使用Python结合PyMySQL库的操作流程。通过参数化SQL循环执行与显式事务提交,确保高效、安全地完成MySQL批量新增数据任务。
批量插入数据的典型应用场景
在开发与运维过程中,直接面对空库往往需要进行数据预热或环境搭建。常见的批量新增需求包括:
- 进行性能压力测试时,需要构造数万至百万级的测试基线数据。
- 模拟高并发业务,例如让系统承载上千个虚拟用户同时发起登录请求。
- 数据清洗与加工环节,当上游源数据尚未就绪时,需预先向数据库中灌入标准格式的数据以供下游任务处理。
工具对比:为何倾向使用Python
面对批量写库需求,通常有三种主流路径:通过接口自动化框架(如JMeter)、编写数据库存储过程、或使用Python等脚本语言。实际选型应遵循“场景适配”原则而非绝对优劣:
- JMeter擅长模拟真实网络交互与并发流量,适合测试接口层。但若业务涉及文件上传或多端复杂字段校验,纯接口压测的构造成本较高。
- 存储过程直接在数据库内核执行,效率极高,但调试困难,且难以处理跨库关联或复杂的业务逻辑判断。
- Python凭借灵活的字符串处理与成熟的第三方生态,能无缝衔接文件读取、格式转换与SQL拼接,尤其适合自动化运维与数据管道脚本,是当前兼顾开发效率与维护性的首选方案。
第1步:安装依赖与规划环境
Python操作MySQL需借助官方推荐的客户端库。打开命令行终端,执行以下指令安装对应版本:
pip install PyMySQL本示例以本地运行的MySQL服务为基准,提前创建好目标数据库及测试表结构。
第2步:配置连接参数与安全访问
使用pymysql建立长连接前,需明确主机地址、认证凭证及目标实例。为避免硬编码敏感信息,建议将配置独立封装:
import pymysql

Host = '127.0.0.1'
user = 'root'
pwd = '123456'
port = 3306
database = 'target_db'  # 请替换为实际库名

conn = pymysql.connect(host=Host, user=user, password=pwd, port=port, db=database)
cursor = conn.cursor()
第3步:构造参数化SQL并循环执行
批量插入的核心在于避免逐条手动拼装。采用预编译占位符配合元组传参,既能提升执行速度,又能防止SQL注入风险。以下为完整执行逻辑:
sql = "INSERT INTO food_table (id, name, price, desc, img) VALUES (%s, %s, '10', 'automation test', '17.jpg');"

current_id = 100
for index in range(1, 11):
    current_id += 1
    # 使用元组传递参数,替代不安全的字符串格式化
    params = (str(current_id), f"testitem{index}")
    cursor.execute(sql, params)
第4步:提交事务与释放资源
数据库默认开启自动提交,但在处理大批量操作时,显式调用commit()可保证数据的原子性与完整性。完成后务必按序关闭游标与连接,防止TCP连接泄漏:
# 确认执行成功并提交结果
conn.commit()
print(f"本次共成功插入 {cursor.rowcount} 条数据。")

# 释放资源
cursor.close()
conn.close()执行上述脚本后,目标表将稳定追加新记录。实际生产环境中,可根据表结构与主键约束调整字段映射关系,必要时可结合executemany()进一步提升吞吐性能。
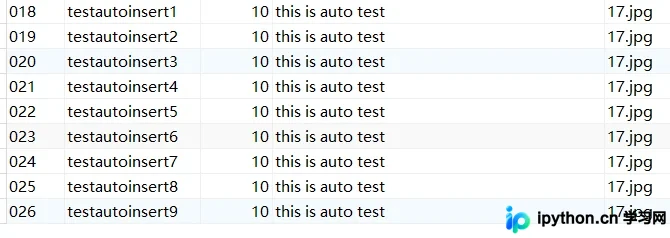
以上就是使用Python实现MySQL数据库批量新增数据的详细内容,更多关于Python操作MySQL与自动化数据构建的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















