


C语言堆排序原理与实现详解

发布时间:2026-10-16 |
6人浏览过
堆排序是基于二叉树结构的高效排序算法,其核心在于利用最大堆或最小堆的特性进行元素交换与重排。本文将深入解析C语言中堆的构建、调整算法(向下与向上)及完整排序过程,提供可直接运行的代码示例并分析其时间复杂度。
1. 堆的基本概念
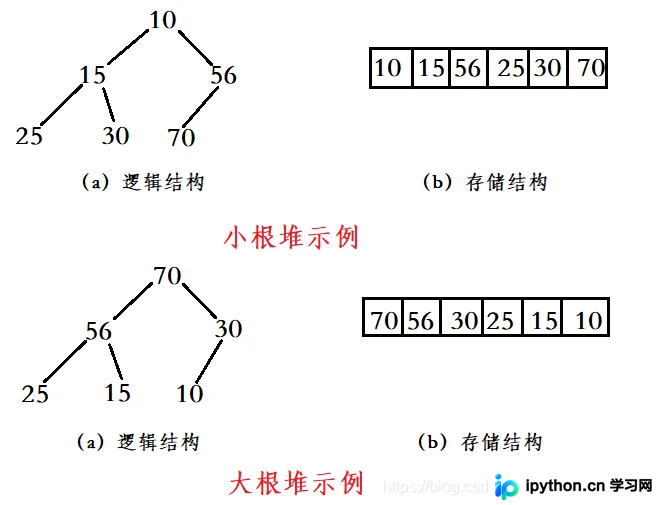
堆在逻辑上是一棵完全二叉树,物理上通常存储在一维数组中。根据根节点与子节点的大小关系,堆分为两类:
- 大堆(Max Heap):根节点的值大于或等于其左右子节点的值,即
Ki >= K2i+1且Ki >= K2i+2。 - 小堆(Min Heap):根节点的值小于或等于其左右子节点的值,即
Ki <= K2i+1且Ki <= K2i+2。
堆具备两个关键性质:
- 某个节点的值总是不大于或不小于其父节点的值。
- 堆总是一棵完全二叉树。
2. 核心操作算法
要实现堆排序,首先需要掌握堆的两个基本调整算法:向下调整和向上调整。
第1步:理解向下调整算法
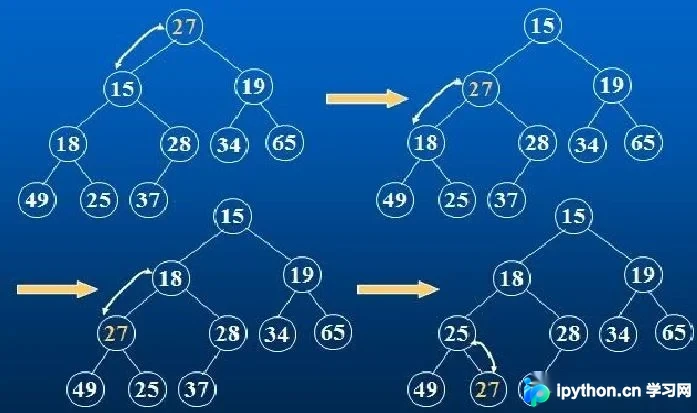
向下调整算法用于维护堆的结构性质。其前提条件是:当前节点的左右子树必须已经是合法的堆。
执行逻辑:
- 从当前父亲节点开始,比较其左右子节点的大小。
- 找出较小(针对小堆)或较大(针对大堆)的子节点。
- 将该子节点与父亲节点交换,使更“极端”的值向根方向移动,反之向叶子方向沉降。
- 继续对交换后的子节点位置递归执行此过程,直到叶子节点或满足堆性质为止。
// 辅助函数:交换两个整数
void swap(int *x, int *y)
{
    int temp = *x;
    *x = *y;
    *y = temp;
}

// 堆向下调整算法(以建立小堆为例)
// a: 数组指针, n: 数组有效元素个数, root: 需要调整的根节点下标
void AdjustDown(int *a, int n, int root)
{
    int parent = root;
    int child = parent * 2 + 1; // 左孩子下标

    while (child < n) // 当存在孩子节点时循环
    {
        // 如果右孩子存在,且右孩子比左孩子更小,则选中右孩子
        if (child + 1 < n && a[child] > a[child + 1])
        {
            ++child;
        }

        // 如果孩子节点比父亲节点小,则不满足小堆性质,需要交换
        if (a[child] < a[parent])
        {
            swap(&a[child], &a[parent]);
            // 下沉后,更新parent和child,继续向下检查
            parent = child;
            child = parent * 2 + 1;
        }
        else
        {
            // 如果满足小堆性质,无需继续调整
            break;
        }
    }
}
第2步:理解向上调整算法
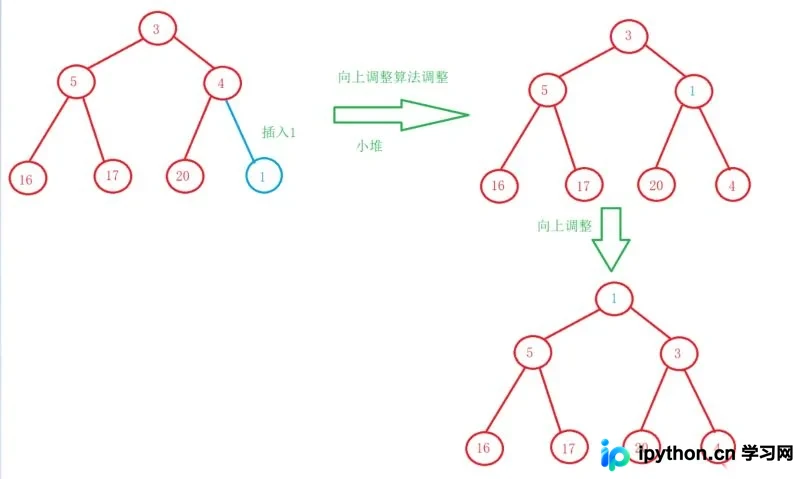
向上调整算法主要用于在堆末尾插入新数据后恢复堆的性质。它从新插入的叶子节点开始,与其父节点比较并交换,直到满足堆性质。
// 堆向上调整算法(以建立小堆为例)
// a: 数组指针, child: 被调整节点的下标
void AdjustUp(int *a, int child)
{
    int parent = (child - 1) / 2; // 计算父节点下标

    while (child > 0)
    {
        // 如果孩子节点比父节点小,则交换
        if (a[parent] > a[child])
        {
            swap(&a[parent], &a[child]);
            child = parent;
            parent = (child - 1) / 2;
        }
        else
        {
            // 已满足堆性质,停止调整
            break;
        }
    }
}
第3步:执行建堆操作
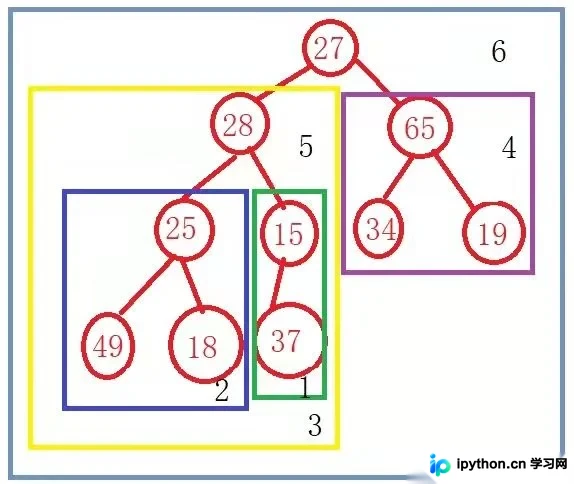
将无序数组构建成堆的最优方法是从最后一个非叶子节点开始,自底向上依次调用向下调整算法。
- 最后一个非叶子节点的下标计算为:
(n - 2) / 2或(n / 2) - 1。 - 不需要从第一个节点开始向上调整,因为叶子节点本身就可以视为一个合法的堆。
// 建堆代码片段(以小堆为例)
int parent = (n - 2) / 2;
while (parent >= 0)
{
    AdjustDown(a, n, parent);
    --parent;
}
3. 堆排序实现流程
堆排序利用堆顶元素是最大值(大堆)或最小值(小堆)的特性进行排序。若要得到升序序列,需要建立大堆;若需降序序列,则建立小堆。以下展示建立小堆实现降序排列的逻辑(注:常规升序排序应建立大堆,此处演示小堆操作以对应前文逻辑,实际升序代码如下):
第4步:完整排序代码
以下是标准的堆排序实现,通过建立大堆来实现升序排列:
// 堆排序主函数(升序)
void HeapSort(int *a, int n)
{
    // 1. 建大堆
    int parent = (n - 2) / 2;
    while (parent >= 0)
    {
        AdjustDownForMax(a, n, parent); // 假设有大堆的向下调整版本
        --parent;
    }

    // 2. 逐个交换并调整
    int end = n - 1;
    while (end > 0)
    {
        // 将最大的数(堆顶)放到最后面
        swap(&a[end], &a[0]);

        // 剩余元素重新调整为大堆(注意范围缩小到end)
        AdjustDownForMax(a, end, 0);

        --end;
    }
}
注:若参考上文的小堆向下调整代码逻辑,建立小堆后,堆顶是最小值。每次将堆顶与末尾元素交换,可得到从大到小的降序序列。若要升序,请优先采用建立大堆的方式。
4. 复杂度分析
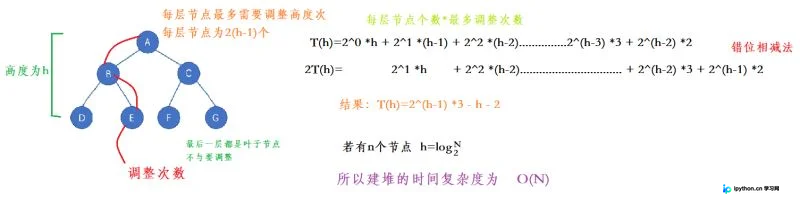
- 建堆时间复杂度:O(N)。虽然单次向下调整是 O(logN),但非叶子节点分布规律使得总体复杂度线性化。
- 排序过程时间复杂度:需要执行 N-1 次交换和调整,每次调整 O(logN),总计 O(N logN)。
- 总时间复杂度:O(N logN),无论最好、最坏和平均情况均稳定保持此效率。
- 空间复杂度:O(1),属于原地排序算法。
以上就是C语言数据结构之堆排序详解的详细内容,更多关于C语言堆排序的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















