


为什么MySQL不建议使用SELECT *:性能陷阱与优化解析

虽然SELECT *在开发初期能简化代码,但其对数据库性能的负面影响不容忽视。本文从磁盘I/O、网络传输、索引失效及连接查询四个维度,深入解析为何在生产环境中应避免使用该语法,并提供相应的优化建议。
“不要使用SELECT *”几乎已成为MySQL使用的一条金科玉律,《阿里Java开发手册》也明确禁止将其作为查询字段列表。尽管它因开发效率高且无需随字段变更修改SQL而受欢迎,但盲目使用会带来显著的性能隐患。
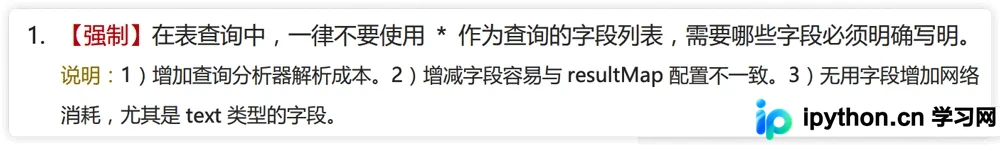
1. 不必要的磁盘I/O开销
MySQL将用户记录存储在磁盘上,查询操作本质上是一次磁盘I/O行为(假设数据未缓存)。当使用SELECT *时,若表中包含TEXT、MEDIUMTEXT或BLOB等大字段,即使业务逻辑并不需要这些数据,MySQL也会读取它们,造成极大的资源浪费。
第1步:理解内存管理机制
许多人误以为SELECT *会占据大量服务器内存,但实际上MySQL Server层采用流式处理模式:
- 每从存储引擎获取一行,即写入内存缓冲区
net_buffer(默认大小由net_buffer_length控制,通常为16KB)。 - 当
net_buffer写满后,再将数据通过本地网络栈的socket send buffer发送给客户端。 - 客户端读取完成后清空
net_buffer,继续下一行。
因此,结果集占用的临时内存最大不超过net_buffer_length,不会因为多查询几个字段而无限增长内存占用。但这并不能掩盖其带来的磁盘读取和网络传输代价。
2. 加重网络时延
承接上一节,虽然单次传输的数据量受net_buffer限制,但如果查询了大量大文本或二进制字段,总数据体积依然巨大。这直接导致TCP通信包的数量增加,进而推高网络延迟。
若MySQL服务器与应用服务器分离,这种开销尤为明显;即便在同一台机器上,TCP协议自身的握手与确认机制也会带来额外的时间成本。
3. 无法使用覆盖索引(Leading to 回表)
这是SELECT *最致命的性能陷阱之一。为了说明这一点,我们先创建一个示例表:
CREATE TABLE `user_innodb` (
  `id` int NOT NULL AUTO_INCREMENT,
  `name` varchar(255) DEFAULT NULL,
  `gender` tinyint(1) DEFAULT NULL,
  `phone` varchar(11) DEFAULT NULL,
  PRIMARY KEY (`id`),
  KEY `IDX_NAME_PHONE` (`name`,`phone`) USING BTREE
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
InnoDB会自动为id主键创建聚簇索引(Clustered Index),其叶子节点包含完整的用户记录,结构如下所示:
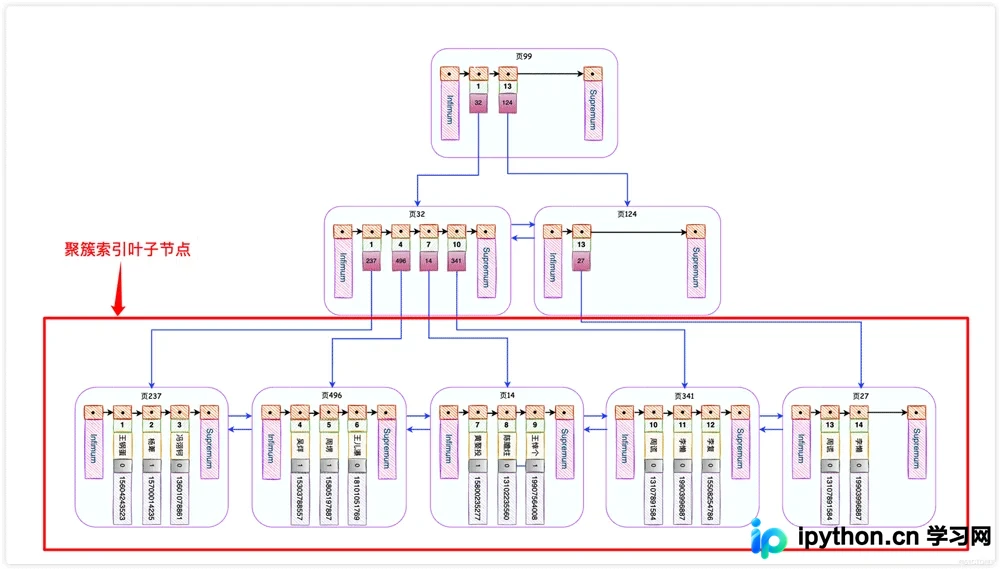
当我们执行以下查询:
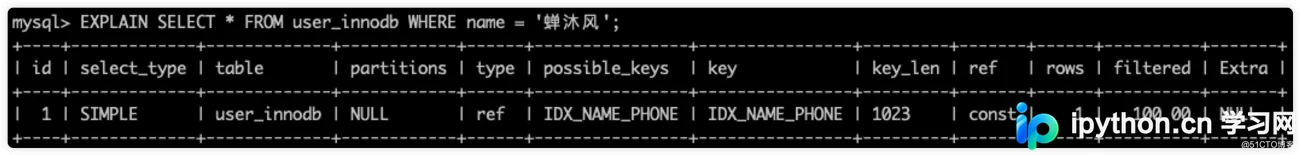
SELECT * FROM user_innodb WHERE name = '蝉沐风';
查看执行计划(见下图)可知,该语句使用了二级索引IDX_NAME_PHONE。二级索引的叶子节点仅包含索引列(name, phone)和主键id:
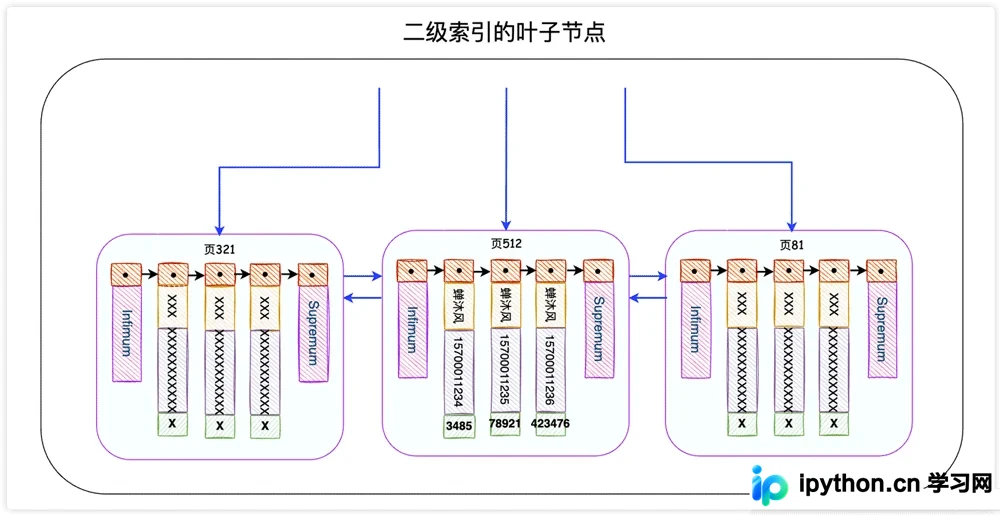
由于SELECT *要求返回所有字段,InnoDB必须拿着找到的主键id,回到聚簇索引中去查找完整的一行数据,这个过程称为回表(Bookmark Lookup)。
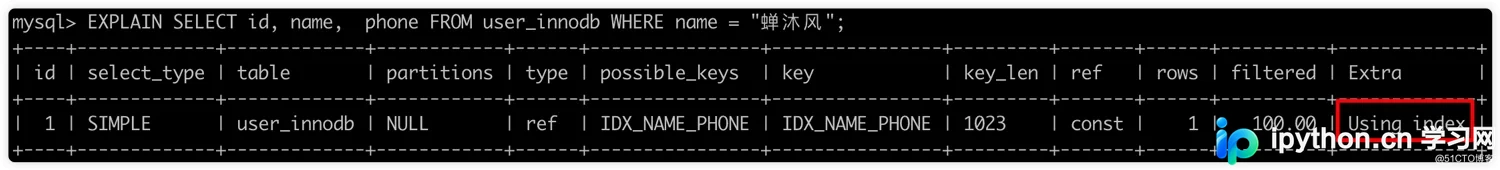
如何避免回表?使用覆盖索引。如果我们只查询索引中包含的字段:
SELECT id, name, phone FROM user_innodb WHERE name = "蝉沐风";
执行计划显示Extra列为Using index,表示查询列完全被索引覆盖,无需回表即可获取结果,效率大幅提升:
4. 拖慢JOIN连接查询效率
在多表连接时,SELECT *会进一步恶化性能。我们创建两张表进行演示:
CREATE TABLE `t1` (
  `id` int NOT NULL,
  `m` int DEFAULT NULL,
  `n` int DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT;

CREATE TABLE `t2` (
  `id` int NOT NULL,
  `m` int DEFAULT NULL,
  `n` int DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT;
若执行强制驱动表的连接查询:
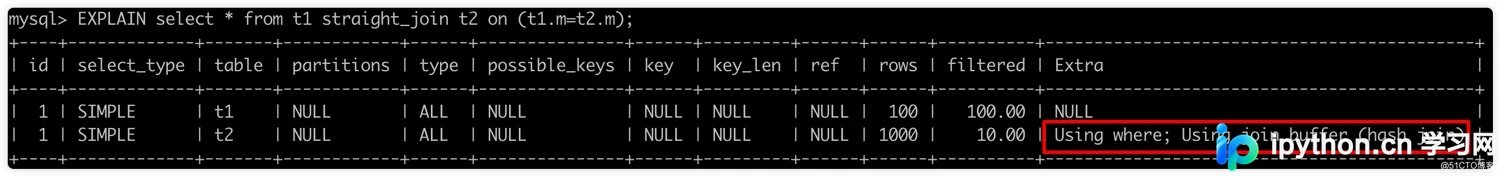
SELECT * FROM t1 STRAIGHT_JOIN t2 ON t1.m = t2.m;
在没有索引辅助的情况下,MySQL会使用嵌套循环连接(NLJ),这会反复扫描被驱动表。虽然现代MySQL通常会使用更高效的策略,但无论哪种策略,SELECT *都有害:
对于基于内存块的算法(如MySQL 8.0前的BLJ或新的Hash Join),系统会使用一个固定大小的内存区域join buffer来暂存驱动表的部分记录以匹配被驱动表:
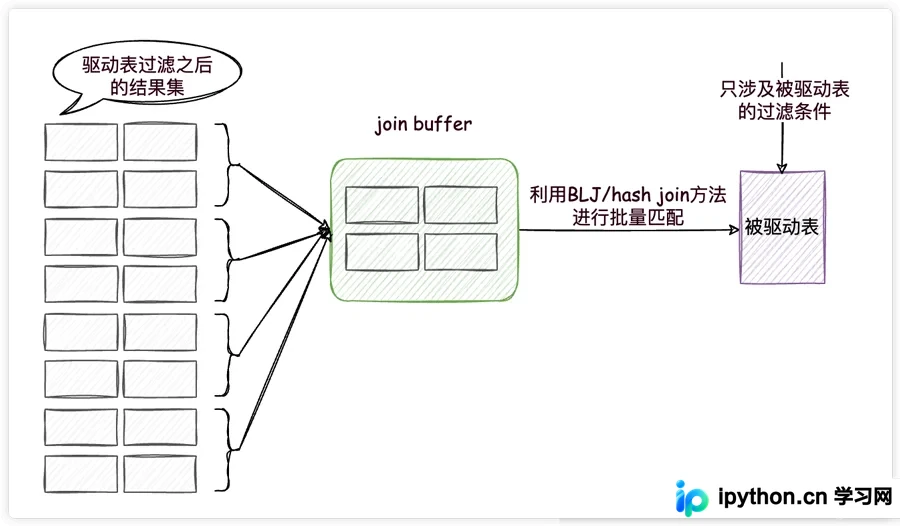
关键在于:只有查询列表中的列才会放入join buffer中。如果使用SELECT *,会将不需要的字段也塞入这个有限的缓冲区,导致join buffer更快满载。一旦满员,MySQL就必须分批处理,多次访问被驱动表,从而增加I/O消耗。
执行计划证实了这一点(见下图,展示Hash Join机制):
总结而言,尽量避免SELECT *,显式指定所需的字段,不仅能避开回表开销,还能提高join buffer的利用率,是提升MySQL SQL性能的通用法则。
以上就是关于为什么MySQL不建议使用SELECT *的详细内容,更多关于MySQL查询优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















