


C语言排序算法详解:冒泡、快速与归并实现及复杂度对比

掌握高效的排序逻辑是C语言开发的基石。本文系统讲解冒泡排序的优化技巧、快速排序的三种分区实现(挖坑法、左右指针法、前后指针法)以及归并排序的分治过程,并结合代码分析其时间复杂度、空间复杂度与稳定性,为实际编程中的算法选型提供参考。
1. 冒泡排序及其优化
冒泡排序是一种基础的交换排序,核心思想是通过重复遍历待排序列,依次比较相邻两个元素的值,若顺序错误则交换它们。每一轮遍历会将当前未排序部分的最大值“冒泡”至末尾。
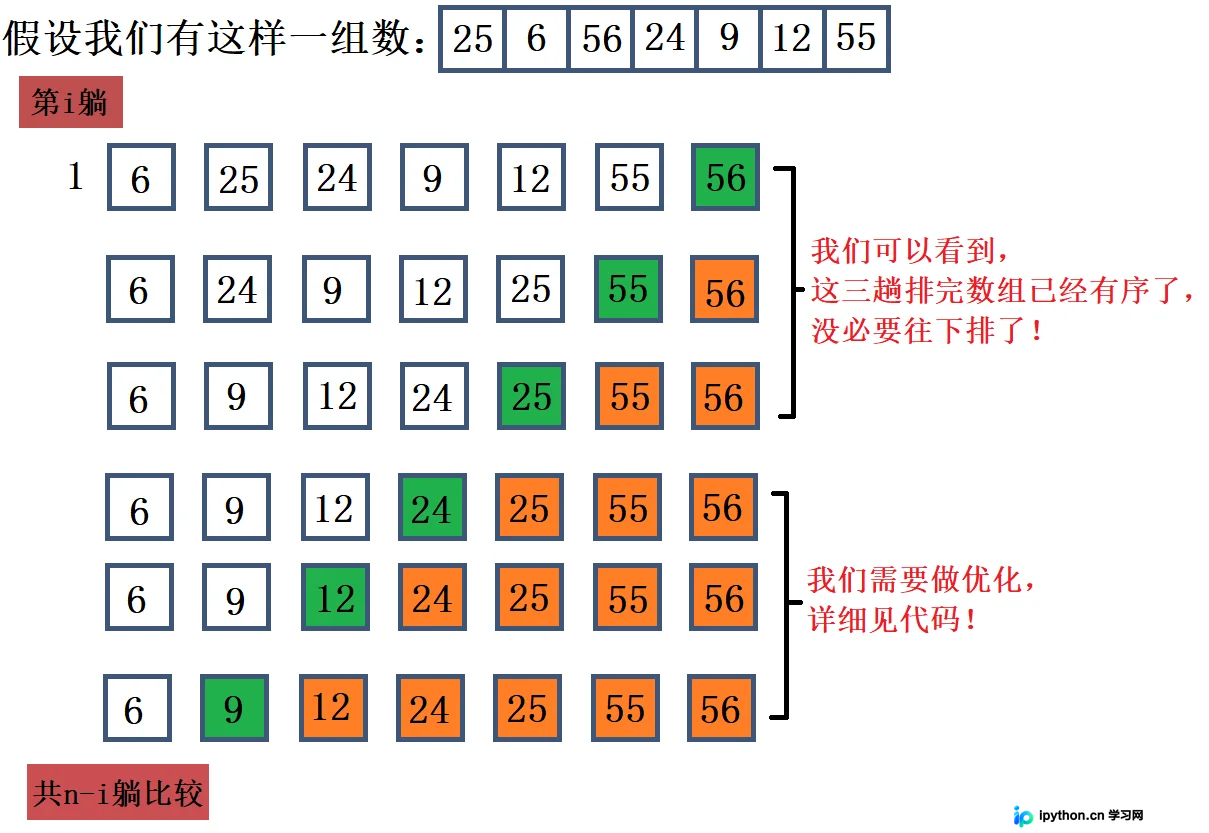
标准冒泡排序的时间复杂度始终为 O(N^2),但在处理已有序或部分有序的数据时存在性能浪费。通过引入一个 exchange 标志位,可以在某趟遍历中未发生任何交换时提前终止循环,从而显著提升最佳情况下的执行效率。
void BubbleSort(int* a, int n)//升序
{
	//时间复杂度O(N^2)
	while (n > 0)
	{
		int exchange = 0;
		for (int i = 1; i < n; ++i)//防止越界访问
		{
			if (a[i - 1] > a[i])
			{
				Swap(&a[i - 1], &a[i]);//交换
				exchange = 1;
			}
		}
		if (exchange == 0)
		{
			break;//若无交换,说明数组已有序,直接退出
		}
		--n;//每轮确定一个最大值位置
	}
}
特性总结
- 时间复杂度:
O(N^2)(平均与最坏),O(N)(最好,已有序且启用优化)。 - 空间复杂度:
O(1),仅使用常数级额外空间。 - 稳定性:稳定。相等元素的相对位置在排序后不会改变。
2. 快速排序(Quick Sort)
快速排序是目前基于比较的内部排序中速度最快的方法之一,由 C.A.R. Hoare 提出。它采用分治法(Divide and Conquer):
- 选基准:从区间中选取一个元素作为基准值(Key/Pivot)。
- 分区:将小于基准的元素移到左边,大于基准的元素移到右边,使基准位于正确位置。
- 递归:对左右两个子区间重复上述过程,直到区间长度为1或0。
快速排序的核心在于分区操作的实现,以下是三种常见的C语言实现方式。
第1步:挖坑法实现分区
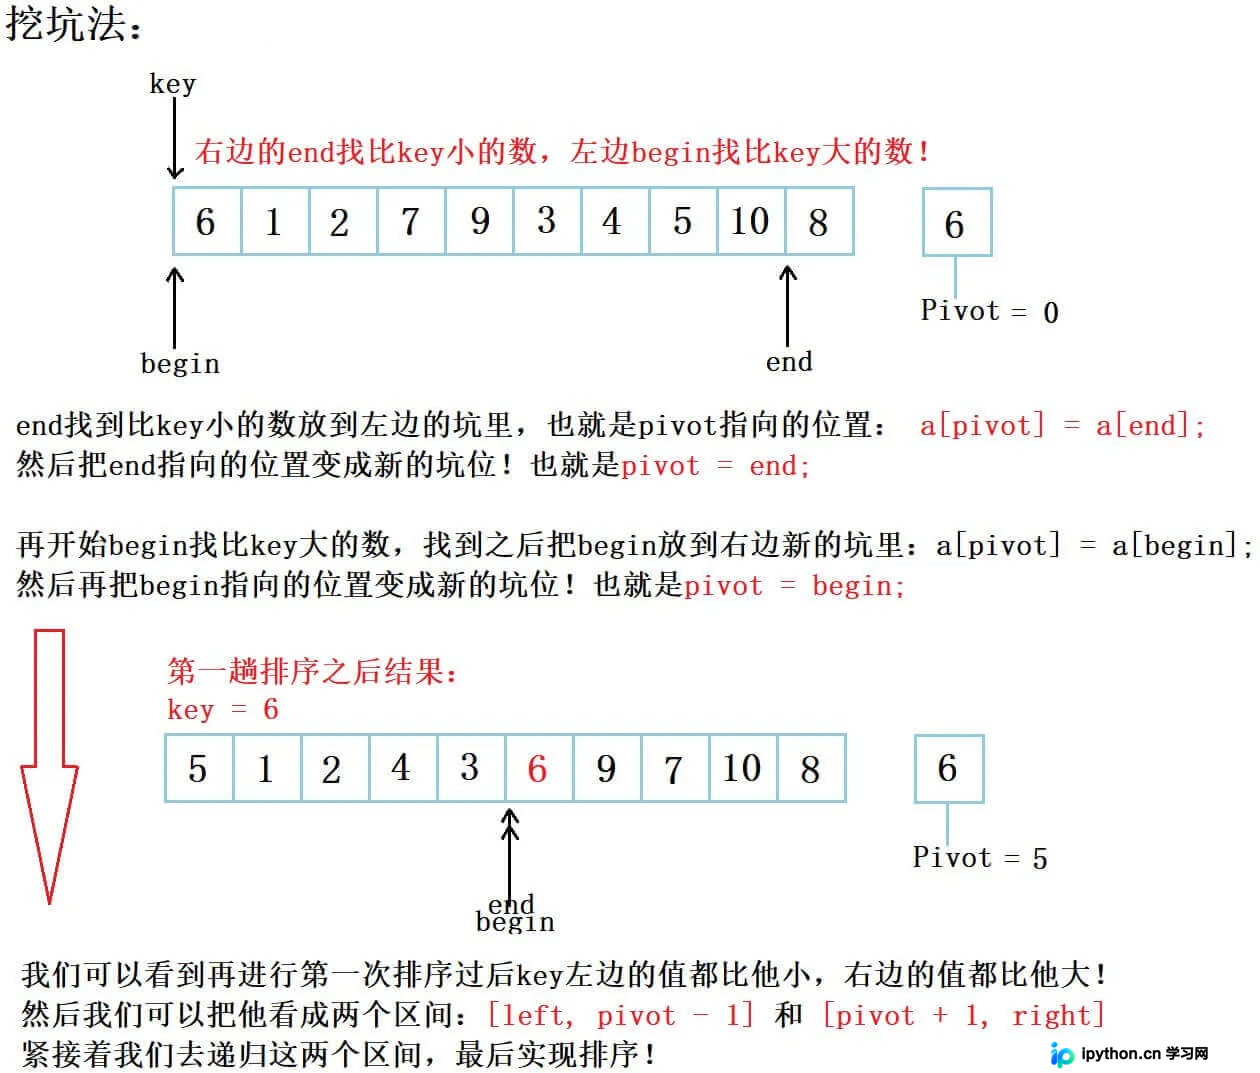
挖坑法的思路是选择一个基准值(通常为第一个元素)并取出,形成“坑”。然后从右向左找小,填入左边的坑,再从左向右找大,填入右边的坑,如此反复直到两指针相遇,最后将基准值放回最终位置。
void QuickSort_Hole(int* a, int left, int right)//升序
{
	if (left >= right)
	{
		return;
	}

	int begin = left;
	int end = right;
	int pivot = begin;
	int key = a[begin]; // 取出基准值,形成坑

	while (begin < end)
	{
		//右边找小
		while (begin < end && a[end] >= key)
		{
			--end;
		}
		//小的放到左边的坑里,自己形成了新的坑位
		a[pivot] = a[end];
		pivot = end;

        //左边找大
		while (begin < end && a[begin] <= key)
		{
			++begin;
		}
		//大的放到左边的坑里,自己形成了新的坑位
		a[pivot] = a[begin];
		pivot = begin;
	}

	//当begin和end相遇,证明他们两都到了坑的位置
	pivot = begin;
	a[pivot] = key; // 将基准值放回

	//递归处理左右子区间
	QuickSort_Hole(a, left, pivot - 1);
	QuickSort_Hole(a, pivot + 1, right);
}
第2步:左右指针法实现分区
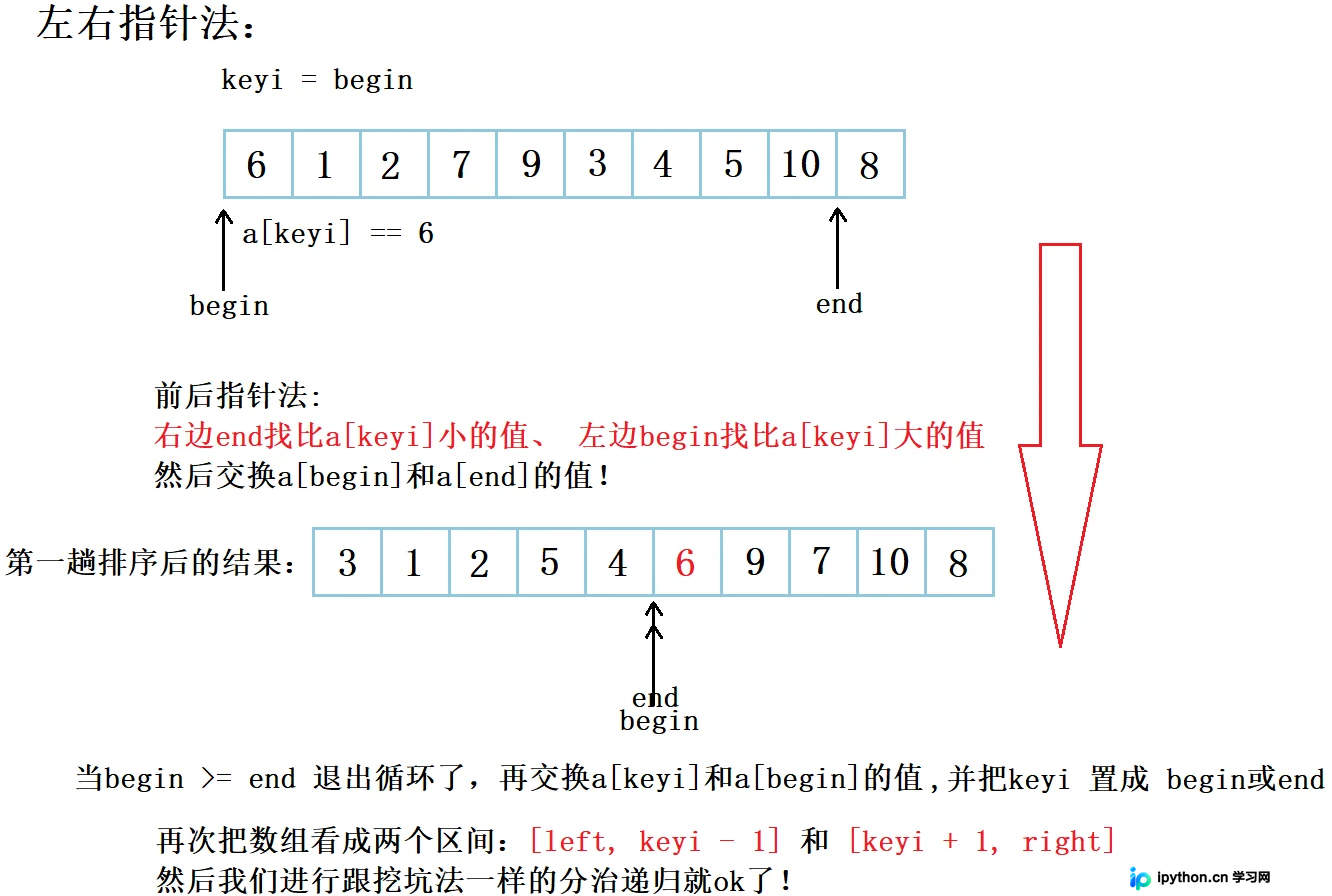
左右指针法使用两个指针 begin 和 end,分别指向区间的开头和结尾。 begin 向右找比基准大的数,end 向左找比基准小的数,找到后交换两者,直到两指针相遇。最后将基准值与相遇点的元素交换。
void QuickSort_LR(int* a, int left, int right)//升序
{
	if (left >= right)
	{
		return;
	}

	int begin = left;
	int end = right;
	int keyi = begin; // 记录基准值的初始索引

	while (begin < end)
	{
		// 右边先走,找小
		while (begin < end && a[end] >= a[keyi])
		{
			--end;
		}
		// 左边走,找大
		while (begin < end && a[begin] <= a[keyi])
		{
			++begin;
		}
		// 找到不符合条件的两个元素,交换
		Swap(&a[begin], &a[end]);
	}

	// 将基准值交换到正确位置
	Swap(&a[begin], &a[keyi]);
	keyi = begin; // 更新基准索引

	QuickSort_LR(a, left, keyi - 1);
	QuickSort_LR(a, keyi + 1, right);
}
第3步:前后指针法实现分区
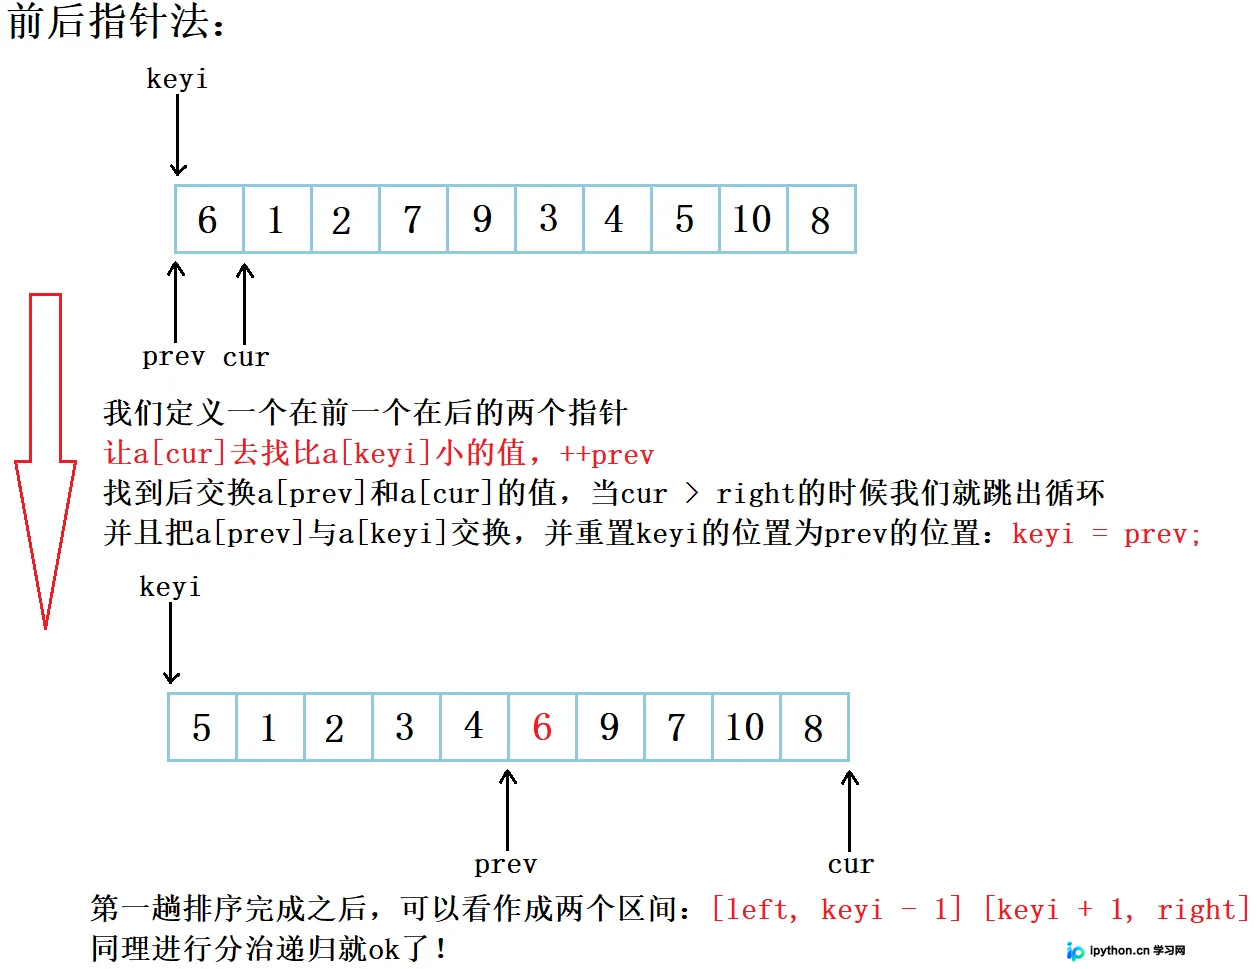
前后指针法使用 prev 和 cur 两个指针。cur 在前探索,prev 紧跟其后。如果 a[cur] 小于基准值,则 prev 前进并与 cur 交换。这样能保证 [left, prev] 区间内的元素都小于基准值。最终将基准值与 prev 位置的元素交换。
void QuickSort_FP(int* a, int left, int right)//升序
{
	if (left >= right)
	{
		return;
	}

	int keyi = left; // 基准值索引
	int prev = left;
	int cur = left + 1;

	while (cur <= right)
	{
        // 如果cur指向的元素小于基准值,且prev不等于cur
		if (a[cur] < a[keyi] && ++prev != cur)
		{
			Swap(&a[prev], &a[cur]);
		}
		++cur;
	}
	// 最后将基准值放到正确位置
	Swap(&a[keyi], &a[prev]);
	keyi = prev;

	QuickSort_FP(a, left, keyi - 1);
	QuickSort_FP(a, keyi + 1, right);
}
3. 归并排序(Merge Sort)
归并排序同样采用分治法,但与快排不同,它不通过比较移动来分区,而是通过递归分解到最小单元(单个元素视为有序),再合并有序子序列来构建最终结果。
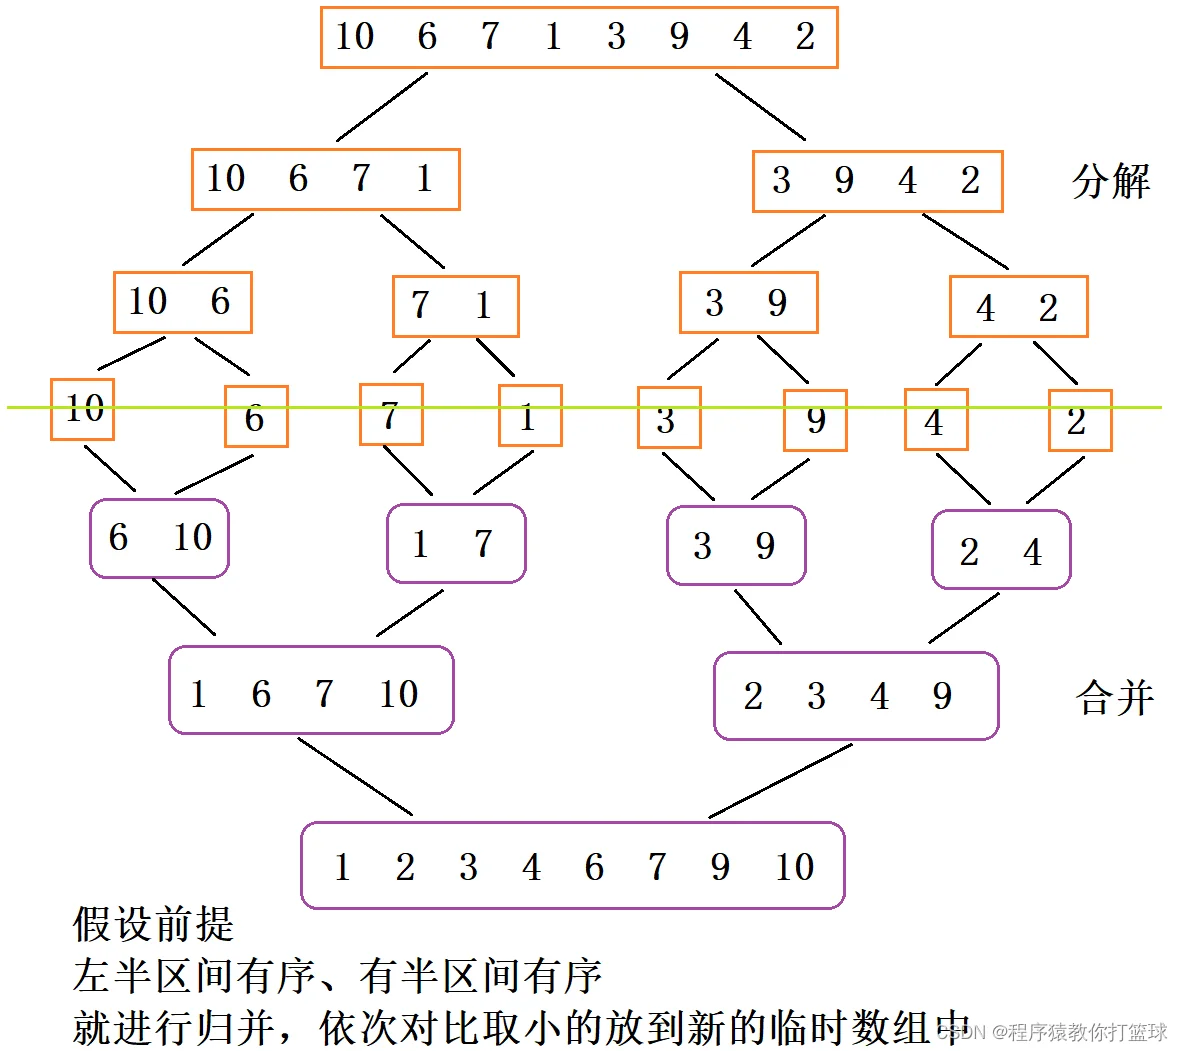
实现步骤
- 拆分:将数组从中间分开,递归地对左半部分和右半部分进行归并排序。
- 合并:创建临时数组,将两个已排序的子序列按顺序合并到临时数组中。
- 回填:将临时数组中的有序数据拷贝回原数组对应位置。
// 内部递归函数
void _MergeSort(int* a, int left, int right, int* tmp)
{
	if (left >= right)
		return;

	int mid = (left + right) >> 1; // 等价于 (left + right) / 2
	// 递归拆分左右区间
	_MergeSort(a, left, mid, tmp);
	_MergeSort(a, mid + 1, right, tmp);

	// 合并两个有序区间 [left, mid] 和 [mid+1, right]
	int begin1 = left, end1 = mid;
	int begin2 = mid + 1, end2 = right;
	int index = left;

	while (begin1 <= end1 && begin2 <= end2)
	{
		if (a[begin1] < a[begin2])
		{
			tmp[index++] = a[begin1++];
		}
		else
		{
			tmp[index++] = a[begin2++];
		}
	}

	// 处理剩余元素
	while (begin1 <= end1)
	{
		tmp[index++] = a[begin1++];
	}

	while (begin2 <= end2)
	{
		tmp[index++] = a[begin2++];
	}

	// 将合并后的数据拷贝回原数组
	for (int i = left; i <= right; ++i)
	{
		a[i] = tmp[i];
	}
}

// 外部接口
void MergeSort(int* a, int n)
{
	// 分配临时空间
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL) return; // 内存分配检查
	_MergeSort(a, 0, n - 1, tmp);

	free(tmp); // 释放内存
}
4. 排序算法复杂度及稳定性分析
在实际开发中,选择合适的排序算法需要权衡时间复杂度、空间复杂度和数据规模。以下是几种常见排序的综合对比:
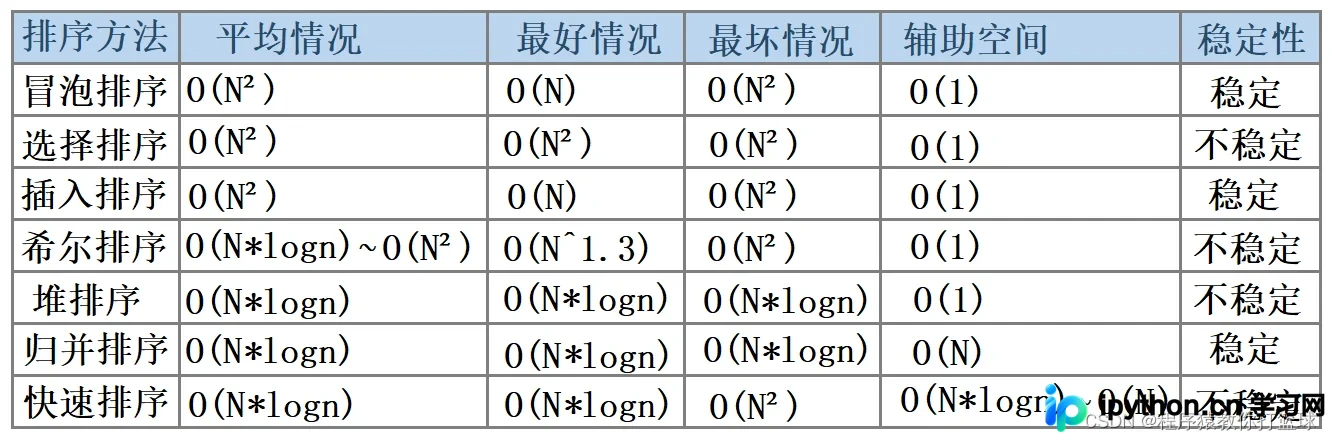
基本概念:稳定性
若待排序序列中存在两个相等的元素 r[i] 和 r[j](其中 i < j),排序后它们的相对位置保持不变(即 r[i] 仍在 r[j] 之前),则该排序算法是稳定的;否则是不稳定的。
综合对比总结
- 冒泡排序:时间
O(N^2),空间O(1),稳定。适用于小规模或基本有序数据。 - 快速排序:平均时间
O(N log N),最坏O(N^2),空间O(log N)(递归栈),不稳定。综合性能最优,应用最广。 - 归并排序:时间
O(N log N),空间O(N),稳定。适合链表排序或对外部大规模数据进行稳定排序。
以上就是C语言排序算法(冒泡、快速、归并)的详细解析,涵盖了代码实现与复杂度对比。更多关于C语言数据结构与算法的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















