


C语言整型提升与数据存储机制深度解析

发布时间:2026-10-16 |
4人浏览过
C语言中变量的数据在内存里并非以人们熟悉的十进制或符号形式直接存放,而是以二进制的补码形式存在。由于不同数据类型的位宽不同以及有符号和无符号的区别,赋值过程中的截断和输出时的整型提升经常导致出乎意料的运行结果。本文将结合具体代码示例,拆解整型提升规则及其引发的常见Bug。
整型提升核心原理
在进行表达式计算或函数参数传递时,C语言标准规定比 int 类型精度低的类型(如 char, short)会首先发生“整型提升”。提升的规则取决于源类型的符号性:
- 有符号整型提升:若原值是负数,高位补充符号位(1);若为正数,高位补充0。
- 无符号整型提升:高位始终补充0,原值作为正数处理。
理解这一机制是预测以下练习结果的关键前提。
第1步:基本类型赋值与打印练习
目的:观察相同赋值下,不同符号属性的 char 变量在经过整形提升后的差异。
int main()
{
	char a = -1;
	signed char b = -1;
	unsigned char c = -1;
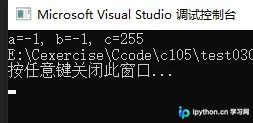
	printf("a=%d, b=%d, c=%d\n", a, b, c);
	return 0;
}
分析过程:
- a 和 b (signed char):
-1的二进制补码为全1。赋值给char时截断保留低8位11111111。打印时使用%d触发整形提升,因为是有符号负数,高位补1,结果仍为全1,即十进制-1。 - c (unsigned char):同样截断得到
11111111。但在整形提升时,因是无符号类型,高位补0,变为00000000 00000000 00000000 11111111,即十进制255。
第2步:边界值与格式符陷阱
目的:验证极小值在 %u 格式下的表现,考察补码视为无符号数的计算。
int main()
{
	char a = -128;
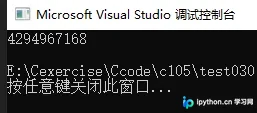
	printf("%u\n", a);
	return 0;
}
分析过程:
-128的8位补码为10000000。- 使用
%u打印时,先进行整形提升。由于char默认有符号且值为负,高位补1,得到32位全1前的11111111...10000000。 %u将该补码直接解释为正数,结果为 $2^{32} - 128$,即4294967168。
第3步:越界赋值的隐性转换
目的:当正整数超出 char 范围时,确认其截断后的符号状态。
int main()
{
	char a = 128;
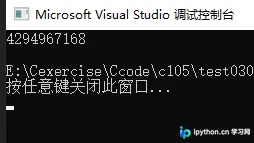
	printf("%u\n", a);
	return 0;
}
分析过程:
128的低8位二进制为10000000。赋值给char a后,该二进制序列被保存。- 对于有符号
char,最高位1被视为符号位,因此系统将其视为负数(-128)。 - 再次使用
%u打印时,经过整形提升(高位补1),最终显示为巨大的无符号整数4294967168,与上一题结果一致。
第4步:混合类型运算的自动提升
目的:观察正负数相加时,低位截断对结果的影响。
int main()
{
	int i = -20;
	unsigned int j = 10;
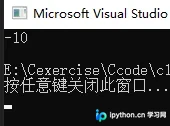
	printf("%d\n", i + j);
	return 0;
}
分析过程:
- -20 的补码末几位为
...11101100,10 的补码为...00001010。 - 两者相加,补码运算结果为
...11110110。 - 转换为原码即为
-10。此处展示了算术运算在底层遵循补码加法规律的特性。
第5步:无符号数的递减死循环
目的:识别无符号整数回绕(Wrap-around)导致的逻辑错误。
int main()
{
	unsigned int i = 0;
	for (i = 9; i >= 0; i--)
	{
		printf("%u\n", i);
	}
	return 0;
}
分析过程:
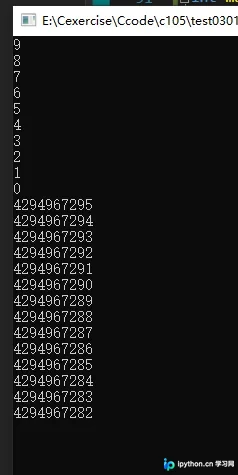
- 循环从 9 递减至 0,正常输出。
- 当 i 执行最后一步自减(0 -> -1)时,由于 i 是
unsigned int,负数会被转换为极大的正数($2^{32}-1$)。 - 极大正数依然满足
i >= 0的条件,导致无限循环。
第6步:数组遍历中的字符串终止符
目的:分析循环赋值过程中产生的空字符对 strlen 计数的影响。
int main()
{
	char a[1000];
	int i;
	for (i = 0; i < 1000; i++)
	{
		a[i] = -1 - i;
	}
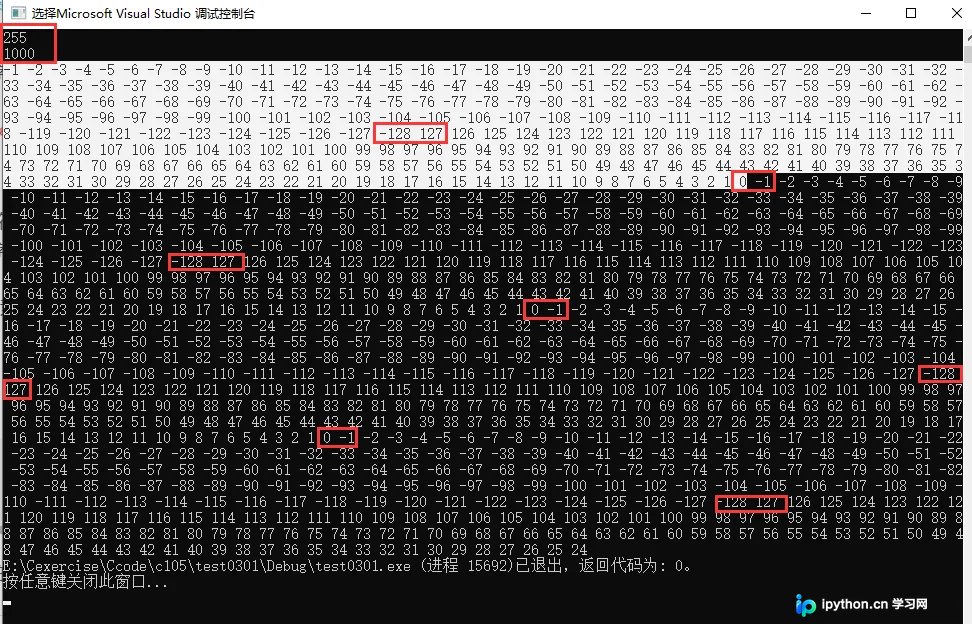
	printf("%d\n", strlen(a));
	printf("%d\n", sizeof(a));
	return 0;
}
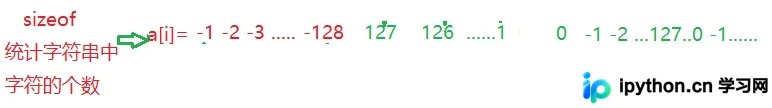
分析过程:
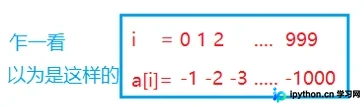
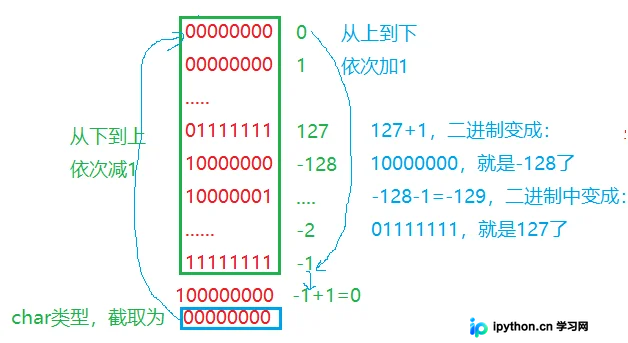
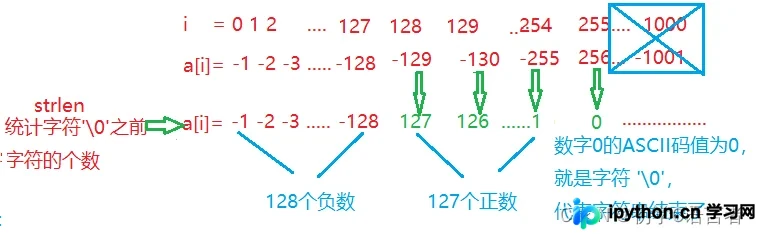
strlen寻找第一个'\0'(ASCII 0)。当 i=127 时,a[127] = -128。当 i=128 时,-129截断后变为127(01111111),随后 i=255 时,-256截断后恰好为0。- 因此,第 256 个元素(索引255)首次出现 0,
strlen返回255(不包含结束符本身的长度,或者说找到前255个有效字符)。 sizeof(a)测量的是静态分配的内存大小,始终为1000。
第7步:无符号 char 的范围陷阱
目的:利用 char 的类型特征制造隐蔽的死循环。
unsigned char i = 0;
int main()
{
	for (i = 0; i <= 255; i++)
	{
		printf("hello world\n");
	}
	return 0;
}
分析过程:
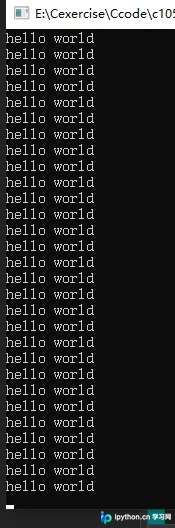
unsigned char范围为 0~255。循环正常执行至 i=255。- 最后一次自增,i 变为 256。但存储单元只有8位,截断保留低8位,
256的二进制100000000截断后剩00000000,即回到 0。 - i 永远无法大于 255,条件
i <= 255恒真,形成死循环。
总结
通过上述七个练习可以看出,C语言的数据存储不仅是简单的数值映射,更涉及复杂的补码运算、截断规则和整型提升机制。在处理嵌入式开发或系统级编程时,必须严格监控数据的类型范围,特别是涉及无符号计数器递减、数组越界访问以及混用有/无符号类型进行比较的场景,以避免难以察觉的逻辑错误。
以上就是C语言数据内存存储与整型提升原理的详细解析内容,更多关于C语言基础教程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















