


头文件include顺序不同导致C++编译报错的分析与解决

在使用C6000系列DSP进行C++开发时,由于头文件的包含(#include)顺序不同,可能导致同一份代码出现编译成功或失败的结果。本文深入分析了由NULL宏在不同头文件中定义差异引发的类型不匹配报错,并通过代码示例与原理剖析,给出消除这种隐式依赖的最佳实践。
问题表现
在进行TI C6455 DSP相关的新项目开发时,使用了较新的CGT编译器版本(如7.4.24)。工程中包含多个相互嵌套的头文件。在实际调试中发现,仅修改main.cpp中两个第三方库头文件的引入顺序,就会导致编译结果截然不同:
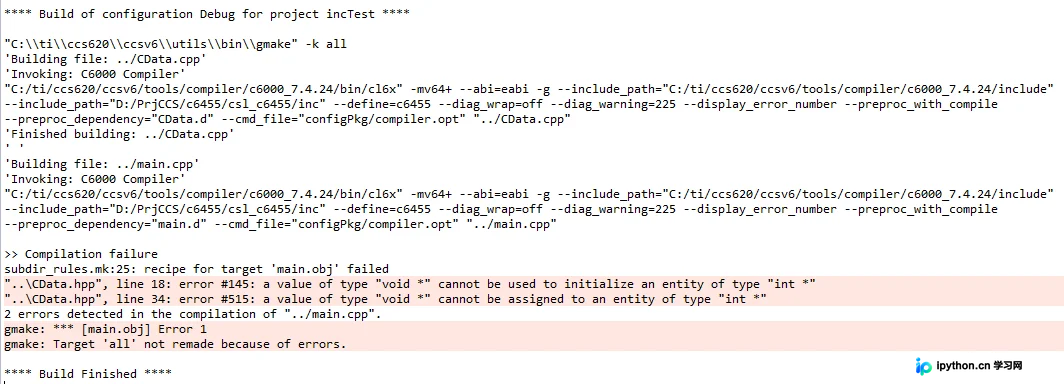
当引入顺序为:先引入 csl_types.h,再引入自定义的 CData.hpp 时,编译器报错:
// main.cpp 失败场景
#include "csl_types.h"
#include "CData.hpp"

int main(void) {
    return 0;
}
而在调整顺序后,将 CData.hpp 放在前面引入,则编译能够正常通过:
// main.cpp 成功场景
#include "CData.hpp"
#include "csl_types.h"

int main(void) {
    return 0;
}
简化复现与分析
为了定位问题,我们将复杂的工程结构简化为三个核心文件:main.cpp、CData.cpp 和 CData.hpp。其中 CData.hpp 定义了一个包含动态内存分配的类:
// CData.hpp
#ifndef CDATA_HPP_
#define CDATA_HPP_
#include <assert.h>
#include <stdlib.h>

class CData {
public:
    // 默认构造函数中使用 NULL 初始化指针
    CData() : m_pData(NULL), m_nCnt(0) {}
    CData(int nCnt) : m_nCnt(nCnt) {
        m_pData = new int[nCnt];
        assert(m_pData != NULL);
    }
    ~CData(){
        if(m_pData){
            delete[] m_pData;
            m_pData = NULL;
        }
    }
protected:
    int *m_pData;
    int m_nCnt;
};
#endif
在该场景下,如果按照“失败顺序”预编译 main.cpp,编译器给出的错误提示通常为:
a value of type "void *" cannot be used to initialize an entity of type "int *"
a value of type "void *" cannot be assigned to an entity of type "int *"
这表明编译器认为表达式中的 NULL 被展开为了 void * 类型的值,而类的成员变量 m_pData 是 int * 类型。在严格的C++模式下,隐式转换是被禁止的。
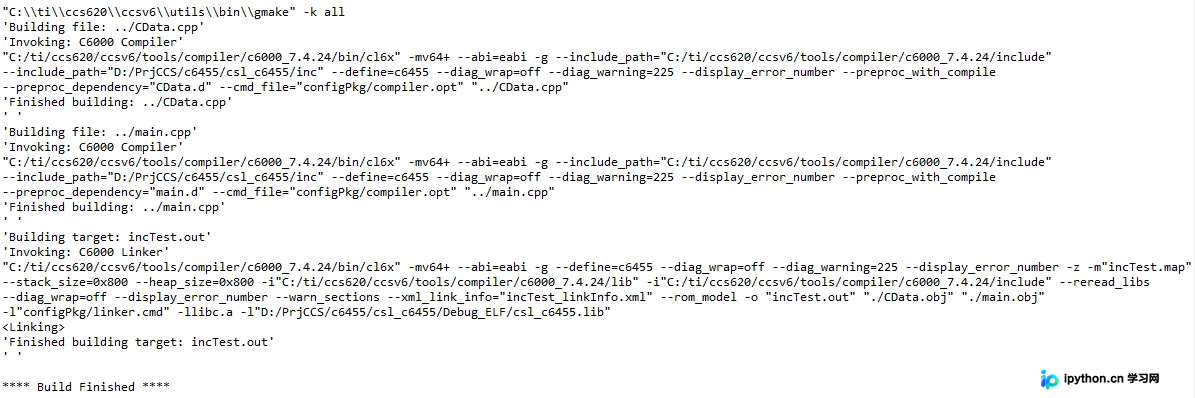
然而,单独检查 CData.cpp (它只包含了 CData.hpp)却不会报错,这证明了错误并非出在 CData.hpp 自身的逻辑上,而是其被 main.cpp 引入时的上下文环境发生了改变。
根源排查:NULL宏定义的冲突
C语言中标准头文件 <stdlib.h> 对 NULL 的传统定义通常是宏展开为 0:
// stdlib.h 典型定义
#ifndef NULL
#define NULL 0
#endif
但在部分特定平台的底层库(如TI CSL库的 csl_types.h)中,为了满足C语言的兼容性或特定的内部处理,可能会将 NULL 定义为 (void*)0:
// csl_types.h 典型定义
#ifndef NULL
#define NULL ((void*)0)
#endif
当 main.cpp 优先引入了 csl_types.h 时,NULL 被预处理器替换为 ((void*)0)。随后引入的 CData.hpp 中的构造函数使用 NULL 赋值给 int* 类型的指针,这就直接触发了上述的类型不匹配报错。
此外,在RTSC框架下使用的 xdc/std.h 有时会采取先 #undef NULL 再重新定义的策略,这在一定程度上能缓解此类冲突,但若不同库之间的头文件依然混用且未做充分隔离,隐患依然存在。
最佳实践:避免脆弱的头文件顺序
虽然调整 #include 的顺序可以暂时解决问题,但这属于典型的“防御性编程缺失”。在实际工程中,层层嵌套的头文件关系极难追踪,任何微小的顺序变动都可能导致不可预知的行为。
根本的解决之道在于良好的模块化设计习惯:
- 声明与实现分离:不要在头文件(
.hpp/.h)中编写具体的函数逻辑或使用了大量依赖具体环境的代码。应仅在头文件中放置类的声明(成员变量与方法签名)。 - 实现细节下沉:将需要包含复杂第三方头文件或可能引发宏冲突的具体实现代码移动到对应的源文件(
.cpp/.c)中。
通过将 CData.hpp 变为纯粹的接口定义,并将包含 csl_types.h 或其他敏感库的操作移至 CData.cpp,即可彻底切断外部引入顺序对该模块内部实现的干扰,提升代码的健壮性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















