


Go 语言正则表达式入门:从基础匹配到高级替换

Golang内置了强大的regexp包来处理文本模式匹配。文章详细讲解如何正确初始化正则对象以避免性能损耗,并演示FindAllString、Split及ReplaceAllString等核心方法在查找、分割和替换字符串中的实际用法。
正则表达式的性能考量
在Go语言中,正则表达式引擎遵循RE2语法(PCRE的子集),不支持回溯引用等复杂特性,这保证了极高的执行效率。regexp包提供了多种操作,包括过滤、修改、替换、验证和提取文本。
第1步:使用 MatchString 快速匹配
regexp.MatchString(pattern string, s string) 是最简单的使用方法,直接判断字符串是否符合模式。虽然方便,但每次调用都会重新编译正则表达式,因此在循环中使用会导致严重的性能问题。
package main
import (
	"fmt"
	"log"
	"regexp"
)
func main() {
	words := [...]string{"Seven", "even", "Maven", "Amen", "eleven"}
	for _, word := range words {
		found, err := regexp.MatchString(".even", word)
		if err != nil {
			log.Fatal(err)
		}
		if found {
			fmt.Printf("%s matches\n", word)
		} else {
			fmt.Printf("%s does not match\n", word)
		}
	}
}
运行该代码:
Seven matches
even does not match
Maven does not match
Amen does not match
eleven matches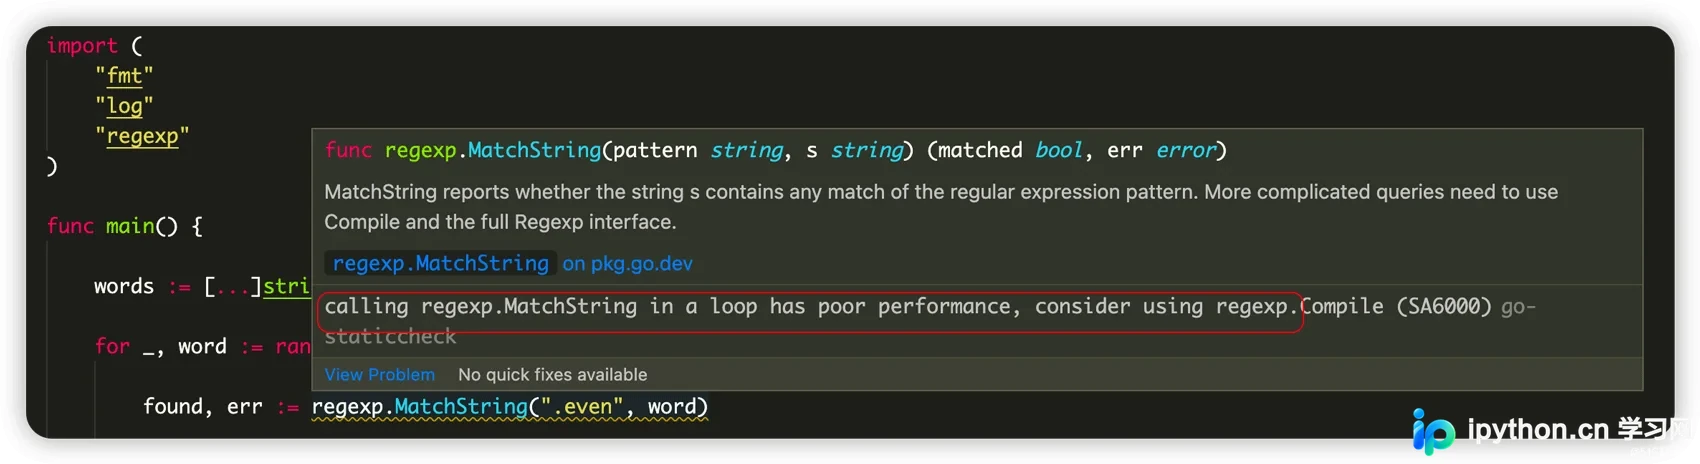
正如图片所示,编译器或静态分析工具通常会提示这种用法存在性能隐患。为了提高效率,应当使用 Compile 预先构建正則式对象。
第2步:使用 Compile 预编译优化
regexp.Compile 会解析并编译正则表达式,返回一个可复用的 *Regexp 对象。这对于需要在同一模式下多次匹配的场景至关重要。
re, err := regexp.Compile(".even")
if err != nil {
    log.Fatal(err)
}
// 之后可以在循环中安全且高效地调用 re.MatchString(word)
另一种便捷方式是 MustCompile,当正则表达式无效时它会自动触发 panic。这在确定表达式正确性(如程序启动阶段)后非常有用,可以省略错误处理的样板代码。
re := regexp.MustCompile(".even")
found := re.MatchString(word)
字符串的查找与提取
除了简单匹配,我们通常需要获取具体的子串位置和内容。
第3步:提取所有匹配的字符串
使用 FindAllString 可以返回所有匹配的子串切片。第二个参数指定最大匹配数,传入 -1 表示返回所有匹配项。
var content = `Foxes are omnivorous mammals...`
re := regexp.MustCompile("(?i)fox(es)?")
found := re.FindAllString(content, -1)
此处 (?i) 开启忽略大小写模式,(es)? 匹配零次或一次“es”。执行结果将包含文中所有的 Foxes 和 fox。
第4步:精准定位索引
如果需要知道匹配项在原字符串中的确切位置,应使用 FindAllStringIndex。它返回二维切片,每个元素包含起始和结束索引:
idx := re.FindAllStringIndex(content, -1)
for _, j := range idx {
    match := content[j[0]:j[1]]
    fmt.Printf("%s at %d:%d\n", match, j[0], j[1])
}
文本的分割与清洗
第5步:基于正则分隔符拆分数据
在处理非标准格式的字符串(如逗号后带有不规则空格)时,Split 比简单的字符串分割更有用。它将字符串按匹配的模式切分成若干部分:
re := regexp.MustCompile(",\s*")
vals := re.Split(data, -1) // 按“逗号+任意空白”切分
高级操作:分组与替换
第6步:利用捕获组解析结构化文本
圆括号用于创建捕获组。配合 FindStringSubmatch 可以将整个匹配串和各子组分别提取出来:
re := regexp.MustCompile("(\w+)\.(\w+)")
parts := re.FindStringSubmatch("webcode.me")
// parts[0] 是完整匹配,parts[1] 是第一组,parts[2] 是第二组
第7步:全局替换文本
去除 HTML 标签或格式化数据时,可以使用 ReplaceAllString。例如移除网页内容中的所有标签:
re := regexp.MustCompile("<[^>]*>")
cleanedContent := re.ReplaceAllString(htmlContent, "")
若需对匹配项应用自定义逻辑(如转换为大写),可使用回调函数风格的 ReplaceAllStringFunc:
re.ReplaceAllStringFunc(content, strings.ToUpper)
总结
正则表达式是 Go 语言处理文本不可或缺的工具。合理区分 MatchString 的一时之便和 Compile 的长期性能收益,灵活运用捕获组和替换函数,能极大提升开发者处理日志、配置和文本数据的效率。以上就是 Go 语言正则表达式入门学习的详细内容,更多关于 Go 正则表达式应用的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















