


C语言文件操作详解:顺序读写、随机定位与结束判定

本文详细讲解C语言中文件流的常用操作函数,包括文本字符与行的输入输出、格式化读写以及二进制块读写。重点演示如何使用fseek进行文件指针的随机定位,并纠正关于feof判断文件结束的常见误区,帮助开发者掌握安全、高效的文件处理技巧。
前言
C语言标准库(stdio.h)提供了丰富的函数来处理文本文件和二进制文件。本文将接续前篇内容,深入探讨各类顺序读写函数、随机定位机制以及正确的文件结束判定方法,覆盖从基础字符处理到高级块操作的完整流程。
文本流的顺序读写
文本流的处理主要分为按字符、按行和格式化三种粒度。理解它们的适用场景是高效编码的基础。
第1步:单字符的输入与输出
目的:实现对文件流中每一个独立字节的最小粒度读写,适用于逐字分析或加密等场景。
函数原型:
int fgetc(FILE *stream); // 返回读取的字符(整型),失败返回 EOF
int fputc(int c, FILE *stream); // 写入字符c,成功返回c,失败返回EOF关键参数:
- stream:指向FILE对象的指针。
- c:要写入的整数形式字符。
操作演示:写文件
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

int main() {
    FILE* pfWrite = fopen("test.txt", "w");
    if (pfWrite == NULL) {
        perror("打开文件失败");
        return 0;
    }
    // 连续写入三个字符 a, b, c
    fputc('a', pfWrite);
    fputc('b', pfWrite);
    fputc('c', pfWrite);

    fclose(pfWrite);
    pfWrite = NULL;
    return 0;
}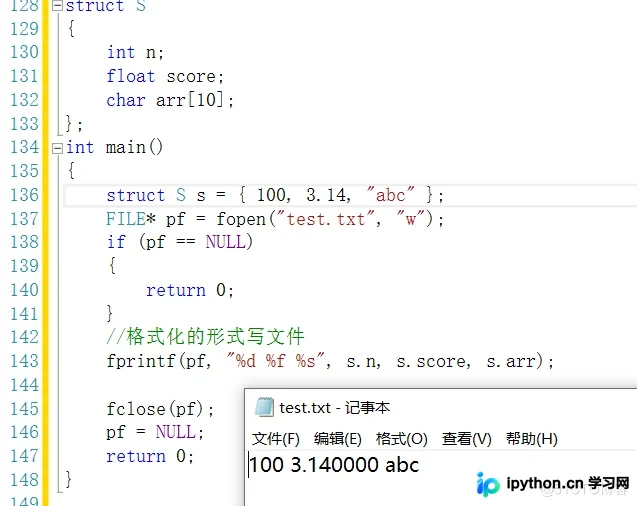
上图为 fprintf 示例代码截图,但此处展示的是单字符写操作的结果,文件内容为连续的 abc。
操作演示:读文件
int main() {
    FILE* pfRead = fopen("test.txt", "r");
    if (pfRead == NULL) {
        perror("打开文件失败");
        return 0;
    }
    // 逐个读取并打印
    int ch = fgetc(pfRead);
    while (ch != EOF) {
        putchar(ch); // 或者 printf("%c", ch);
        ch = fgetc(pfRead);
    }

    fclose(pfRead);
    pfRead = NULL;
    return 0;
}
注意:原文代码示例中直接连续调用三次 fgetc 属于硬编码特定文件长度的做法,实际开发中应结合 EOF 判断或使用循环。
第2步:按行(字符串)的输入与输出
目的:一次性读取或写入一个完整的文本行(以换行符结尾的字符序列),适合处理配置项或日志记录。
函数原型:
char *fgets(char *string, int n, FILE *stream);
int fputs(const char *string, FILE *stream); // 注:原文为fputs,非fges
fgets 核心逻辑:
从流中读取最多 n-1 个字符,并在末尾自动追加终止符 '\0'。如果读取过程中遇到换行符 '\n',该换行符会被保留在缓冲区中。
操作演示:用 fgets 读取一行
int main() {
    char buff[100] = { 0 };
    FILE* pf = fopen("test.txt", "r");
    if (pf == NULL) return 0;

    // 最多读取99个字符,剩余空间给 '\0'
    if(fgets(buff, 100, pf) != NULL) {
        printf("%s", buff); // 包含末尾的换行符
    }

    fclose(pf);
    pf = NULL;
    return 0;
}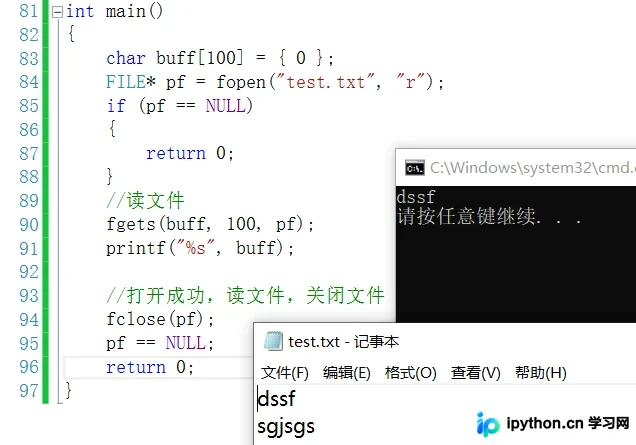
上图展示了从文件中读取一行数据并输出的效果,注意观察输出结果中是否保留了原有的换行格式。
操作演示:用 fputs 写一行
int main() {
    FILE* pf = fopen("demo.txt", "w");
    if (pf == NULL) return 0;

    // fputs 不会自动添加换行符,需手动插入 \n
    fputs("hello\n", pf);
    fputs("world\n", pf);

    fclose(pf);
    pf = NULL;
    return 0;
}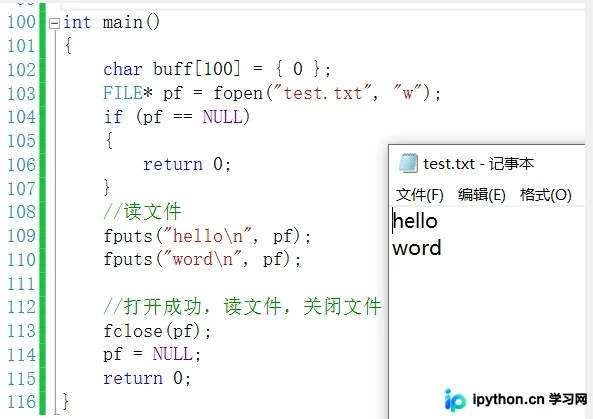
上图展示了使用 fputs 将多行文本写入文件后的磁盘保存情况,每行以明确的换行分隔。
控制台交互扩展
这两个函数同样可用于标准输入输出(stdin/stdout),常用于简易的控制台菜单交互。
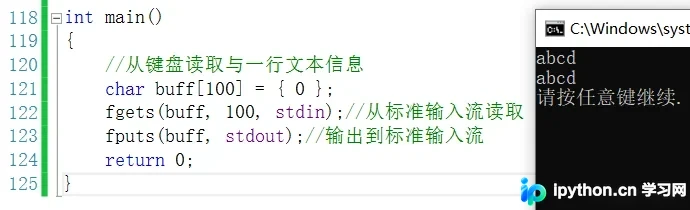
上图展示了键盘输入 abcd 回车后,屏幕完整打印出 abcd 的效果,验证了 fgets/fputs 对标准流的兼容性。
第3步:格式化数据的读写
目的:按照特定格式(如整数、浮点数、字符串组合)序列化或反序列化复杂结构体或变量。
对比关系:
- printf / scanf:针对标准输出/输入流(显示器/键盘)。
- fprintf / fscanf:针对所有文件流(FILE*)。
- sprintf / sscanf:针对内存中的字符串缓冲区(String Buffer)。
操作演示:fprintf 写入结构体数据
struct S {
    int n;
    float score;
    char arr[10];
};

int main() {
    struct S s = { 100, 3.14, "abc" };
    FILE* pf = fopen("data.txt", "w");
    if (pf == NULL) return 0;

    // 将结构化数据转为纯文本格式存储
    fprintf(pf, "%d %f %s", s.n, s.score, s.arr);

    fclose(pf);
    pf = NULL;
    return 0;
}注意:对于 fscanf 读取,需要传入变量的地址(&s.n 等),且通常用于读取上文 fprintf 生成的文本文件。
第4步:二进制块的读写
目的:直接复制内存块到文件,不进行任何字符转换。这是保存图片、音频、压缩文件或内存快照的最高效方式。
函数原型:
size_t fwrite(const void *buffer, size_t size, size_t count, FILE *stream);
size_t fread(void *buffer, size_t size, size_t count, FILE *stream); 参数说明:
- buffer:数据首地址。
- size:每个元素的大小(字节)。
- count:元素个数。
即总字节数 = size * count。
操作演示:二进制写结构体
struct Student {
    char name[20];
    int age;
    double score;
};

int main() {
    struct Student stu = { "张三", 20, 55.6 };
    // 必须使用 wb/wb+ 模式开启二进制写入
    FILE* pf = fopen("binary.dat", "wb");
    if (pf == NULL) return 0;

    // 将一个 Student 对象的原生内存写入文件
    fwrite(&stu, sizeof(struct Student), 1, pf);

    fclose(pf);
    pf = NULL;
    return 0;
}读回方法:
对应的 fread 用法类似。读取时,建议检查返回值是否等于请求的元素个数(count),以确认数据完整性。
文件的随机读写
上述操作均为“顺序读写”,指针随读写位置自动后移。若需要从文件中间某处开始读取,或跳转至末尾追加数据,需要使用定位函数。
第5步:使用 fseek 定位指针
目的:改变当前文件指针的位置,基于起始点、当前位置或文件末尾进行相对移动。
函数原型:
int fseek(FILE *stream, long offset, int origin); 偏移常量:
SEEK_SET:文件开头(Offset 可为正或负)。SEEK_CUR:文件当前位置(Offset 可为正或负,用于前后微调)。SEEK_END:文件末尾(Offset 通常为0用于获取文件大小,负数用于从末尾向前跳)。
操作演示:从当前位置向后偏移
int main() {
    FILE* pf = fopen("test.txt", "r");
    if (pf == NULL) return 0;

    // 假设文件内容是 "abced..."
    // 当前指针默认在开头 'a' 处
    fseek(pf, 2, SEEK_CUR); // 跳过当前位置及其前1个字节,总共向右移动2位,指向 'c'

    int ch = fgetc(pf);
    printf("%c\n", ch); // 预期输出 'c'

    fclose(pf);
    pf = NULL;
    return 0;
}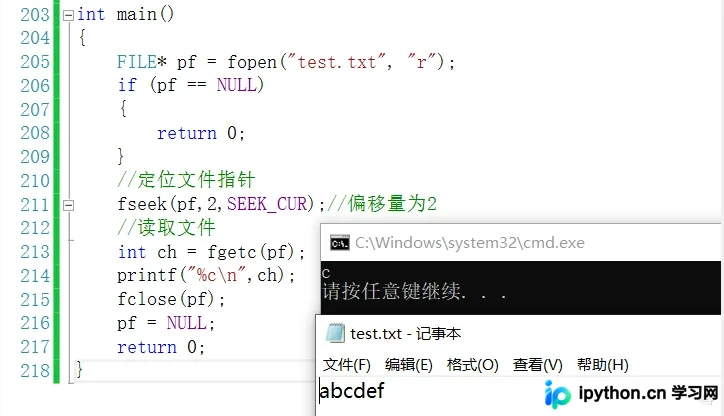
上图展示了 fseek 执行后的指针位置变化示意,直观呈现了偏移量如何影响后续读取的数据起点。
补充工具:ftell 与 rewind
虽然草稿未详述,但常与 fseek 配合使用的还有:
- long ftell(FILE *stream):获取当前文件指针距离文件开头的字节数(常用于计算文件大小)。
- void rewind(FILE *stream):将指针重置到文件开头。
文件结束的判定(避坑指南)
很多初学者误用 feof() 来作为循环退出的条件,这往往导致最后一次无效数据的重复处理或死循环。
为什么不能用 feof 判断循环?
原理:
当程序读取文件最后一个有效字符后,文件指针移动到文件尾标记之前。此时 feof() 仍返回假(0)。只有当程序试图在文件尾标记之后再次尝试读取失败时,内部错误标志才会被设置,feof() 才返回真。
正确的结束判定策略
- 文本文件(字符流):
-fgetc:判断返回值是否为EOF。
-fgets:判断返回值是否为NULL。 - 二进制文件(块流):
-fread:判断返回值是否小于请求的元素个数(例如fread(..., 1, size, stream) != size)。
应用场景:
feof 真正的用途是区分“正常读完”还是“读取出错”。例如:if (feof(stream)) ... else ...
总结
本文梳理了 C 语言文件操作的核心体系。掌握单字符与行的区别能避免内存溢出;格式化 IO 提升了数据可读性,而二进制块读写则保证了性能与保真度。配合 fseek 的定位能力,即可应对绝大多数复杂的文件解析需求。同时,切记依据具体的读取函数(fgets/fread/fgetc)来判断结束状态,而非依赖 feof。
以上就是C语言文件操作详解的详细内容,更多关于C语言文件读写技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















