


C语言数据结构:希尔排序(Shell Sort)详解与实现

希尔排序是插入排序的高效改进版本,通过在较大范围内移动元素来减少逆序对,使数据趋于基本有序,从而大幅提升排序效率。
插入排序回顾
希尔排序建立在直接插入排序的基础之上。要深入理解希尔排序,首先需要明确直接插入排序在什么情况下表现最优。
第1步:理解插入排序的执行逻辑
直接插入排序的核心思想是将一个记录插入到已经排好序的有序表中。假设我们要将数组 {5, 4, 3, 2, 1} 升序排列:
- 第一趟:从第二个元素开始,让前两个元素
5, 4变为升序(交换后为4, 5)。 - 第二趟:处理第三个元素,让前三个元素
4, 5, 3变为升序(结果为3, 4, 5)。 - 后续步骤依次类推,直到整个数组有序。
在这种最坏情况(逆序输入)下,每个新元素都需要与前面所有已排序元素比较并移动,整体时间复杂度为 $O(N^2)$。
第2步:掌握单趟排序的关键动作
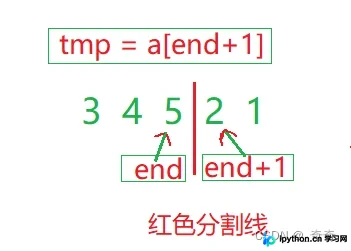
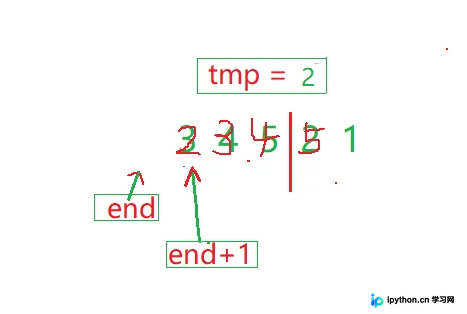
以 {3, 4, 5, 2, 1} 为例,当轮到元素 2 插入时:
- 定义指针
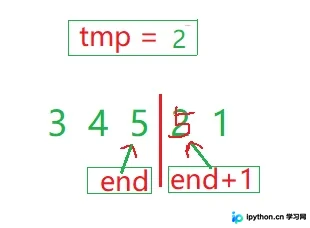
end指向有序部分的最后一个元素(即5),同时用变量tmp保存待插入值2。 - 打擂台比较:如果
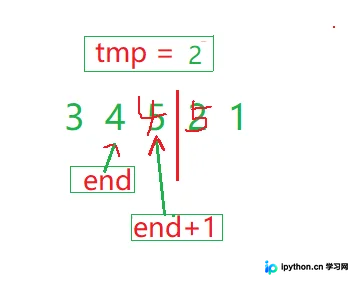
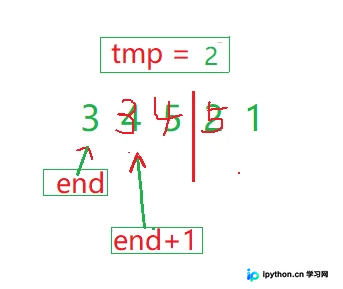
tmp < a[end],说明a[end]需要后移一位,即a[end+1] = a[end],然后end--。 - 重复上述过程,直到找到比
tmp小的位置或越界,最后将tmp存入a[end+1]。
这一过程的图解如下:
第3步:插入排序的代码实现
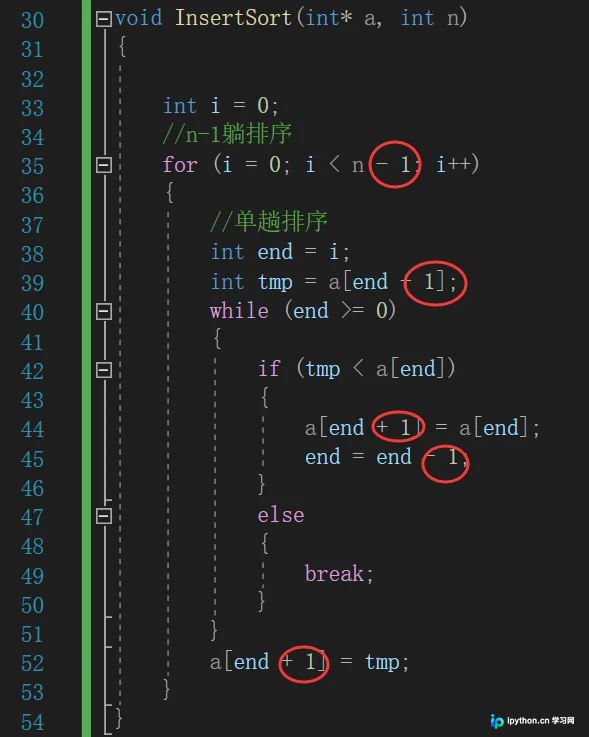
以下是标准的直接插入排序 C 语言代码,核心在于外层控制趟数,内层 while 循环负责查找插入位置:
#include <stdio.h>
void InsertSort(int* a, int n)
{
	for (int i = 0; i < n - 1; i++)
	{
		int end = i;
		int tmp = a[end + 1];
		while (end >= 0)
		{
			if (tmp < a[end])
			{
				a[end + 1] = a[end];
				end--;
			}
			else
			{
				break;
			}
		}
		a[end + 1] = tmp;
	}
}
int main()
{
	int arr[] = { 5,4,3,2,1 };
	int sz = sizeof(arr) / sizeof(arr[0]);
	InsertSort(arr, sz);
	return 0;
}
希尔排序的原理与优化
既然插入排序在数据接近有序时非常高效,那么如何让乱序数据变“接近有序”呢?这就是希尔排序的思路。
第4步:设定分组与增量(gap)
希尔排序通过选取一个间隔 gap,将数组分成若干子序列进行“预排序”。通常策略是让 gap = gap / 2,直到 gap == 1。
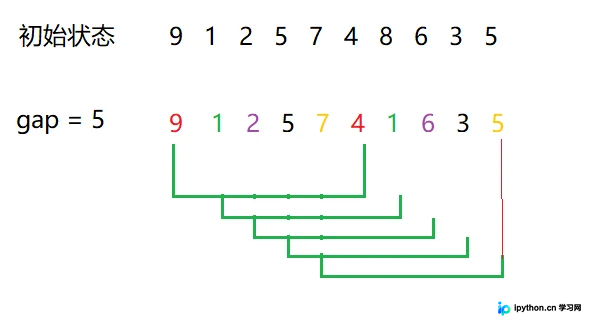
图解示例(gap=5):对于数组 {9, 8, 7, 6, 5, 4, 3, 2, 1}:
- 索引 0 和 5 为一组(值 9 和 4),排序后变为
{4, ... 9}。 - 索引 1 和 6 为一组(值 8 和 3),排序后变为
{..., 3, ..., 8}。 - 以此类推,经过 gap=5 的遍历后,大数被迅速移到后面,小数被迅速移到前面。
第5步:缩小增量进行预排序
接着将增量减半(例如 gap=2),再次进行组内排序,进一步消除小范围内的逆序:
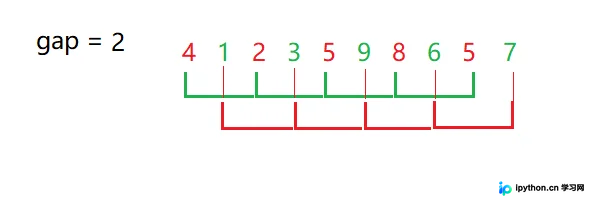
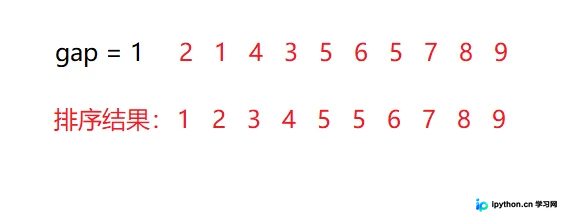
最后一步必须是 gap=1,此时数组实际上已经非常接近有序,再进行普通的插入排序,只需要极少的移动操作即可完成最终排序。
第6步:编写完整的希尔排序代码
希尔排序的逻辑是在插入排序的基础上套了一个循环来控制 gap。注意在内层移动元素时,偏移量必须使用 gap 而非固定为 1。
#include <stdio.h>
// 希尔排序
void ShellSort(int* a, int n)
{
	int gap = n;
	// 当 gap > 1 时进行预排序
	while (gap > 1)
	{
		gap = gap / 2;

		// 对当前 gap 下的各组进行插入排序
		for (int i = 0; i < n - gap; i++)
		{
			int end = i;
			int tmp = a[end + gap];

			// 组内插入排序逻辑
			while (end >= 0)
			{
				if (tmp < a[end])
				{
					a[end + gap] = a[end];
					end -= gap;
				}
				else
				{
					break;
				}
			}
			a[end + gap] = tmp;
		}
	}
}
int main()
{
	int arr[] = { 9,8,7,6,5,4,3,2,1 };
	int sz = sizeof(arr) / sizeof(arr[0]);
	ShellSort(arr, sz);
	return 0;
}
算法性能总结
希尔排序的时间复杂度依赖于所选的增量序列。使用上述简单的折半增量法,其时间复杂度约为 $O(N^{1.3})$ 至 $O(N^{1.5})$ 之间,优于普通插入排序的 $O(N^2)$。由于只需常数级辅助空间,其空间复杂度为 $O(1)$,但它是一种不稳定排序算法。
以上就是C语言希尔排序算法实现植物大战示例的详细内容,更多关于C语言希尔排序的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















