


MySQL 性能优化必备:EXPLAIN、SHOW INDEX 与 ANALYZE TABLE 详解

在进行 MySQL 数据库开发与优化时,理解查询如何执行是解决性能问题的关键。通过 EXPLAIN、SHOW INDEX 和 ANALYZE TABLE 等语句,可以直观地看到索引的使用情况、数据扫描范围以及临时表的创建与否。本文将深入解析这些核心工具的返回值含义、计算规则及实际操作场景,帮助开发者快速定位慢查询根因。
利用 EXPLAIN 分析查询执行计划
第1步:准备测试数据表结构
在进行索引分析前,首先需要一个包含常见字段类型的测试表。以下建表语句包含了主键、自增ID、枚举、定长变长字符串及小数类型,模拟了实际业务中的复杂场景:
CREATE TABLE `my_user` (idint(11) unsigned NOT NULL AUTO_INCREMENT,namevarchar(20) NOT NULL DEFAULT '' COMMENT '名字',sexenum('0','1') NOT NULL COMMENT '性别',tag_idsvarchar(255) NOT NULL COMMENT '标签',scoredecimal(5,2) NOT NULL DEFAULT '0.00' COMMENT '分数',class_rometinyint(2) NOT NULL DEFAULT '0' COMMENT '班级号', PRIMARY KEY (id), KEYscore(score) USING BTREE COMMENT '分数索引', KEYclass_rome(class_rome) USING BTREE COMMENT '班级索引' ) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8;
第2步:使用 EXPLAIN 查看基础执行结果
通过在 SQL 语句前加上 EXPLAIN 关键字,MySQL 会在不执行查询的情况下返回执行计划。例如查询分数为 10 的用户:
EXPLAIN SELECT * FROM my_user WHERE score =10;
观察返回结果的核心列(如图示):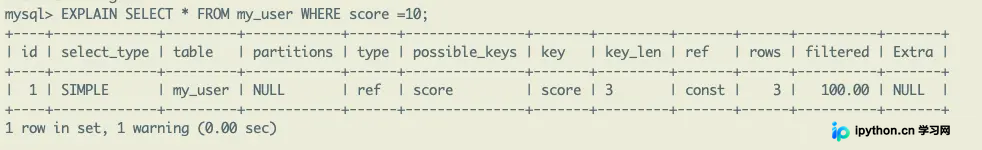
以下是 EXPLAIN 输出字段的详细释义及判断依据:
| 列名 | 说明与判断标准 |
|---|---|
id |
Select 序列号。id 越大优先级越高;id 相同时从上到下顺序执行。用于区分简单查询与包含子查询、Union 的复杂查询。 |
select_type |
标识查询类型:SIMPLE:简单查询。PRIMARY:最外层查询。SUBQUERY:子查询中的 select。DERIVED:派生表(from 中的子查询),结果存在临时表中。UNION / UNION RESULT:涉及 Union 操作时的标识。 |
table |
当前行正在访问的表名。若出现 <derivenN> 表示依赖 id=N 的查询先执行;Union 结果表现为 <union1,2>。 |
type |
访问类型,反映性能优劣,由好到差依次为:system/const:常量级访问,极快。eq_ref:唯一索引或主键连接。ref:非唯一索引查找,可能返回多行。range:范围扫描(如 >, <, between)。index:全索引扫描。ALL:**全表扫描**,通常需要通过添加索引进行优化。 |
possible_keys |
MySQL 认为可以使用到的索引列表。若为 NULL,则没有可用索引。注意:此处有索引不代表最终会使用。 |
key |
实际使用的索引。若为 NULL 且无索引可利用,需考虑是否增加索引或使用 force index。 |
key_len |
使用的索引字节长度。可用于推算实际使用了索引中的哪些列(仅左前缀部分)。 |
rows |
预估扫描行数,仅供参考,并非准确的结果集行数。 |
extra |
额外重要信息:Using index:**覆盖索引**,只需查索引树无需回表,高性能。Using where:存储引擎过滤,先读全行再过滤条件,性能一般。Using temporary:使用了临时表处理(如 distinct/group by),建议优化。Using filesort:文件排序,未使用索引排序,通常意味着需要进行索引优化。 |
第3步:关键指标实战案例对照
1. Using index(覆盖索引)示例:
当查询列均包含在索引中时,MySQL 不需要读取磁盘上的完整行数据。如下例仅查询索引列 score: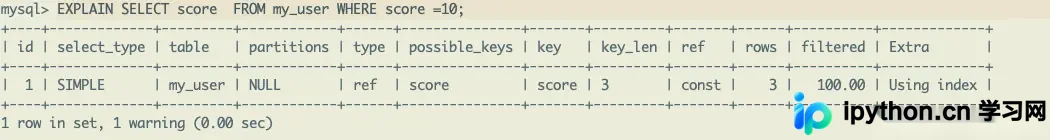
2. Using where(回表查询)示例:
查询所有列,必须通过聚簇索引回表获取数据,再进行条件过滤。如:WHERE score > 10 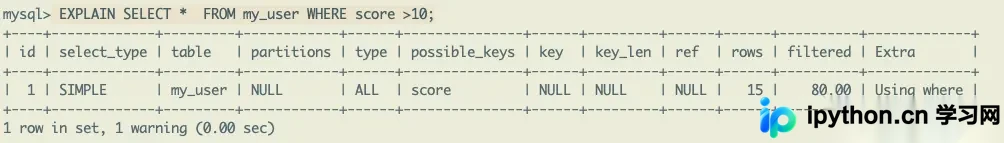
3. Using temporary(临时表)示例:
对非索引列进行去重操作时产生。如:DISTINCT name 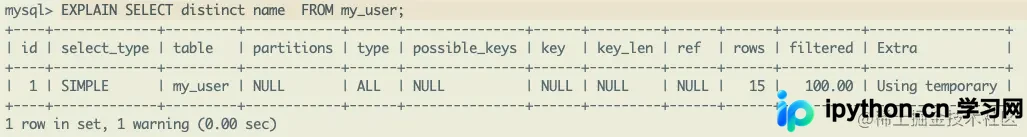
4. Using filesort(文件排序)示例:
虽然按索引列排序看似高效,但如果排序方向或逻辑导致无法直接利用有序性,仍会触发文件排序(实为内存或磁盘的快速排序)。如:ORDER BY score 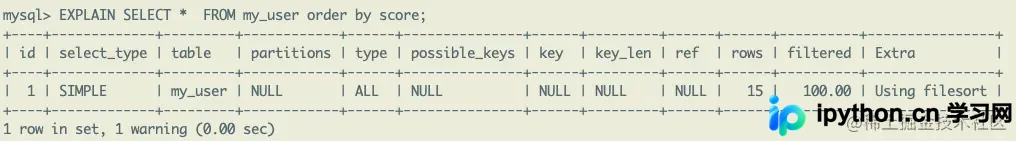
第4步:掌握 key_len 的计算规则
key_len 的大小直接反映了索引的使用效率。根据字段类型不同,其占用字节数规则如下:
| 数据类型 | 字节长度规则 |
|---|---|
char(n) |
n 字节 |
varchar(n) |
字符集 utf8 下为 3n + 2(+2用于存储字符串长度) |
tinyint/smallint/int/bigint |
分别占 1, 2, 4, 8 字节 |
date |
3 字节 |
timestamp/datetime |
分别占 4, 8 字节 |
decimal(m,n) |
占用空间为 (m/2 截断) + 1 字节。例如 decimal(5,2),占用 (2)+1 = 3 字节。 |
允许NULL |
每个可为 NULL 的列会增加 1 字节的空值标志位 |
查看索引详情:SHOW INDEX
当需要深入了解表中已有哪些索引及其分布情况时,使用 SHOW INDEX。语法支持指定库名与表名:
SHOW INDEX FROM<表名>[FROM<数据库名>] -- 或者
SHOW INDEX FROM<数据库名>.<表名>
执行示例: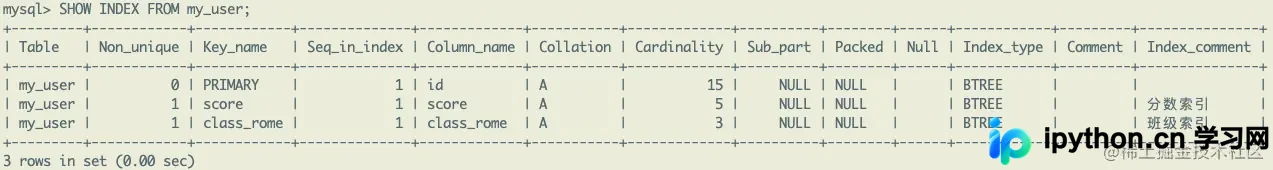
该语句返回字段较多,重点关注以下指标以评估索引有效性:
Non_unique:0 表示唯一索引(含主键),1 表示普通索引。Key_name:索引名称。主键始终为PRIMARY。Seq_in_index:列在索引中的序号(从 1 开始),用于复合索引判断前缀。Cardinality:**索引基数**(唯一值数量估算)。基数越高,选择性越好,优化器越倾向于使用该索引。若发现执行计划未选索引,可尝试运行ANALYZE TABLE更新此数据。Sub_part:若只索引了列的前缀,此处显示字符数(非二进制类型)或字节数(二进制类型)。Index_type:索引实现方式,常见为BTREE。
更新统计信息:ANALYZE TABLE
MySQL 优化器依赖统计信息进行成本计算。如果表数据变动较大,统计信息可能滞后,导致优化器选择了错误的索引。此时应使用 ANALYZE TABLE 刷新统计信息。
语法:
ANALYZE [NO_WRITE_TO_BINLOG | LOCAL] TABLE <表名>; 注意事项:
- 支持 InnoDB, NDB 和 MyISAM 表,不支持视图。
- 默认写入二进制日志,若不想影响主从复制日志,请使用
NO_WRITE_TO_BINLOG或LOCAL参数。
执行结果反馈示例: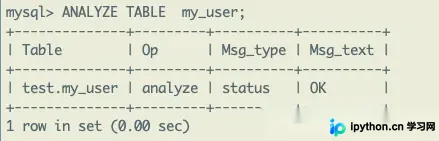
当连接查询未得到正确优化时,执行 ANALYZE TABLE 通常是第一步排查手段。若依然不理想,可考虑使用 FORCE INDEX 强制指定,或调整系统变量 max_seeks_for_key。
以上就是 MySQL 性能调优中核心的 SQL 语句整理与原理详解,更多关于数据库优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















