


C语言实现归并排序:原理、步骤与代码解析

归并排序是建立在归并操作上的一种高效排序算法,核心思想是分治法。本文将深入解析C语言中归并排序的工作原理,通过实例展示数据拆分与合并过程,并提供完整的递归与非递归实现代码,帮助用户掌握这一稳定且高效的排序算法。
归并排序的核心原理
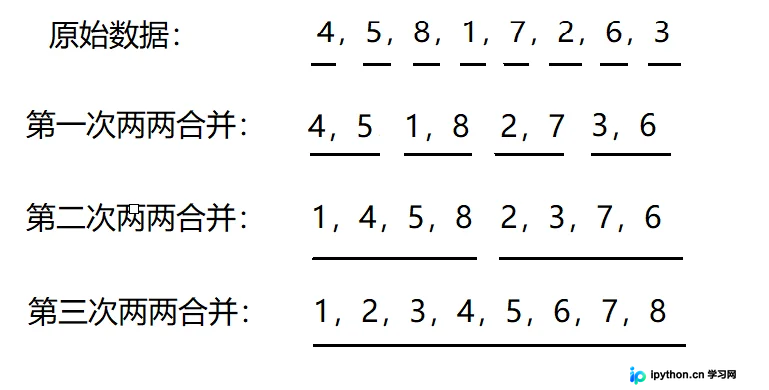
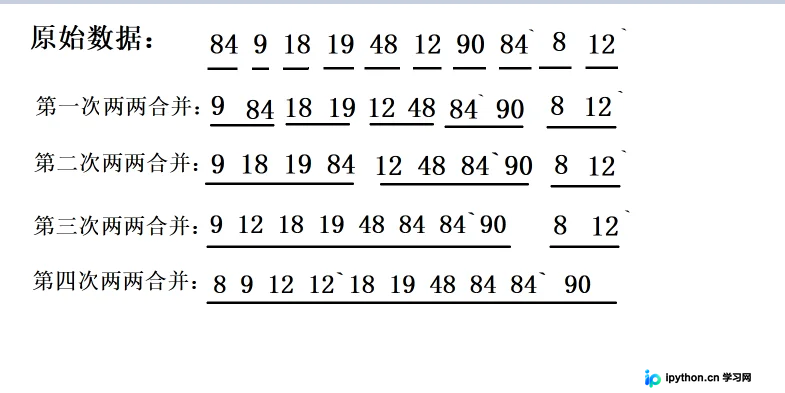
归并排序(Merge Sort)利用“分而治之”的思想。其基本操作是将两个或两个以上的有序序列组合成一个新的有序序列。对于长度为 n 的无序序列,算法首先将其看作 n 个长度为 1 的有序子序列,然后两两归并,得到 n/2 个长度为 2 或 1 的有序子序列;重复此过程,直到最终得到一个长度为 n 的有序序列。
这种算法的时间复杂度在任何情况下(最好、最坏、平均)均保持为 O(n log n),且具有稳定性,但在合并过程中需要额外的 O(n) 空间辅助。
第1步:理解拆分的视觉化过程
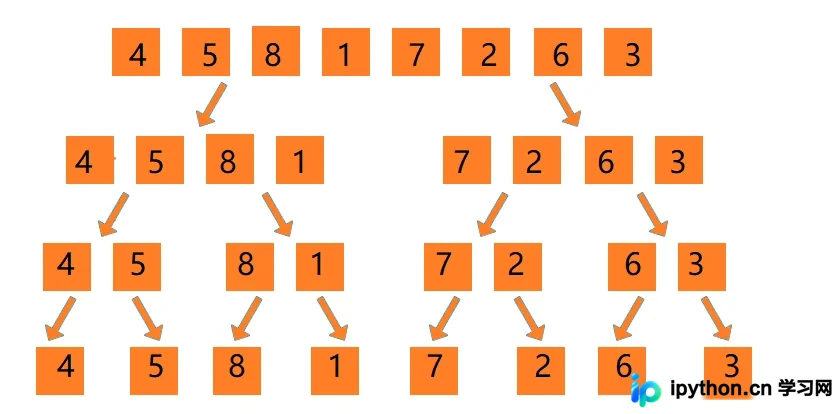
以序列 [4, 5, 8, 1, 7, 2, 6, 3] 为例,归并排序的第一步是不断将数组对半分割:
初始数组被递归地一分为二,直到每个子数组仅包含一个元素。此时,每个单元素序列在数学上被视为已排序状态。
这一过程直观展示了从无序整体到有序单元的拆解路径,是后续合并操作的基础。
第2步:掌握两两合并的逻辑
拆分完成后,算法从底层开始向上合并。合并两个有序子序列的核心规则如下:
- 创建目标数组:新建一个临时数组,长度等于参与合并的两个子数组长度之和。
- 双指针比较:设置指针 A 指向第一个子数组首部,指针 B 指向第二个子数组首部,指针 C 指向目标数组首部。
- 选择较小值:比较
arr[A]和arr[B],将较小者放入arr[C],并将对应指针右移一位。 - 处理剩余元素:若某一子数组元素遍历完毕,将另一子数组剩余元素直接复制到目标数组末尾。
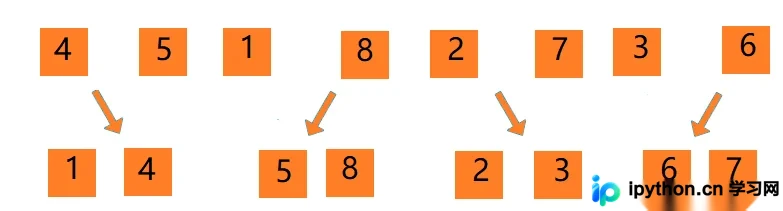
以下是前两层合并的具体演示:
第一层合并:[4] 与 [5] 合并为 [4, 5];[8] 与 [1] 合并为 [1, 8],依此类推。
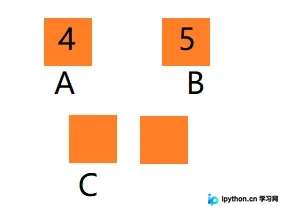
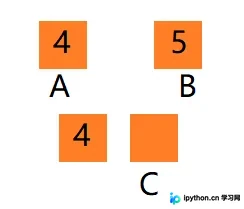
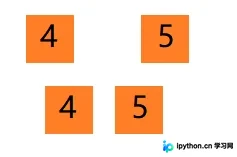
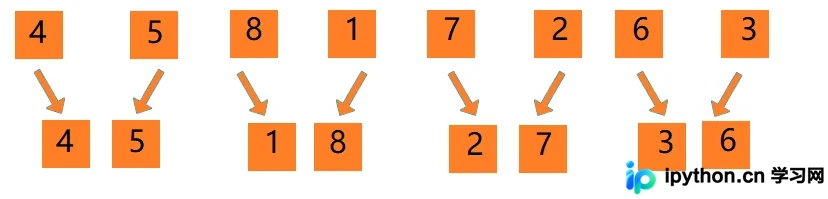
第二层合并:将上一轮得到的有序对进行合并。例如 [4, 5] 与 [1, 8] 合并:
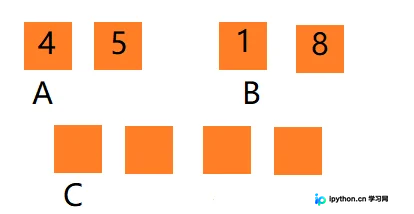
比较 4 和 1,1 较小,放入目标位。
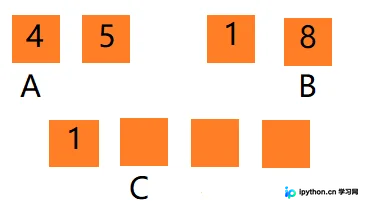
比较 4 和 8,4 较小,放入目标位。
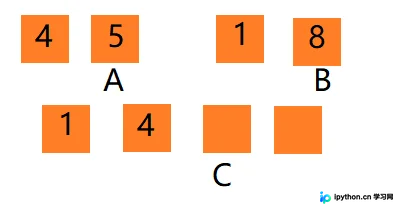
比较 5 和 8,5 较小,放入目标位。
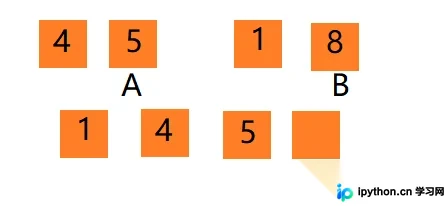
左侧子数组耗尽,右侧剩余元素 8 依次填入。
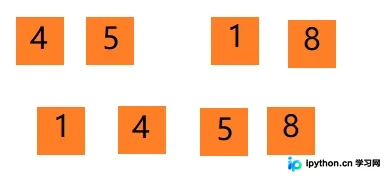
同理,[7, 2] 与 [6, 3] 合并为 [2, 3, 6, 7]。
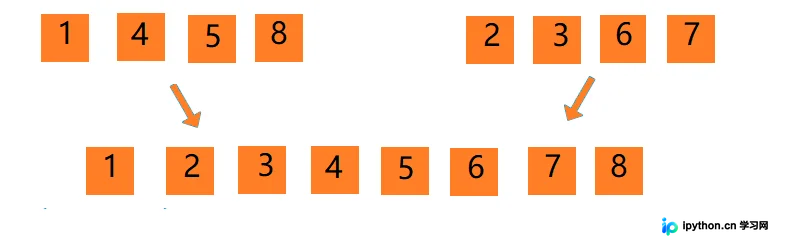
最后一层:将 [4, 5, 8, 1] 与 [7, 2, 6, 3](注意:此处应为中间结果示例,实际流程是上半部分与下半部分合并)的最终有序子序列合并,得到最终完整排序结果。
C语言代码实现
归并排序通常有两种实现方式:自顶向下的递归实现(Top-Down)和自底向上的迭代实现(Bottom-Up)。原文中提供的代码存在函数名与逻辑不符的问题(如标题为 MergeSort 但内部实现了快速排序的 Partition),以下给出标准正确的 C 语言实现。
第1步:编写递归版本(推荐)
递归版本逻辑清晰,符合“先拆分再合并”的思维模型。
#include <stdio.h>
#include <stdlib.h>

// 合并两个有序子数组:arr[left..mid] 和 arr[mid+1..right]
void merge(int arr[], int left, int mid, int right) {
    int n1 = mid - left + 1;
    int n2 = right - mid;

    // 创建临时数组
    int *L = malloc(n1 * sizeof(int));
    int *R = malloc(n2 * sizeof(int));

    if (!L || !R) return; // 内存分配失败检查

    // 复制数据到临时数组
    for (int i = 0; i < n1; i++)
        L[i] = arr[left + i];
    for (int j = 0; j < n2; j++)
        R[j] = arr[mid + 1 + j];

    // 合并临时数组回到 arr[left..right]
    int i = 0, j = 0, k = left;
    while (i < n1 && j < n2) {
        if (L[i] <= R[j]) {
            arr[k++] = L[i++];
        } else {
            arr[k++] = R[j++];
        }
    }

    // 复制剩余元素
    while (i < n1)
        arr[k++] = L[i++];
    while (j < n2)
        arr[k++] = R[j++];

    free(L);
    free(R);
}

// 递归主函数
void mergeSortRecursive(int arr[], int left, int right) {
    if (left < right) {
        int mid = left + (right - left) / 2;

        // 排序左半部分
        mergeSortRecursive(arr, left, mid);
        // 排序右半部分
        mergeSortRecursive(arr, mid + 1, right);
        // 合并两个半部分
        merge(arr, left, mid, right);
    }
}
第2步:编写迭代版本(自底向上)
迭代版本避免了递归调用栈的开销,适合对栈空间敏感的环境。它通过不断增加步长 size 来进行两两合并。
void mergeSortIterative(int arr[], int n) {
    int *aux = malloc(n * sizeof(int));
    if (!aux) return;

    for (int size = 1; size < n; size *= 2) { // size 为当前合并的子数组长度
        for (int left = 0; left < n - size; left += 2 * size) {
            int mid = left + size - 1;
            int right = (left + 2 * size - 1 > n) ? n - 1 : left + 2 * size - 1;

            // 这里需要借用合并逻辑,通常可复用上述merge函数或简化内联
            // 为简洁起见,假设有一个通用的 merge 接口支持传入 aux
            // 在实际工程中,为避免频繁 malloc/free,通常会复用全局或局部 aux 数组
        }
    }
    free(aux);
}
注:迭代版本的单次合并逻辑与递归版本相同,区别在于外层循环控制子数组的粒度。由于完整迭代实现需精细处理边界,递归实现在日常开发中更为常用。
性能分析与总结
- 时间复杂度:无论输入数据是否有序,归并排序都需要进行
log n层的拆分与合并,每层合并耗时O(n),因此总时间复杂度恒为O(n log n)。 - 空间复杂度:合并操作需要临时数组存储数据,因此空间复杂度为
O(n)。这是其主要缺点,相比原地排序算法(如堆排序O(1))略显不足。 - 稳定性:在合并过程中,如果两个元素相等,我们优先保留先出现的元素(即代码中的
<=判断),从而保证稳定性。这对于需要按多关键字排序的场景非常重要。
以上就是C语言归并排序的原理、图解与代码实现的详细内容,更多关于C语言高级算法优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















