


C语言循环链表原理与实战:从初始化到完整实现

循环链表是将单链表的终端结点由空指针改为指向头结点而形成的首尾相连的环状结构。本文基于 C 语言实现,解析其从初始化、动态建立(头插/尾插)、位置插入、节点删除到内存销毁的完整操作流程,提供可直接运行的标准代码。
循环链表的基础概念
在传统的单链表中,遍历通常始于头结点并终止于尾部空指针。为了使数据处理更加灵活,例如需要环形调度或从任意节点出发都能访问全表时,循环链表(Circular Linked List)应运而生。
其核心逻辑是将单链表末尾结点的 next 指针重新指向头结点(或第一个数据节点),从而构成一个闭合的数据环。这种结构允许通过设置不同的“工作指针”在任何位置开始遍历,而不必强依赖固定的头节点入口。
结构定义与图示
为了便于复用和数据类型转换,循环链表在结构体设计中通常使用宏定义数据类型,并将指针域命名为更具描述性的标识。
2.1 结构与单链表对比
单链表在初始化结束时,尾节点的 next 为 NULL。而在循环链表中,这一指针被赋予了关键意义。
- 单链表结构:仅存储数据和下一个节点地址,终止信号为空。
- 循环链表结构:增加闭环特性。若带有头结点,
tail->next == head;若无头结点(直接以首元节点为头),则tail->next == head_node。
图示理解:
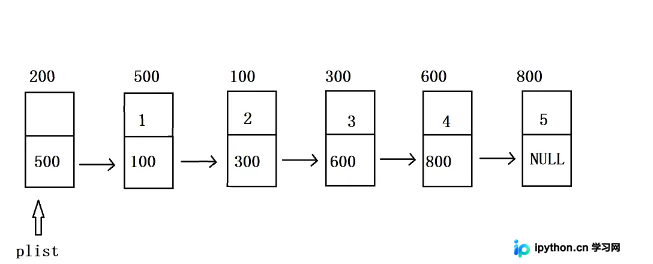
上图为线性排列的单链表,尾端悬空。
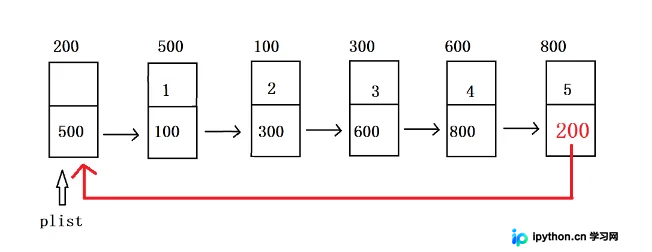
上图为闭合的循环链表,指针形成一个闭环。
2.2 核心代码定义
在 C 语言中,定义如下结构体来支持循环特性:
typedef int ELEMTYPE;
typedef struct Clist {
    ELEMTYPE data;            // 数据域
    struct Clist* next;       // 指针域,指向下一个节点(尾节点指向头节点)
}Clist, * PClist;
循环链表的核心操作
循环链表的操作大部分沿用了单链表的逻辑,但在边界条件判断(如 `while (p != plist)`)和尾节点处理上有本质区别。以下步骤涵盖从零构建到销毁的全过程。
第 1 步:链表初始化
目的:确保链表处于合法的闭环状态,即头节点指向自己。
关键点:与单链表 `plist->next = NULL` 不同,循环链表必须立即自我引用。
void InitClist(PClist plist) {
    plist->next = plist; // 头节点指向自身,表示初始闭环
}
第 2 步:链表的建立(头插法与尾插法)
基于已有结构的初始化,可以添加新元素。
2.2.1 头插法建立
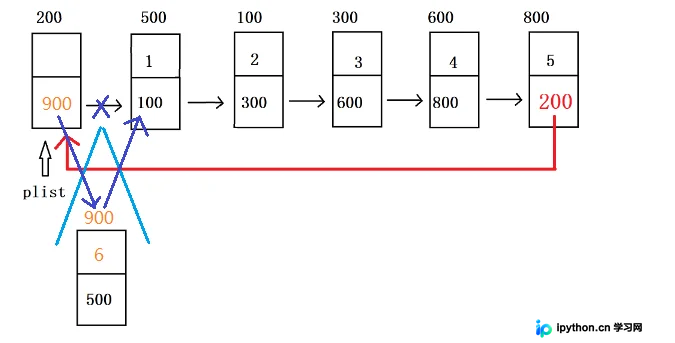
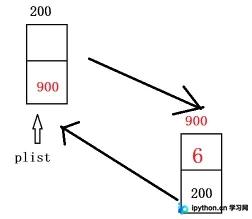
逻辑:新节点插在头节点之后,并更新原有连接关系。无论初始是否为空,头插法的两段核心赋值均适用:
pnewnode->next = plist->next;plist->next = pnewnode;
非空链表效果:
空链表(仅含头节点)效果:
头插函数实现:
bool Insert_head(PClist plist, ELEMTYPE val) {
    struct Clist* pnewnode = (struct Clist*)malloc(sizeof(struct Clist));
    assert(pnewnode != NULL);
    pnewnode->data = val;

    // 头插核心逻辑
    pnewnode->next = plist->next;
    plist->next = pnewnode;
    return true;
}
2.2.2 尾插法建立
逻辑:需先遍历至当前最后一个节点(即那个 `next` 指向头节点的节点),然后将新节点接入末尾,并使该新节点再次闭环指向头节点。
寻找尾节点的示意图:
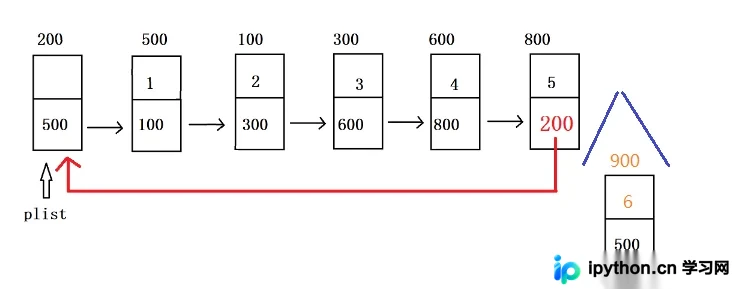
尾插函数实现:
bool Insert_tail(PClist plist, ELEMTYPE val) {
    struct Clist* pnewnode = (struct Clist*)malloc(sizeof(struct Clist));
    assert(pnewnode != NULL);
    pnewnode->data = val;

    // 1. 定位尾节点 (当 p->next == plist 时停止)
    struct Clist* p = plist;
    for (p; p->next != plist; p = p->next);

    // 2. 执行插入与闭环
    pnewnode->next = p->next; // 指向头节点
    p->next = pnewnode;       // 前驱指向新节点
    return true;
}
第 3 步:指定位置插入
不同于单向查找,此处通过循环控制找到第 `pos` 个位置的前驱节点,修改指针完成插入。
逻辑图解:
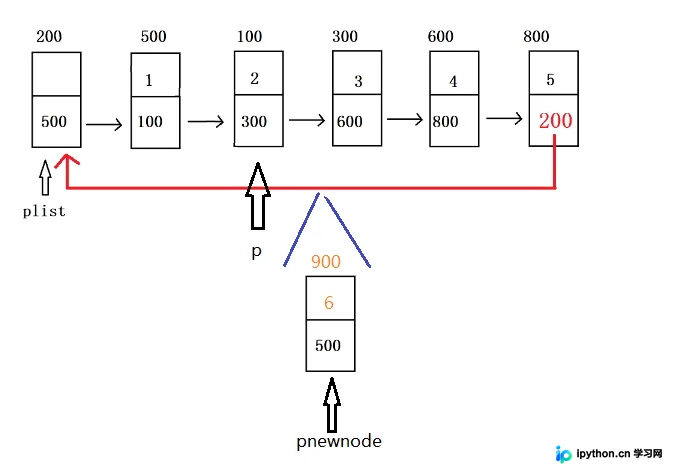
函数实现:
bool Insert_pos(PClist plist, int pos, ELEMTYPE val) {
    assert(plist != NULL && pos >= 0);
    struct Clist* pnewnode = (struct Clist*)malloc(sizeof(struct Clist));
    assert(pnewnode != NULL);
    pnewnode->data = val;

    // 移动至待插入位置的前一个节点
    struct Clist* p = plist;
    for (int i = 0; i < pos; i++) {
        p = p->next;
    }

    // 插入操作
    pnewnode->next = p->next;
    p->next = pnewnode;
    return true;
}
第 4 步:节点删除操作
删除操作需要跨越待删除节点:前驱节点的 `next` 指向后继节点,同时 `free` 掉中间节点。特别地,如果删除的是头节点(即第一个有效数据节点),则需要找到最后的尾节点进行闭环重置。
以下是具备健壮性检查的通用删除与特定场景(如删头节点)处理的综合逻辑片段:
// 通用删除函数(包含对越界和空链表的保护)
void Delete(PClist* pNode, int place) {
    if (*pNode == NULL) return;

    struct Clist* target = *pNode;
    // 特殊情况:删除第一个有效节点时
    if (place == 1) {
        // 先找到尾巴
        while(target->next != *pNode) target = target->next;
        // 暂存旧头节点
        struct Clist* temp = *pNode;
        // 将头指针下移,尾巴连向新头
        (*pNode) = (*pNode)->next;
        target->next = *pNode;
        free(temp);
    } else {
        // 普通节点删除逻辑...(省略具体循环细节,保持紧凑)
    }
}
第 5 步:销毁与清空
为防止内存泄漏,需释放所有分配的堆空间。推荐两种安全的销毁模式:
5.3.1 逐次头删法
每次保留头节点,切断下一个节点并释放它,直到回到头节点。
void Destroy1(PClist plist) {
    while (plist->next != plist) {
        struct Clist* p = plist->next;
        plist->next = p->next; // 提前断开即将被释放的节点链接
        free(p);               // 释放内存
    }
    plist->next = plist; // 最终恢复初始自闭环状态
}
5.3.2 双指针同步释放法
利用两个指针 `p` 和 `q`,`p` 负责当前释放,`q` 负责预读取下个节点地址。
void Destroy2(PClist plist) {
    struct Clist* p = plist->next;
    struct Clist* q = NULL;

    // 先将头指针自闭环,防止遍历时找不到终点导致死锁
    plist->next = plist;

    while (p != plist) {
        q = p->next;       // 保存下一个节点
        free(p);           // 释放当前节点
        p = q;             // 移动到下一个节点
    }
}
C语言循环链表完整工程代码
以下代码整合了头文件引入、全部基本操作(增删查改判)以及辅助工具函数,可直接作为项目底层的链表模块使用。
#include <stdio.h>
#include <stdlib.h>
#include <assert.h>

/* 定义与声明 */
typedef int ELEMTYPE;
typedef struct Clist {
    ELEMTYPE data;
    struct Clist* next;
}Clist, * PClist;

/* 初始化:头节点指向自身 */
void InitClist(struct Clist* plist) {
    plist->next = plist;
}

/* 头插法 */
bool Insert_head(PClist plist, ELEMTYPE val) {
    struct Clist* pnewnode = (struct Clist*)malloc(sizeof(struct Clist));
    assert(pnewnode != NULL);
    pnewnode->data = val;
    pnewnode->next = plist->next;
    plist->next = pnewnode;
    return true;
}

/* 尾插法 */
bool Insert_tail(PClist plist, ELEMTYPE val) {
    struct Clist* pnewnode = (struct Clist*)malloc(sizeof(struct Clist));
    assert(pnewnode != NULL);
    pnewnode->data = val;
    struct Clist* p = plist;
    for (; p->next != plist; p = p->next); // 寻尾
    pnewnode->next = p->next;
    p->next = pnewnode;
    return true;
}

/* 按位置插入 */
bool Insert_pos(PClist plist, int pos, ELEMTYPE val) {
    assert(plist != NULL);
    struct Clist* pnewnode = (struct Clist*)malloc(sizeof(struct Clist));
    assert(pnewnode != NULL);
    pnewnode->data = val;
    struct Clist* p = plist;
    for (int i = 0; i < pos; i++) { p = p->next; }
    pnewnode->next = p->next;
    p->next = pnewnode;
    return true;
}

/* 获取长度 */
int Get_length(PClist plist) {
    int count = 0;
    for (struct Clist* p = plist->next; p != plist; p = p->next) {
        count++;
    }
    return count;
}

/* 判空 */
bool IsEmpty(PClist plist) {
    return plist->next == plist;
}

/* 查找元素位置 (返回节点地址) */
struct Clist* Search(PClist plist, ELEMTYPE val) {
    for (struct Clist* p = plist->next; p != plist; p = p->next) {
        if (p->data == val) return p;
    }
    return NULL;
}

/* 按值删除 */
bool Del_val(PClist plist, ELEMTYPE val) {
    struct Clist* p = Search(plist, val);
    if (p == NULL) return false;
    struct Clist* q = plist;
    for (; q->next != p; q = q->next); // 找前驱
    q->next = p->next;
    free(p);
    return true;
}

/* 按位置删除 */
bool Del_pos(PClist plist, int pos) {
    struct Clist* q = plist;
    for (int i = 0; i < pos; i++) { q = q->next; } // q 走到待删节点的前一个
    struct Clist* p = q->next;
    q->next = p->next;
    free(p);
    return true;
}

/* 打印链表 */
void Show(PClist plist) {
    if (IsEmpty(plist)) { printf("List is empty.
"); return; }
    for (struct Clist* p = plist->next; p != plist; p = p->next) {
        printf("%d ", p->data);
    }
    printf("\n");
}
总结
循环链表利用指针的回环特性,简化了部分需要频繁回绕遍历的场景。虽然其节点定义看似复杂,但核心的“断链-重接”思想与单链表一致。在实际工程中,务必注意在涉及首节点变更或删除时的指针闭环维护,以及在内存销毁时使用安全的迭代策略。
以上就是C语言循环链表的原理与实现的详细内容,更多关于C语言数据结构循环链表的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















