


C语言栈与队列实现详解:顺序、链式结构与关键操作

本文深入解析C语言中栈与队列的实现原理,从顺序栈、链栈到顺序队列、循环队列及链队列,逐一拆解结构体定义与核心函数代码,解决如假溢出等常见问题,帮助理解先进先出(FIFO)与后进先出(LIFO)逻辑在代码中的具体落地。
栈的原理与顺序栈实现
第1步:理解栈的定义与特性
栈(Stack)是一种特殊的线性表,其核心限制在于只能在一端进行插入和删除操作:允许操作的一端称为栈顶(Top),另一端固定不动称为栈底(Bottom)。这种结构决定了数据的进出必须遵循后进先出(Last In First Out, LIFO)原则。
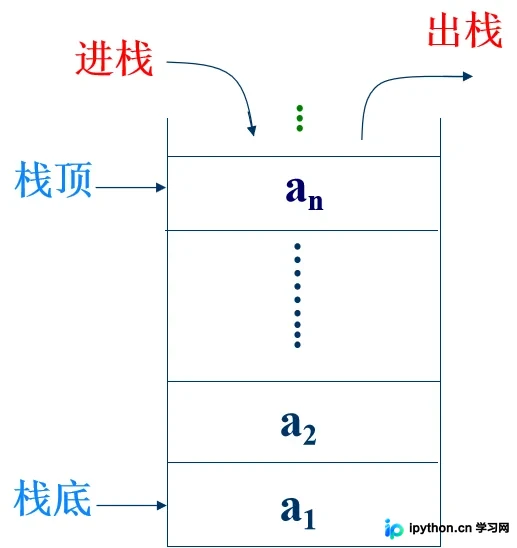
假设栈中元素序列为 $[a_1, a_2, ..., a_n]$,其中 $a_1$ 是第一个进入的栈底元素,$a_n$ 是最后进入的栈顶元素。入栈次序为 $a_1 ightarrow a_n$,而出栈次序必然为 $a_n ightarrow a_1$。
第2步:顺序栈的结构定义与初始化
顺序栈利用地址连续的内存单元(数组)来存储数据,并配合一个整型指针 top 指示当前栈顶位置。初始化即分配最大容量的静态或动态数组空间,并将指针重置表示空栈。
#define MaxSize 100				//定义栈中元素的最大个数
typedef struct
{
	SElemtype *base;			//栈底指针
	SElemtype *top;				//栈顶指针
	int stacksize				//栈可用的最大容量
}SqStack;
初始化操作:
- 使用
new动态分配大小为MaxSize的数组作为栈底。 - 检查内存是否分配成功。
- 将栈顶指针
S.top初始化为栈底指针S.base(表示栈为空)。 - 设置
S.stacksize为MaxSize。
Status InitStack(SqStack &S)
{
	//构造一个空栈S
	S.base = new SElemType[MaxSize];		//动态分配空间
	if(!S.base) exit(OVERFLOW);			//内存分配失败处理
	S.top = S.base;						//指针重合,表明为空栈
	S.stacksize = MaxSize;				//设定最大容量
	return OK;
}
第3步:入栈(Push)与判断满状态
入栈即将新元素压入栈顶。执行前必须判断栈是否已满,防止内存越界覆盖。
实现逻辑:
- 判满:通过比较指针差值判断。若
S.top - S.base == S.stacksize,说明已无剩余空间,返回错误。 - 存入:先将元素赋值给当前
top指向的位置,再将top指针自增(上移)。
Status Push(SqStack &S, SElemType e)
{
	//若栈满则无法继续插入
	if(S.top - S.base == S.stacksize) return ERROR;
	//先赋值,后移动指针(自动扩容栈顶位置)
	*(S.top++) = e;
	return OK;
}
第4步:出栈(Pop)与取栈顶元素(GetTop)
出栈是将栈顶元素移除;获取栈顶元素则仅读取不修改指针。两者均需首先验证栈是否为空。
出栈逻辑:
- 判空:若
S.top == S.base,证明栈内无元素。 - 取值与移动:先将
top指针下移,再取出该位置的值赋给返回值变量e。
Status Pop(SqStack &S, SElemType &e)
{
	//空栈无法弹出
	if(S.top == S.base) return ERROR;
	//指针下移,读取原栈顶元素
	e = *(--S.top);
	return OK;
}
获取栈顶元素:
当栈非空时,top 指向的是下一个空闲位置,因此栈顶实际在 top - 1 处。此操作不改变任何指针。
SElemType GetTop(SqStack S)
{
	if(S.top != S.base) {
	    //直接读取而不移动指针
	    return *(S.top - 1);
	}
	//此处应有异常处理机制
}
链栈的基本概念
链栈(Linked Stack)采用单链表形式实现,无需预先分配固定大小的数组。它通常不需要头结点,直接在链表头部进行元素的插入(push)和删除(pop),时间复杂度均为 O(1)。由于仅在表头操作,不存在像顺序栈那样的“栈满”问题,能更灵活地利用内存。
typedef struct Linknode
{
	ElemType data;				//数据域
	struct Linknode *next;		//指针域
}*LiStack;
队列的原理与顺序队列实现
第1步:理解队列的特性
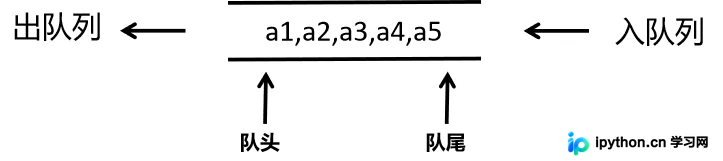
队列(Queue)也是一种受限的线性表,但其两端功能分离:允许在尾部插入(称为队尾/Rear),仅允许在头部删除(称为队头/Front)。这种机制严格遵循先进先出(First In First Out, FIFO)原则,如同日常排队。
第2步:顺序队列的结构与假溢出问题
顺序队列同样使用连续数组,但需要两个指针:front 指向队头,rear 指向队尾的下一个位置(即待插入位置)。
#define MAXSIZE 100		//队列容量
typedef struct
{
	ElemType *base;             //存储空间基址
	int front, rear;            //队首,队尾索引
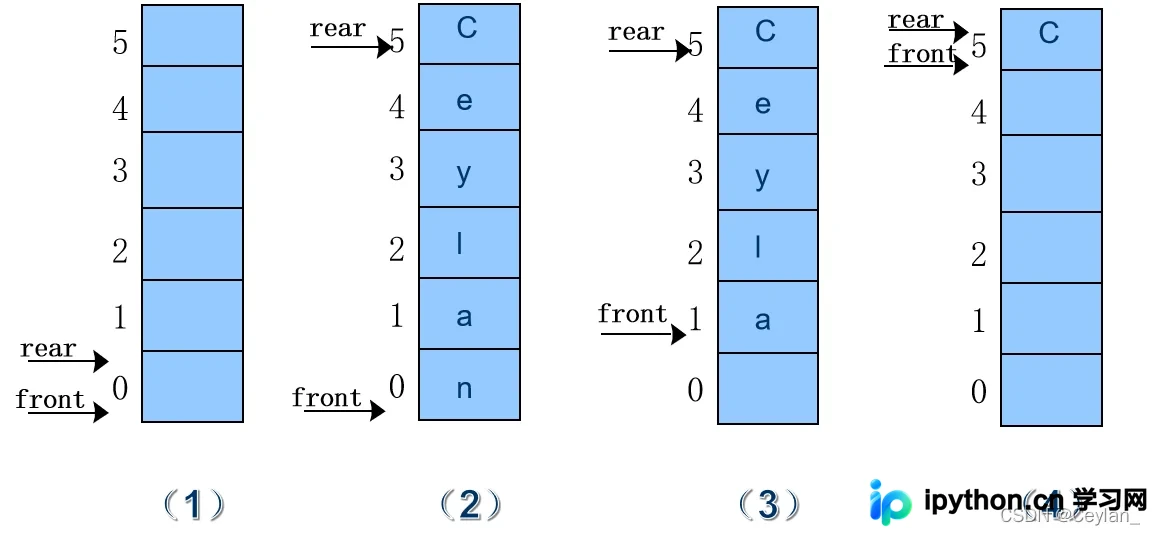
}SqQueue;在实际操作中,随着元素的入队和出队,front 和 rear 会不断向后递增。当 rear 达到数组末尾(MAXSIZE)时,即使数组前端因为元素出队而空出了空间,也无法继续入队。这种现象被称为假溢出(Phantom Overflow)。
第3步:循环队列解决溢出
为解决假溢出,将顺序队列的逻辑存储单元构造成一个环状空间,即利用取模运算(%)使指针回绕到数组头部,这便是循环队列(Circular Queue)。
第4步:循环队列的初始化与操作
初始化:
- 分配固定容量的数组空间。
- 将
front和rear均置为 0,表示队列清空。
Status InitQueue(SqQueue &Q)
{
	Q.base = new ElemType[MAXSIZE];
	if(!Q.base) return OVERFLOW;
	Q.front = Q.rear = 0;   //头尾指针重合,标志空队列
	return OK;
}
入队(EnQueue):
关键在于使用取模运算更新 rear 指针,使其循环回到数组起始位置。
- 判满:当
(Q.rear + 1) % MAXSIZE == Q.front时视为满。(注意:这种方式会浪费一个存储单元以区分空和满的状态)。 - 插入:将元素填入当前
rear索引位置,随后rear = (rear + 1) % MAXSIZE。
Status EnQueue(SqQueue &Q, ElemType e)
{
    //计算下一个位置的索引并与头指针比较
    if((Q.rear + 1) % MAXSIZE == Q.front) return ERROR;

    Q.base[Q.rear] = e;                 //数据入队
    Q.rear = (Q.rear + 1) % MAXSIZE;    //尾指针循环节点
    return OK;
}
出队(DeQueue):
- 判空:若
Q.front == Q.rear则为空。 - 提取:取出
front处的值,然后front = (front + 1) % MAXSIZE前进。
Status DeQueue(SqQueue &Q, ElemType &e)
{
    if(Q.rear == Q.front) return ERROR; //空队列
    e = Q.base[Q.front];                //保存旧头节点数据
    Q.front = (Q.front + 1) % MAXSIZE;  //头指针后移
    return OK;
}
链队列的实现
第1步:链队列结构定义
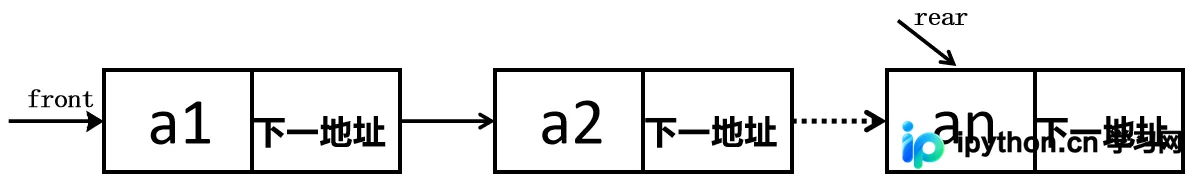
链队列(Linked Queue)是使用带头结点的单链表实现的队列。为了操作方便,通常额外维护两个独立的指针:一个指向链表的头结点(队头),一个指向链表的最后一个结点(队尾)。这保证了无论入队在何处都可以通过尾指针快速完成,且避免了遍历。
//定义链队列节点
typedef struct Qnode {
    ElemType data;
    struct Qnode *next;
}Qnode, *QueuePtr;

//定义链队列结构体
typedef struct {
    QueuePtr front; //队头指针
    QueuePtr rear;  //队尾指针
}LinkQueue;
第2步:链队列的初始化
创建一个空的头结点,并将队头和队尾指针同时指向该头结点,头结点的 next 设为 NULL。
Status InitQueue(LinkQueue &Q)
{
	//分配并初始化头结点
	Q.front = Q.rear = new Qnode;
	Q.front->next = NULL;
	return OK;
}
第3步:入队与出队(含资源释放)
入队:创建新结点并链接到现有尾节点之后,更新队尾指针。
Status EnQueue(LinkQueue &Q, ElemType e)
{
	QueuePtr p = new Qnode;
	p->data = e;    //新结点填充数据
	p->next = NULL;

	Q.rear->next = p; //插入到队尾
	Q.rear = p;       //更新队尾指针为新结点
	return OK;
}出队:删除队头结点后的第一个业务节点。若被删除的是队列中最后一个元素,需特殊处理:将队尾指针重新指向头结点,以防后续误以为队列为空或指针丢失。
Status DeQueue(LinkQueue &Q, ElemType &e)
{
	if(Q.front == Q.rear) return ERROR; //空队列

	QueuePtr p = Q.front->next;         //暂存即将被删除的节点
	Q.front->next = p->next;            //绕过旧节点

	//若出队的元素正是队尾元素,需重置队尾指针指向头结点
	if(Q.rear == p)
	    Q.rear = Q.front;

	e = p->data;                        //回收数据
	delete p;                           //释放内存
	return OK;
}
以上就是C语言中栈与队列顺序及链式实现的详细内容,更多关于数据结构基础与算法优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















