


Python机器学习:Logistic回归原理与代码实现详解

本文深入解析Logistic回归原理,从线性分类到概率映射,详解sigmoid函数与目标函数的构建。通过梯度上升法推导权重参数W,并结合Python代码实现数据读取、模型训练及可视化,帮助读者掌握这一经典分类算法的核心逻辑与实战应用。
前言
Logistic回归涉及高等数学、线性代数、概率论及优化问题。本文旨在以通俗易懂的方式,减少复杂公式推导,侧重形象化案例讲解,帮助读者理解Logistic回归核心。若对数学公式感到不适,请谨慎阅读。
Logistic回归原理与推导
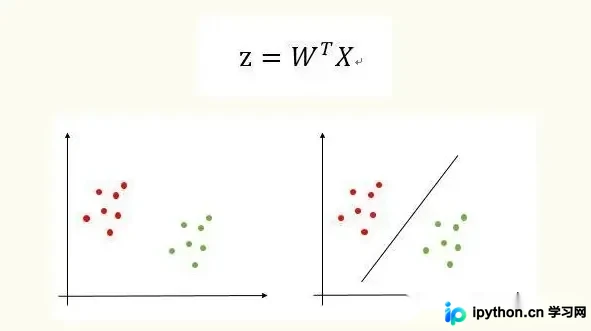
尽管名称包含“回归”,Logistic回归本质上是一种分类算法。如图所示,数据分为两类(红点和绿点)。通过一条直线(w0 * x0 + w1 * x1+w2 * x2)进行划分,当新样本(x1,x2)代入直线函数后,若函数值大于0,则判定为绿色样本(正样本);否则为红色样本(负样本)。
将模型推广至高维空间,我们需要确定一个超平面(二维为直线,三维为平面,n维为n-1维超平面)来分割样本数据。这实际上就是求解该超平面的W参数,因其形式类似于回归分析,故命名为Logistic回归。
sigmoid函数
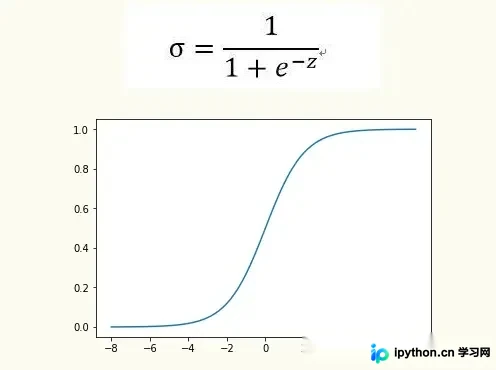
直接使用z值并不直观,我们需要将其转换到[0,1]区间,该转换后的z值代表新样本属于正样本的概率。我们采用sigmoid函数完成此转换,公式如下。观察sigmoid函数图可知,当z值大于0时,σ值大于0.5;当z值小于0时,σ值小于0.5。利用sigmoid函数,Logistic回归本质上成为基于条件概率的判别模型。
目标函数
我们的核心任务是求解W。如何求解?观察下图,第二条直线分割效果最佳,即让样本点距离直线越远越好,这样对新样本的划分更具鲁棒性。如何用公式表示并计算这一目标函数?
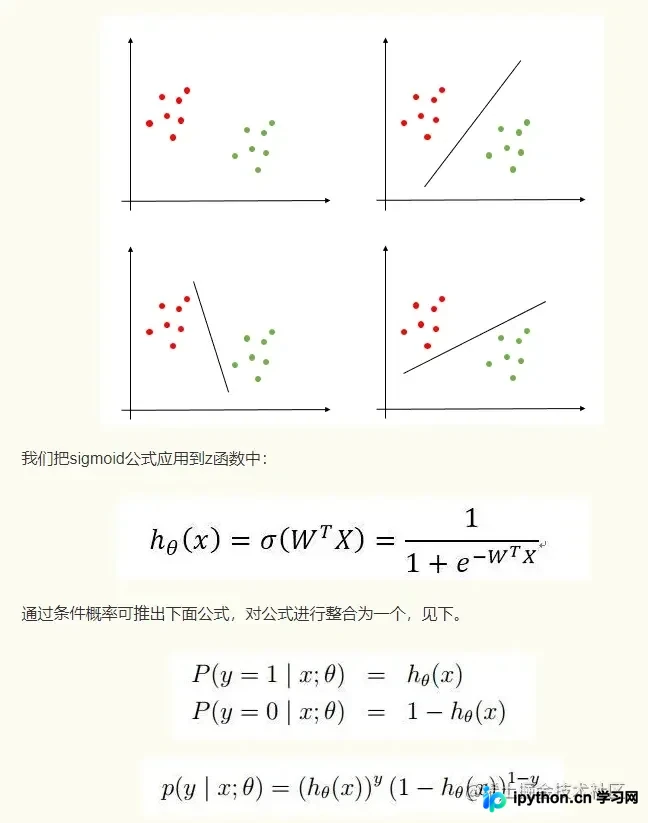
我们需要使目标函数值最大化,从而求出参数θ。
梯度上升法
在介绍梯度上升法前,回顾中学知识:求函数在x等于何值时取最大值。
解:求f(x)的导数:2x,令其为0,求得x=0时,取最大值为0。但在函数复杂时,直接求导计算极值困难,此时需使用梯度上升法。通过迭代,一步步逼近极值,公式如下,我们顺着导数方向(梯度)逐步逼近。
利用梯度算法计算该函数的x值:
def f(x_old):
         return -2*x_old
def cal():
     x_old  = 0
     x_new = -6
     eps = 0.01
     presision = 0.00001
     while abs(x_new-x_old)>presision:
        x_old=x_new
        x_new=x_old+eps*f(x_old)
     return x_new
-0.0004892181072978443
Logistic回归实践
数据情况
读取数据并绘图显示:
def loadDataSet():
    dataMat = [];labelMat = []
    fr = open('数据/Logistic/TestSet.txt')
    for line in fr.readlines():
        lineArr = line.strip().split()
        dataMat.append([1.0, float(lineArr[0]), float(lineArr[1])])
        labelMat.append(int(lineArr[2]))
    return dataMat, labelMat
训练算法
利用梯度迭代公式,计算W:
def sigmoid(inX):
    return 1.0/(1 + np.exp(-inX))
def gradAscent(dataMatIn, labelMatIn):
    dataMatrix = np.mat(dataMatIn)
    labelMat = np.mat(labelMatIn).transpose()
    m,n = np.shape(dataMatrix)
    alpha = 0.001
    maxCycles = 500
    weights = np.ones((n,1))
    for k in range(maxCycles):
        h = sigmoid(dataMatrix * weights)
        error = labelMat - h
        weights = weights + alpha * dataMatrix.transpose() * error
    return weights
通过计算的weights绘图,查看分类结果
算法优缺点
- 优点:易于理解和计算
- 缺点:精度不高
以上就是python机器学习Logistic回归原理推导的详细内容,更多关于python机器学习Logistic回归的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















