


Java 中 ByteArrayInputStream 与 ByteArrayOutputStream 用法详解

ByteArrayInputStream 和 ByteArrayOutputStream 是 Java IO 库中用于在内存中处理字节数据的两个核心类。前者将字节数组作为输入源,后者将数据累积到内部缓冲区并转化为字节数组或字符串。本文将介绍这两个类的构造方式、关键 API 及其结合使用的完整实战示例。
准备条件:理解核心概念
这两个类继承自 InputStream 和 OutputStream,但它们不与物理文件、网络或设备直接交互,而是以 byte[](字节数组)为底层载体。这使得它们非常适合用于需要在内存中临时存储、传输或转换二进制/文本数据的场景。
第一步:使用 ByteArrayOutputStream 写入数据
目的:创建一个可变的字节缓冲区,将需要处理的字符串或二进制数据写入其中。
入口与动作:实例化 ByteArrayOutputStream,调用 write() 方法填入数据。
1. 构造函数选择:
new ByteArrayOutputStream():创建默认大小为 32 字节的缓冲区。new ByteArrayOutputStream(int size):指定初始缓冲区大小,适合已知数据量较大的情况以减少扩容开销。
2. 写入数据的方法:
| 方法签名 | 功能描述 |
|---|---|
public void write(int w) | 将指定的单个字节(低八位)写入输出流。 |
public void write(byte[] b, int off, int len) | 将字节数组 b 中从偏移量 off 开始的 len 个字节写入此流。 |
public void writeTo(OutputStream outSt) | 将此流的全部内容写入另一个指定的输出流(如文件流)。 |
重要提示:close() 方法在此处通常是一个空操作(no-op),因为数据驻留在堆内存中,没有外部系统资源需要释放。不过,为了保持代码规范,养成调用的习惯是好的实践。
第二步:使用 ByteArrayInputStream 读取数据
目的:从之前写入的 ByteArrayOutputStream 中提取 byte[],并将其包装为输入流以便按字节顺序消费。
入口与动作:调用 toByteArray() 获取原始字节,实例化 ByteArrayInputStream,随后使用读取方法。
1. 构造函数:
new ByteArrayInputStream(byte[] buf):完全基于提供的字节数组。new ByteArrayInputStream(byte[] buf, int offset, int count):仅使用数组中从offset开始、长度为count的部分。
2. 读取数据的常用方法:
| 方法签名 | 返回值/功能 |
|---|---|
public int read() | 返回下一个数据字节的整数值(0-255),若到达末尾返回 -1。 |
public int read(byte[] b) | 读取最多 b.length 个字节放入数组,返回实际读取的字节数;末尾返回 -1。 |
public int read(byte[] b, int off, int len) | 将数据读入数组 b 的指定位置。 |
public long skip(long n) | 跳过并丢弃接下来的 n 个字节的数据。 |
public int available() | 返回剩余可供读取(或跳过)的估计字节数。 |
public boolean markSupported() | 测试是否支持 mark() 和 reset()。ByteArrayInputStream 总是返回 true。 |
public void mark(int readlimit) , public void reset() | 标记当前位置和重置到标记位置,常用于需要回退读取的场景。 |
public void close() | 关闭流并释放资源(对内存流而言通常是空的)。 |
第三步:综合实战——内存中的读写循环
目标:演示如何将一段包含中英文的文本转换为字节流存入缓冲区,再读出并进行打印验证。
完整代码示例:
import java.io.ByteArrayInputStream;
import java.io.ByteArrayOutputStream;
import java.io.InputStreamReader;
import java.nio.charset.StandardCharsets;
import java.util.Arrays;

public class ByteArrayDemo {
    public static void main(String[] args) throws Exception {
        // 1. 准备输出流:用于积累数据
        ByteArrayOutputStream bOut = new ByteArrayOutputStream();

        // 2. 写入数据:将 "abc中文" 转为字节并写入
        bOut.write("abc中文".getBytes(StandardCharsets.UTF_8));

        // 关闭(虽无实质操作,但保持规范性)
        bOut.close();

        // 3. 获取原始字节数组
        byte[] bytes = bOut.toByteArray();
        System.out.println("字节内容: " + Arrays.toString(bytes));

        // 4. 准备输入流:从字节数组中读取
        ByteArrayInputStream bIn = new ByteArrayInputStream(bytes);

        // 5. 包装解码器(可选):方便以字符形式查看
        InputStreamReader reader = new InputStreamReader(bIn, StandardCharsets.UTF_8);

        int charData;
        // 6. 循环读取直到结束
        while ((charData = reader.read()) != -1) {
            System.out.print((char) charData);
        }

        reader.close();
    }
}
运行结果:
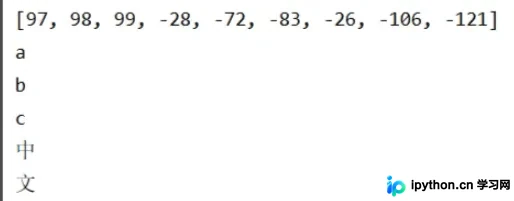
在上述例子中,首先通过 ByteArrayOutputStream 接收了 UTF-8 编码的字节数据,随后通过 toByteArray() 提取出来。接着用 ByteArrayInputStream 将这些字节重新变为一个可读的流,最后通过循环将其还原为字符。整个过程都在内存中完成,高效且轻量。
简要总结
ByteArrayInputStream 和 ByteArrayOutputStream 提供了最底层的字节级内存处理能力。在实际开发中,它们常与其他流(如 GZIPOutputStream、ObjectOutputStream 等)配合,用于序列化、压缩或中间数据的暂存。掌握其 write/read 机制以及 toByteArray()/toString() 的转换,能显著提升对 IO 操作的掌控力。
以上就是 Java 中 ByteArrayInputStream 和 ByteArrayOutputStream 用法详解的详细内容,更多关于 Java 字节流处理、IO 基础优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















