


C语言核心基础:sizeof操作符、整型存储机制与取值范围详解

C语言编程中,理解数据的底层存储至关重要。本文详细剖析sizeof操作符的特性、整型数据在内存中的原码/补码存储机制、大小端字节序差异,以及数据类型如何决定数值的解释方式,帮助开发者掌握从char到int各类型的取值边界与实际应用场景。
1. sizeof 操作符的本质
在C语言开发中,sizeof 常被误认为是函数,用于计算变量或类型占用的字节数;而 strlen 才是计算字符串长度的标准库函数。sizeof 实际上是关键字和操作符,其最显著的特征是括号可选。
通过以下代码可以验证这一特性:
#include <stdio.h>
int main()
{
	int n = 20;
	printf("%d\n", sizeof(n)); // 加括号
	printf("%d\n", sizeof(int)); // 类型不加括号
	printf("%d\n", sizeof n);    // 变量不加括号也能运行
	return 0;
}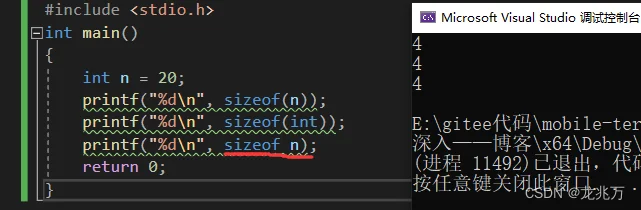
如上所示,sizeof n 无需括号即可正常工作,这直接证明了它不是函数。此外,数组名在 sizeof 内部单独使用时,代表整个数组的大小,而非首元素地址,这也是区分操作符与函数行为的关键点之一。
第1步:验证不同整型类型的大小
为了直观了解各整型类型在内存中的占用空间,可以使用 sizeof 进行测量:
#include <stdio.h>
int main()
{
	printf("char: %zu\n", sizeof(char));
	printf("short: %zu\n", sizeof(short));
	printf("int: %zu\n", sizeof(int));
	printf("long: %zu\n", sizeof(long));
	printf("long long: %zu\n", sizeof(long long));
	return 0;
}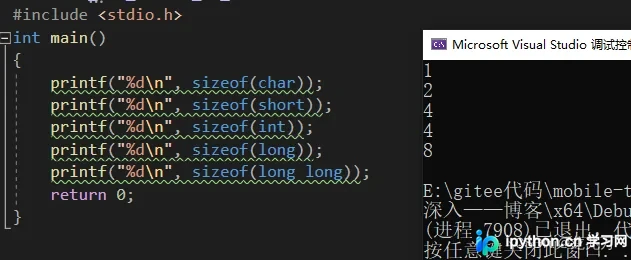
结果将显示不同平台下这些类型所占的字节数,这是理解后续内存布局的基础。
2. 整型数据的存储机制
变量的本质是在内存中开辟一块空间,而数据类型决定了这块空间的宽度。计算机底层仅能识别二进制,因此人类使用的十进制数值需转换为计算机可处理的原码、反码和补码形式。
第2步:理解原码、反码与补码
- 原码:直接将十进制数转换为二进制序列(最高位为符号位)。
- 反码:在原码基础上,符号位保持不变,其余各位按位取反。
- 补码:在反码的基础上加1。
- 逆向还原:补码转回原码可采用“减1后取反”或“按位取反再加1”的方法,CPU通常使用后者以简化硬件设计。
第3步:数据类型不影响存储,只影响解读
一个常见的误区是认为变量类型会改变存储的内容。实际上,**类型仅决定内存空间的分配和数据的解读方式**。例如:
#include <stdio.h>
int main()
{
	unsigned int p = -10;
	// 这里不会报错,-10被存储为无符号整数形式
	return 0;
}
我们将负数赋值给无符号变量,编译通过。这是因为内存只是单纯地存放了该数值的补码序列,不关心它是正数还是负数。这就好比钱包里装的是100元纸币,至于它是美元还是港币(类型),取决于你如何查看和使用它。
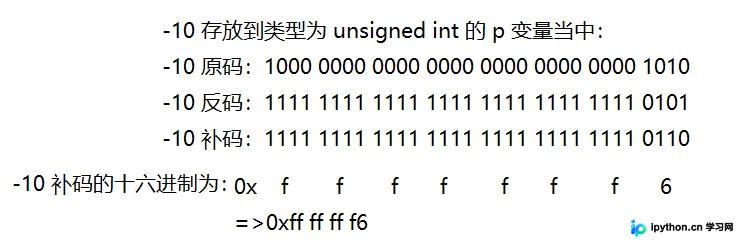
当我们在调试器中观察 p 变量时:
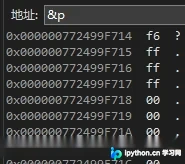
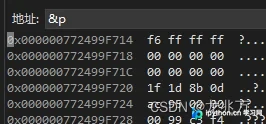
可以看到内存中存放的是十六进制表示的二进制序列。由于 int 占4个字节,数据占据了连续的内存单元。有趣的是,如果我们以多列形式查看内存地址:
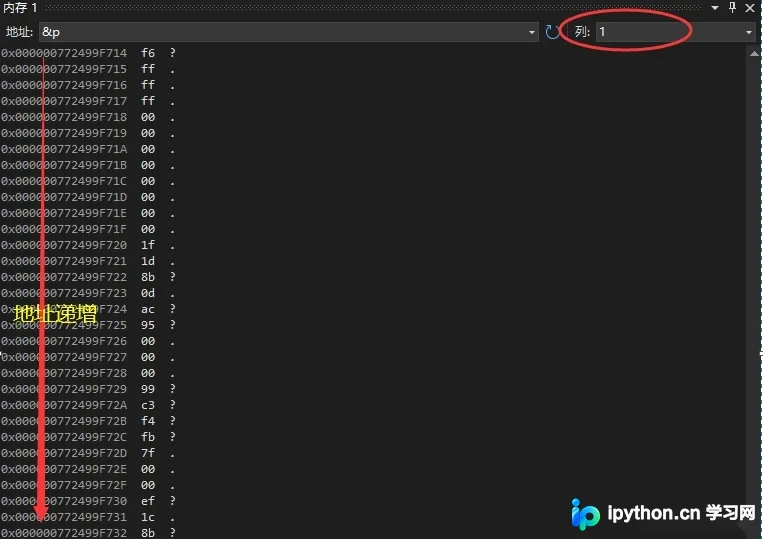
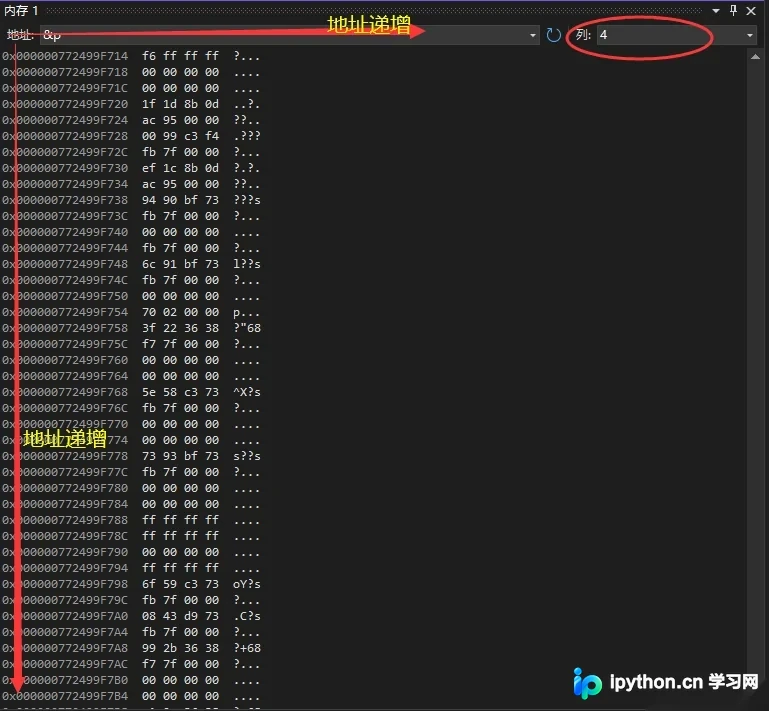
会发现低地址处存放的是低位字节(如 f6),高地址处存放高位字节。这种现象称为小端存储(Little-Endian)。
第4步:小端与大端存储模式
小端存储:权重小的字节(低位)存放在低地址,权重大的字节(高位)存放在高地址。目前绝大多数PC架构采用此模式。
大端存储:权重小的字节存放在高地址,权重大的字节存放在低地址。
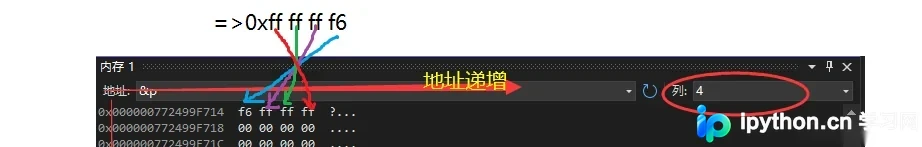
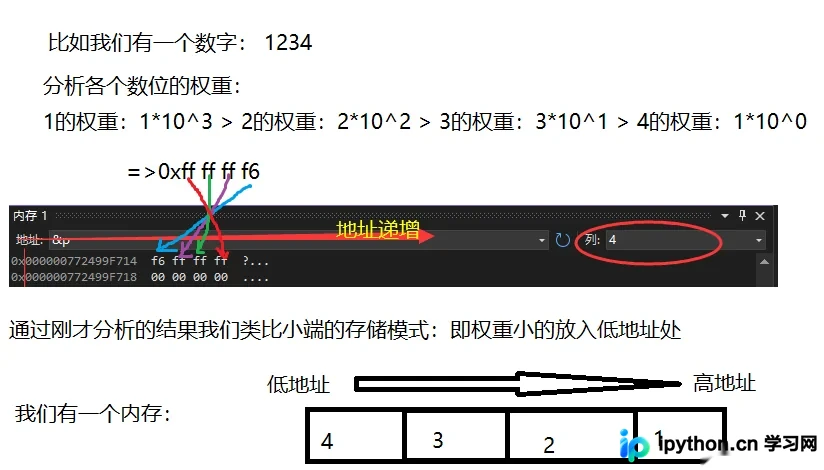
这种差异源于不同的硬件设计理念,但在网络传输和跨平台数据交换时,必须注意字节序的一致性。
3. 数据的取出与类型转换
既然数据在内存中以固定格式存储,那么读取时的结果完全取决于使用的格式说明符或变量类型。继续以上面 unsigned int p = -10; 为例:
#include <stdio.h>
int main()
{
	unsigned int p = -10;
	printf("%u\n", p); // 以无符号整数打印
	printf("%d\n", p); // 以有符号整数打印
	return 0;
}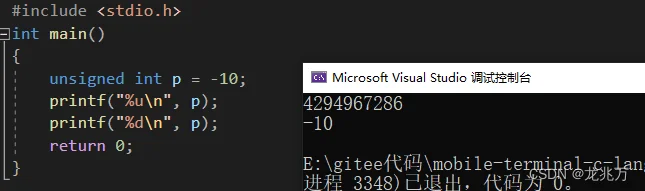
同一块内存,用 %u 解释会得到一个巨大的正数,而用 %d 解释则得到原始的 -10。这是因为计算机在读取时,会根据类型判断是否将最高位视为符号位。
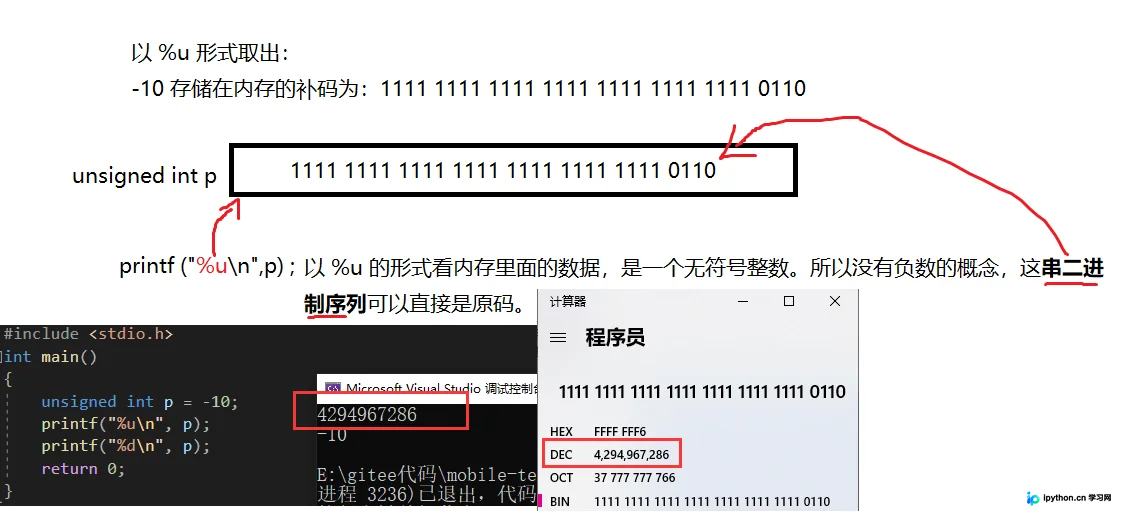
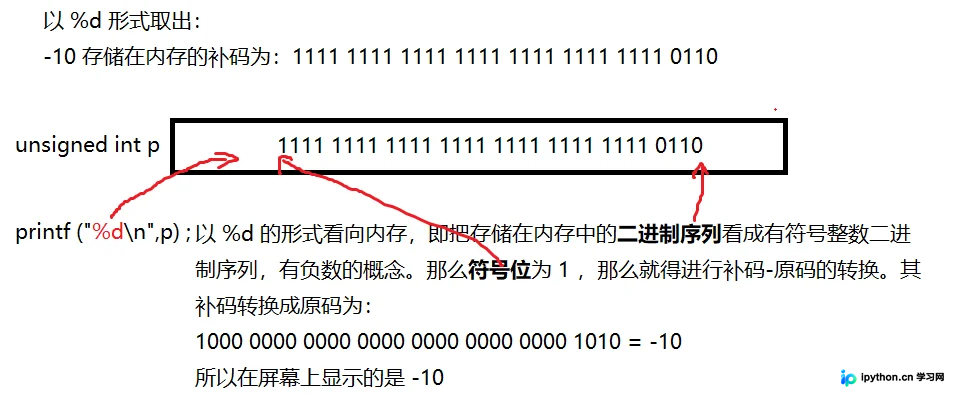
结论:数据类型不影响存储内容,但绝对影响数据的取出和语义解释。
4. 字符类型的取值范围与应用
了解取值范围有助于避免缓冲区溢出和逻辑错误。以 char 类型为例,它占用1个字节(8 bit)。
第5步:推导 char 的取值范围
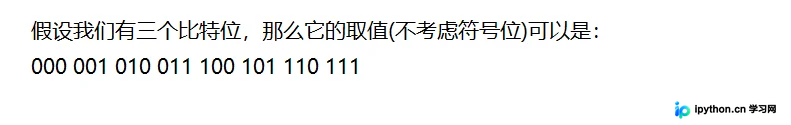
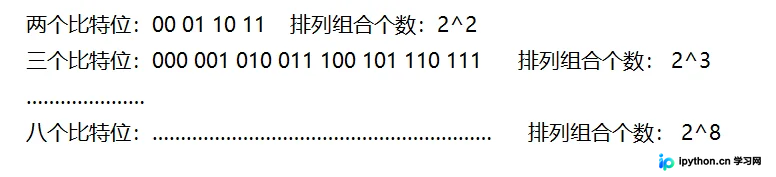
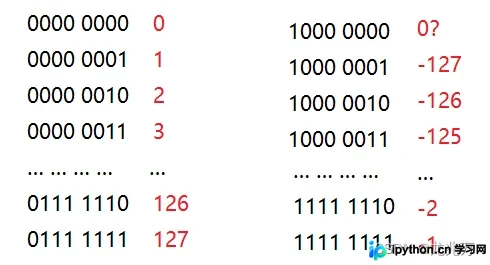
8位二进制共有 $2^8 = 256$ 种组合。对于有符号 char,最高位是符号位,理论上范围似乎应为 [-127, 127],但这只有255个数,浪费了一个状态。
为了避免重复表示0,编译器设计时将 1000 0000 这个特殊值定义为 -128。因此,有符号 char 的范围是 [-128, 127],即 [-2^7, 2^7-1]。
第6步:实战案例 —— strlen 与数组溢出
这是一个经典的面试题,考察对 char 范围和 strlen 原理的理解:
#include <stdio.h>
#include <string.h>
int main()
{
	char arr[1000];
	for (int i = 0; i < 1000; i++)
	{
		arr[i] = -1 - i;
	}
	printf("%d\n", strlen(arr));
	return 0;
}分析过程:
strlen 遇到第一个值为 0(即 '\0')时停止计数。
循环中 arr[i] = -1 - i:
- 当 i=0, arr[0] = -1
- ...
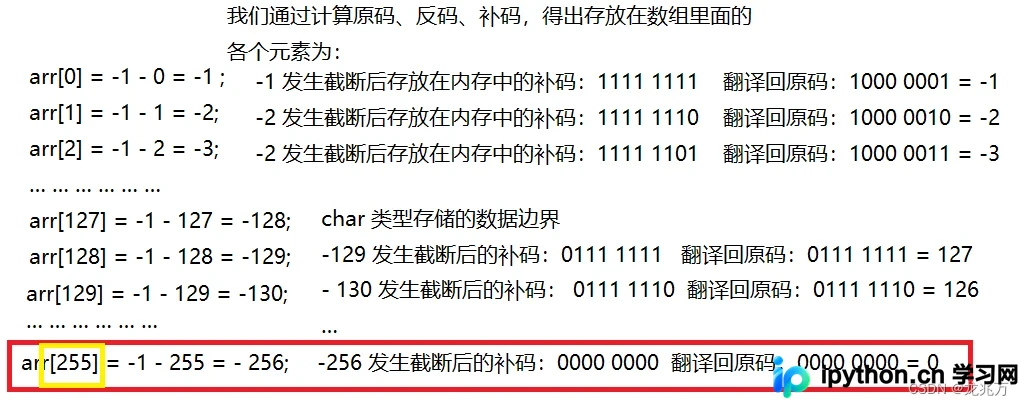
- char 范围为 [-128, 127]。当 i=127 时,arr[127] = -128。
- 当 i=128 时,arr[128] = -129。由于溢出,-129 在8位有符号整数中等价于 127。
- 随着 i 增加,数值会从 127 递减。直到某个时刻数值回到 0。
让我们追踪一下何时出现0:
i=0 ~ 127: 值从 -1 到 -128
i=128: 值变为 127
i=255: 值从 127 倒数到 0。
具体计算:arr[255] = -1 - 255 = -256。在8位补码中,-256 对应全0,即 0x00。
因此,arr[255]'\0' 字符。
strlen 统计 '\0' 之前的字符个数,即下标 0 到 254 共 255 个字符。
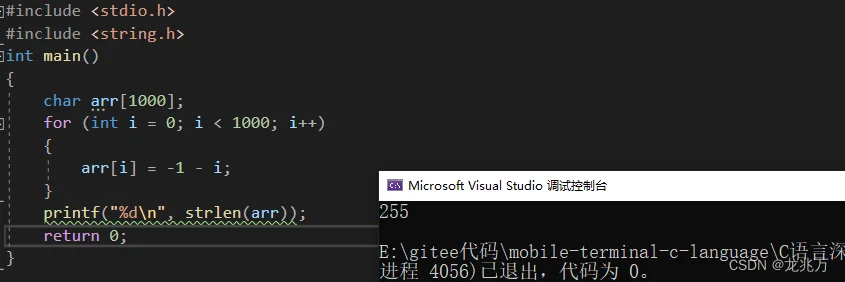
最终输出结果为 255。
以上就是关于C语言深入探究sizeof与整型数据存储及数据类型取值范围的详细内容,更多关于C语言基本语法与内存管理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















