


深入了解Golang的指针用法

Golang 拥有类似 C 的指针机制,通过传递内存地址而非数据副本可有效减少内存占用,但在操作不当时会引发常见 bug。本文详细解析指针变量的取值规则、结构体字段的自动解引用、Go 仅存在值传递的本质,并重点剖析 for 循环中的变量复用、闭包作用域以及由指针导致的内存逃逸风险。
1.指针类型的定义与特殊行为
在 Golang 中,可以通过取地址符号 & 获取普通变量的内存地址,该新变量即为指针类型。与普通变量存储具体数值不同,指针变量存储的是内存地址。
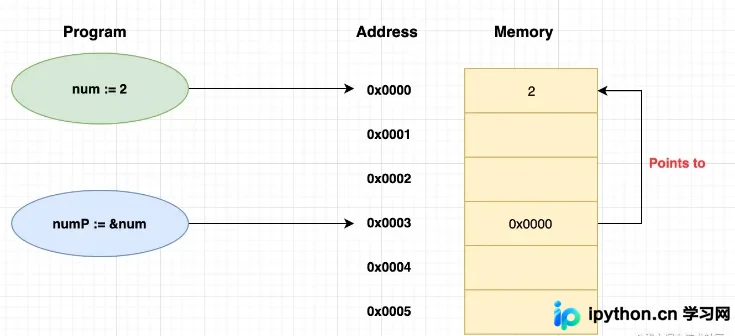
对于基础类型(如 int),必须使用 * 取值符(间接寻址)才能修改其指向的值。若尝试直接赋值,编译器会报错提示类型不匹配:
func main() {
	num := 1
	numP := &num
	// numP = 2 // 报错:(type untyped int) cannot be represented by the type *int
	*numP = 2
}
第1步:理解结构体字段的隐式解引用
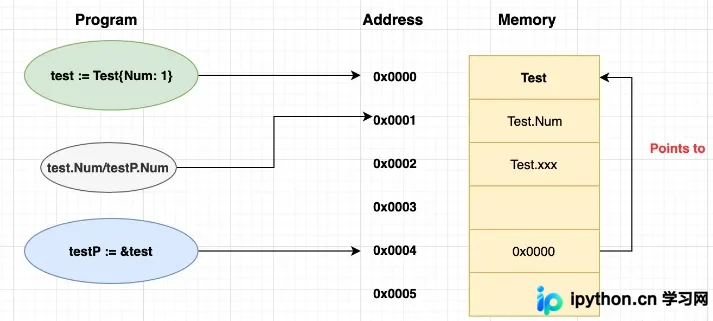
在日常开发中,经常看到可以直接通过结构体指针访问并修改内部字段(例如 testP.Num = 4),这并非因为改变了指针本身的规则,而是因为 Go 编译器提供了语法糖。
type Test struct {
	Num int
}

// 直接赋值和指针赋值
func main() {
	test := Test{Num: 1}
	test.Num = 3
	fmt.Println("v1", test) // 3

	testP := &test
	testP.Num = 4           // 结构体指针可以赋值
	fmt.Println("v2", test) // 4
}
当执行 testP.Num = 4 时,本质上是指针先解引用拿到内部的 Num 变量,然后再对该普通变量进行赋值。这种设计简化了面向对象式的成员访问方式,无需每次手动写 (*testP).Num = 4。
第2步:掌握切片、Map 和 Channel 的特殊性
在使用 fmt.Printf("%p\n", nums) 打印切片或 Map 的地址时,即使不使用 &,也能得到其内存地址。这是因为这些类型在运行时底层本质上就是指针(或者叫引用类型):
- Slice:包含指向数组的指针、长度和容量。创建时返回的就是底层数组的指针。
- Map:内部维护一个哈希表的头指针。
- Channel:内部是一个环形缓冲区的指针(
*hchan)。
func main() {
	nums := []int{1, 2, 3}
	fmt.Printf("%p\n", nums)     // 0xc0000160c0
	fmt.Printf("%p\n", &nums[0]) // 0xc0000160c0,首元素地址与Slice指针一致
}
在函数调用时,传入 Slice 实际上是拷贝了该指针(即“传址”的形式依然是值传递,只是传的值是地址)。因此,在函数内对 Slice 元素进行修改,会直接影响原数据。此外,fmt.Printf 能够正确打印它们的地址,是因为其内部源码在调用 fmtPointer 时,对 reflect.Slice、reflect.Map、reflect.Chan 等类型做了特殊处理,直接从 reflect.Value 提取了底层的指针值。
2.Go 只有值传递,没有引用传递
理解 Go 的参数传递方式是避开指针 Bug 的关键。在 Go 语言中,所有的参数传递都是值传递。
第3步:区分表面现象与内存拷贝
当我们传递指针参数时,表面上看起来像是修改外部变量,但实际上在函数调用栈帧中,系统完成了一次指针值的拷贝。
type User struct {
	Name string
	Age  int
}

// 形参接收的是用户对象的地址(拷贝了一份指针)
func setNameV1(user *User) {
	user.Name = "test_v1"
}

// 形参接收的是整个用户对象(拷贝了整个内存块)
func setNameV2(user User) {
	user.Name = "test_v2"
}

func main() {
	u := User{Name: "init"}
	up := &u

	setNameV1(up)
	fmt.Println("v1", u) // v1 {test_v1 0}

	setNameV2(u)
	fmt.Println("v2", u) // v2 {test_v1 0},原对象未变
}
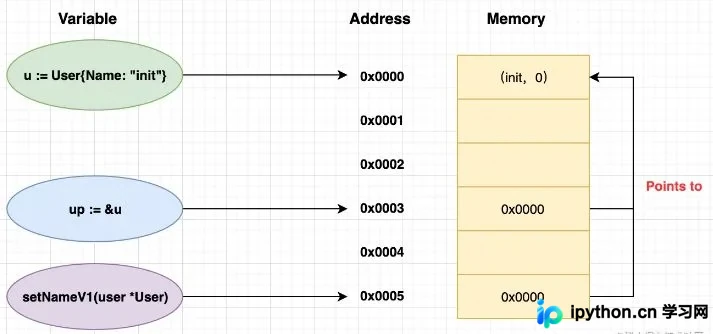
为了验证这一结论,可以通过打印传入函数的指针变量自身所在的地址来观察。即便函数内修改了指针指向的值,但函数参数变量 user 本身在调用者(main 函数)和被调者(setNameV1)中的内存位置是不同的。如果尝试在函数内改变 user 这个局部指针变量指向另一个对象,外部实参的指针并不会被修改。总结来说:Go 的引用传递其实是引用的拷贝。
3.for range 与指针的经典陷阱
for 语句结合指针极易产生逻辑错误,尤其在收集对象集合或配合协程使用时。由于每次循环迭代,循环变量只初始化一次且复用同一个内存地址,直接使用其地址会导致所有收集项指向同一对象。
第4步:修复 Slice 遍历时地址重复的问题
以下错误示例展示了在遍历过程中将循环变量 u 的地址追加到 newUser 切片中。无论 u 的值如何变化,&u 始终是固定地址,最终切片中全部指向最后一次循环后的状态。
type User struct {
	Name string
	Age  int
}

func main() {
	userList := []User{
		User{Name: "aa", Age: 1},
		User{Name: "bb", Age: 1},
	}

	var newUser []*User
	// 错误做法:直接追加 &u,此时多次添加的都是同一地址
	for _, u := range userList {
		newUser = append(newUser, &u)
	}

	// 输出均为 bb
	for _, nu := range newUser {
		fmt.Printf("%+v\n", nu.Name)
	}
}
正确的做法是在循环体内新建一个局部变量,并将当前迭代值赋给该局部变量,然后返回局部变量的地址。
// 修正方案 A:循环内声明新变量
for _, u := range userList {
    u := u // 为当前迭代创建一个新的局部变量 u
    newUser = append(newUser, &u)
}

// 修正方案 B:利用索引手动构建新的结构体
for i, u := range userList {
    newUser = append(newUser, &userList[i])
}
4.闭包、Goroutine 与指针的交互
在并发编程和闭包场景中,同样受变量地址复用规则影响。
第5步:避免 Goroutine 捕获循环变量
如果在 for 循环中启动 Goroutine,且不进行变量拷贝或显式传参,多个协程读取到的往往是同一个变量。i 的最终值可能在协程运行前已经被递增完毕,导致结果不符合预期(例如都输出最终值 10,或发生竞态条件)。正确的做法是将变量作为参数显式传递给协程,或在协程内部复制一份。
第6步:理解闭包的指针捕获效应
闭包会捕获其外层函数作用域内的变量引用。当传入的是指针时,闭包内部修改值会实时更新到外部变量;而传入的是值时,闭包修改的仅是闭包内部的副本,不影响外部:
func incr1(x *int) func() {
	return func() {
		*x = *x + 1   // 指针:修改的是共享内存
		fmt.Printf("incr point x = %d\n", *x)
	}
}
func incr2(x int) func() {
	return func() {
		x = x + 1     // 值拷贝:仅修改闭包内副本
		fmt.Printf("incr normal x = %d\n", x)
	}
}

func main() {
	x := 1
	i1 := incr1(&x)
	i2 := incr2(x)

	x = 100
	i1() // 输出 101。指针捕获使得闭包感知到了 x=100 的变化
	i2() // 输出 4。之前的递增不受外界重置影响
}
5.指针引发的内存逃逸分析
虽然指针能避免大数据结构的值拷贝从而节省空间,但若使用不当会引起“内存逃逸”——即本应在栈(Stack)上分配销毁的变量被迫转移到堆(Heap)上。这会显著增加 GC 压力,降低程序吞吐量。
第7步:识别导致逃逸的高危操作
以下三种情况会导致因指针而产生的内存逃逸:
- 返回局部变量的地址:函数结束局部变量生命周期终结,若将其地址返回,该数据必须留在堆上。
func NewEscape() *Escape {
    return &Escape{} // 局部匿名结构体的指针逃逸到堆
}- 逃逸变量引用了其他指针:如果某个已经分配到堆上的对象持有了对其他指针的引用,这些被引用的指针也可能随之逃逸。
func main() {
	e := NewEscape()
	name := "aa"
	e.Str1 = &name // e 已逃逸,e 中的 Str1 也带入了 name 逃逸
}- 通过切片或容器持有局部变量地址:如果在堆上的数据结构(如 slice)中存储了局部变量的地址,也会导致局部变量滞留堆内存。
func main() {
    n := 10
    arr := make([]*int, 2)
    arr[0] = &n // 切片分配在堆(或被逃逸结构引用),导致 n 逃逸
}
合理评估是否需要返回指针或使用全局结构体切片,可以有效缓解不必要的内存压力。
总结
Go 语言虽然在语法层面隐藏了复杂的指针操作,但其核心机制依然基于内存地址的管理。无论是处理 Slice 和 Map 的内部引用,还是在多阶段代码中应对参数传递、遍历引用及并发闭包带来的副作用,都必须保持对“值传递指针”以及“变量地址复用”这两大原则的清醒认知。了解这些底层运作规律并结合 go build -gcflags='-m' 工具审查内存逃逸情况,能够帮助开发者写出更加稳健和高性能的程序。
以上就是深入了解Golang的指针用法的详细内容,更多关于Golang指针的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















