


Go语言实现JSON解析器:从词法分析到语法树构建

本文将深入剖析如何使用 Go 语言从零开始实现一个 JSON 解析器。通过约 800 行代码,我们利用有限自动机(DFA)完成词法分析,并通过栈结构构建语法树,无需依赖第三方库即可完整支持 JSON 的标准格式解析。
项目背景与目标
在常规的软件开发中,JSON 作为最轻量级的数据交换格式之一,其解析器无处不在。虽然标准库 encoding/json 功能强大,但了解其底层实现有助于掌握编译原理的基础知识。本项目旨在通过 xjson 库,展示如何仅使用编译原理前端的核心概念——词法分析和语法分析,来构建一个完整的 JSON 解析器。
核心实现原理
JSON 解析器的核心逻辑可以拆解为两个主要阶段:首先是将原始字符串拆解为离散的 Token,随后将这些 Token 组合成具有层级结构的 JSONObject。
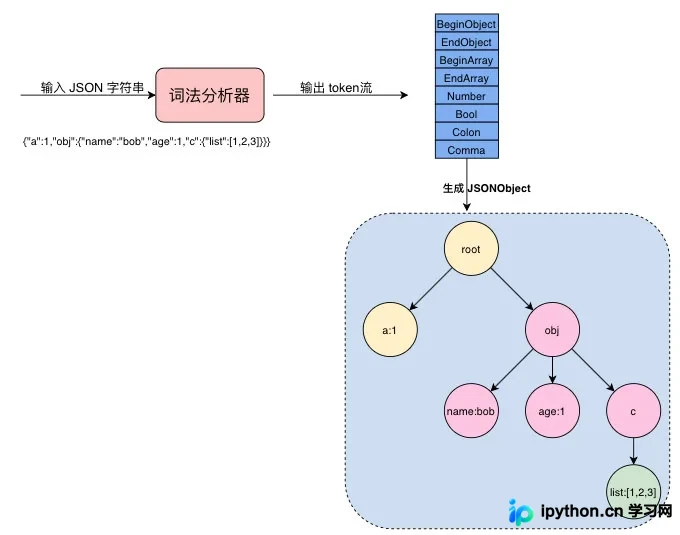
第一步是词法解析(Lexical Analysis)。它负责遍历输入的 JSON 字符串,识别出各类符号(如 {, "key", :, 123),并将它们归类为不同的 Token。这一步类似于给文本中的每个字符打上标签,明确其语义角色。
第二步是语法生成。系统以流的形式读取上一步生成的 Token 集合,依据 JSON 的语法规则,将其组装成一棵倒置的树状结构。这棵树最终对应内存中的 JSONObject,其中包含了所有的键值对和嵌套关系。
词法分析与 DFA 设计
词法分析的本质是构建一个确定有限自动机(DFA)。我们需要定义一系列 Token 类型,以便后续处理:
type Token string
const (
    Init        Token = "Init"
    BeginObject       = "BeginObject"
    EndObject         = "EndObject"
    BeginArray        = "BeginArray"
    EndArray          = "EndArray"
    Null              = "Null"
    Number            = "Number"
    Float             = "Float"
    String            = "String"
    True              = "True"
    False             = "False"
    SepColon          = "SepColon"
    SepComma          = "SepComma"
    EndJson           = "EndJson"
)
在词法解析过程中,程序维护一个全局状态。每读取一个字符,就根据当前字符和当前状态执行状态转移。例如,对于字符串 {"age":1},解析流程如下:
func TestInitStatus(t *testing.T) {
    str := `{"name":"cj", "age":10}`
    tokenize, err := Tokenize(str)
    assert.Nil(t, err)
    for _, tokenType := range tokenize {
        fmt.Printf("%s  %s\n", tokenType.T, tokenType.Value)
    }
}
/* Output:
BeginObject  {
String  "name"
SepColon  :
String  "cj"
SepComma  ,
String  "age"
SepColon  :
Number  10
EndObject  }
*/
以下是具体的状态流转示意:
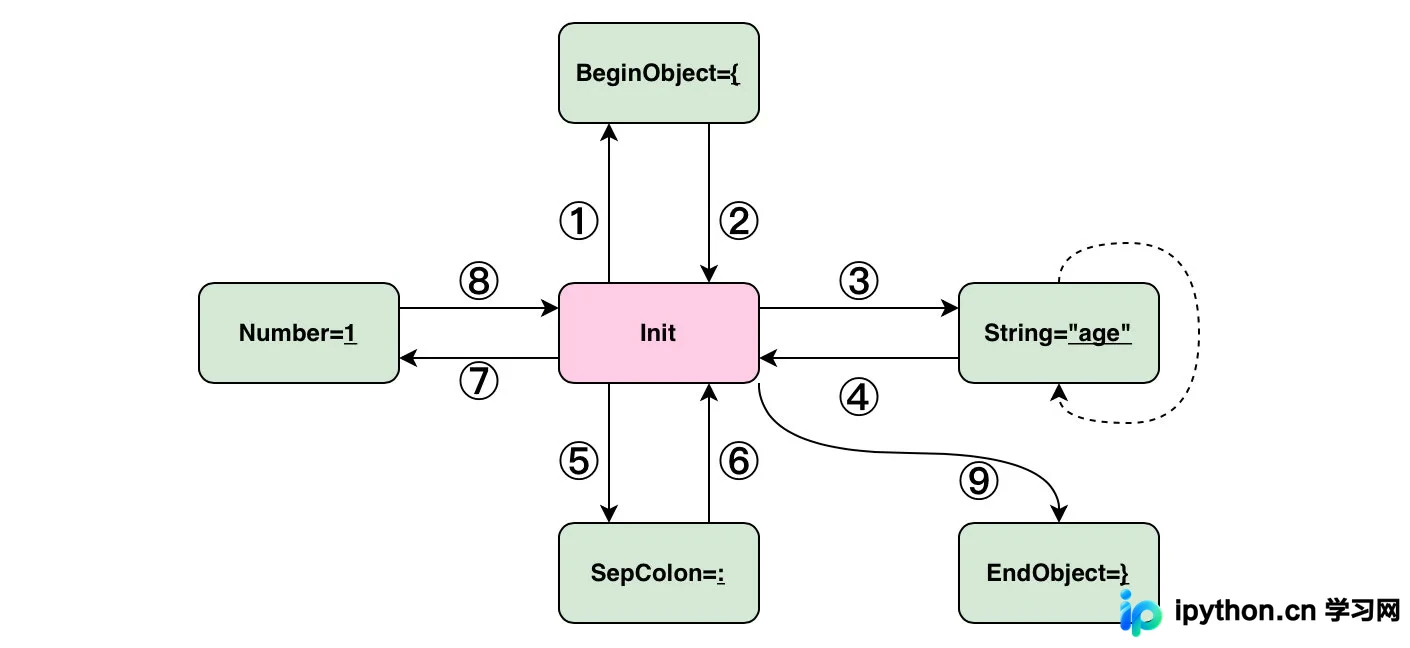
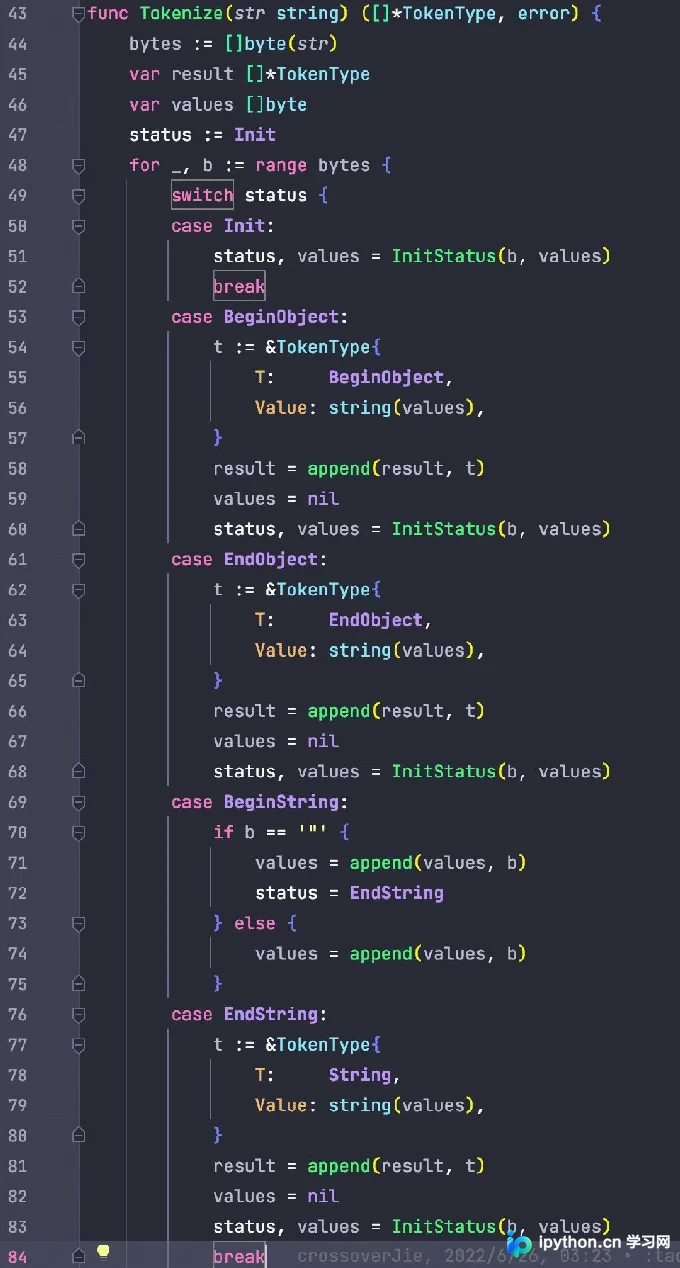
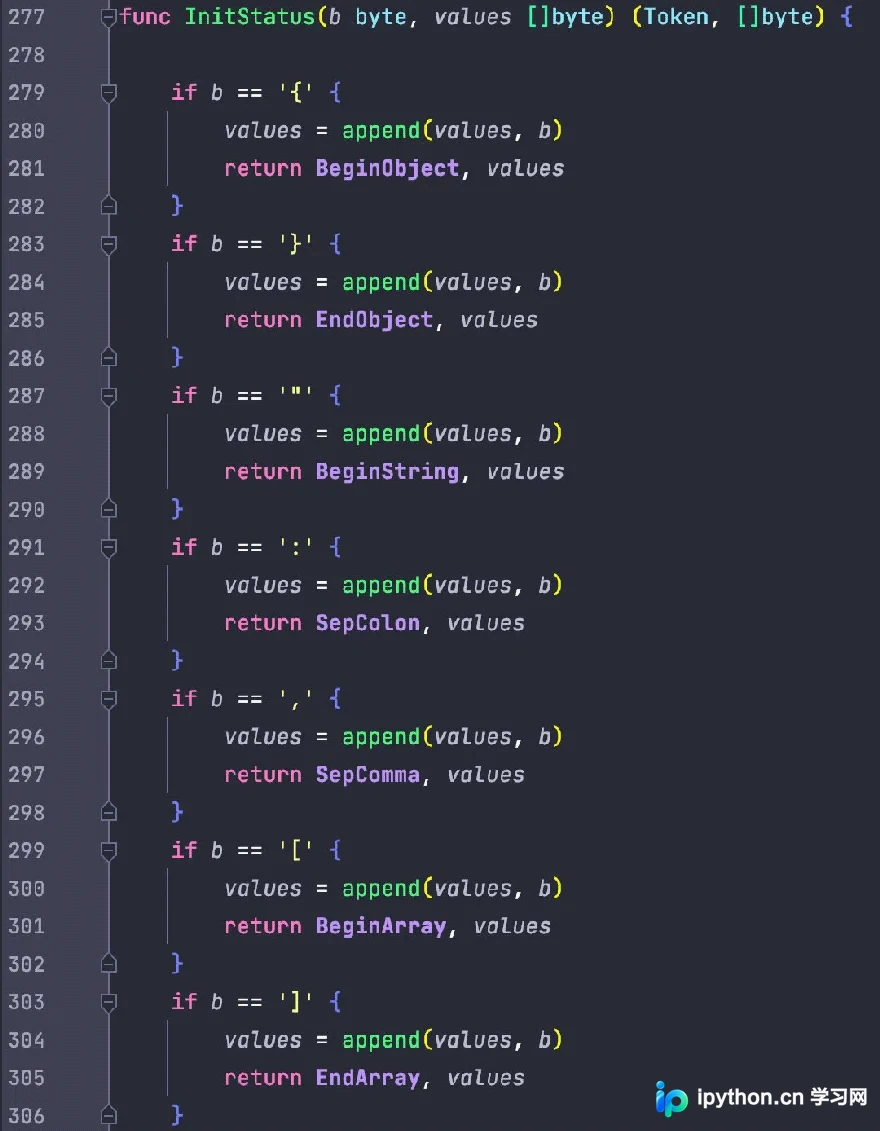
提前检查与错误拦截
由于 JSON 语法相对固定,部分规则可以在词法阶段直接校验,从而尽早发现非法输入。例如:
- 关键字完整性:当检测到
null的首字母n时,后续字符必须严格匹配u->l->l,否则抛出异常。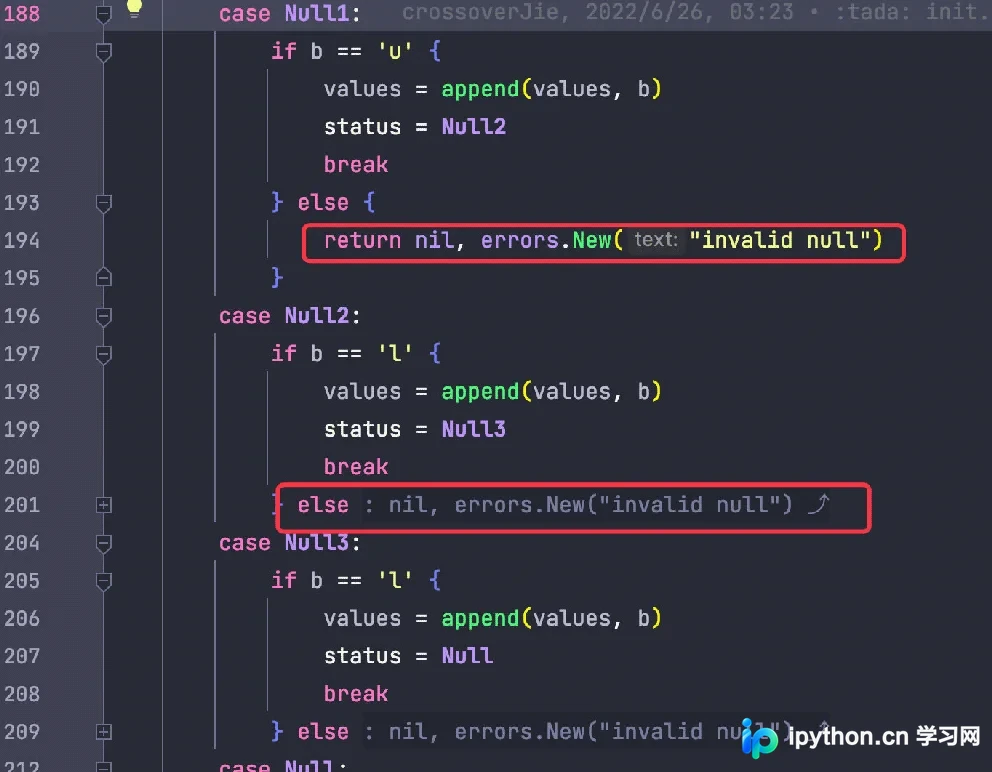
- 浮点数格式:如果在一个数值中遇到多个小数点
.,即判定为格式错误。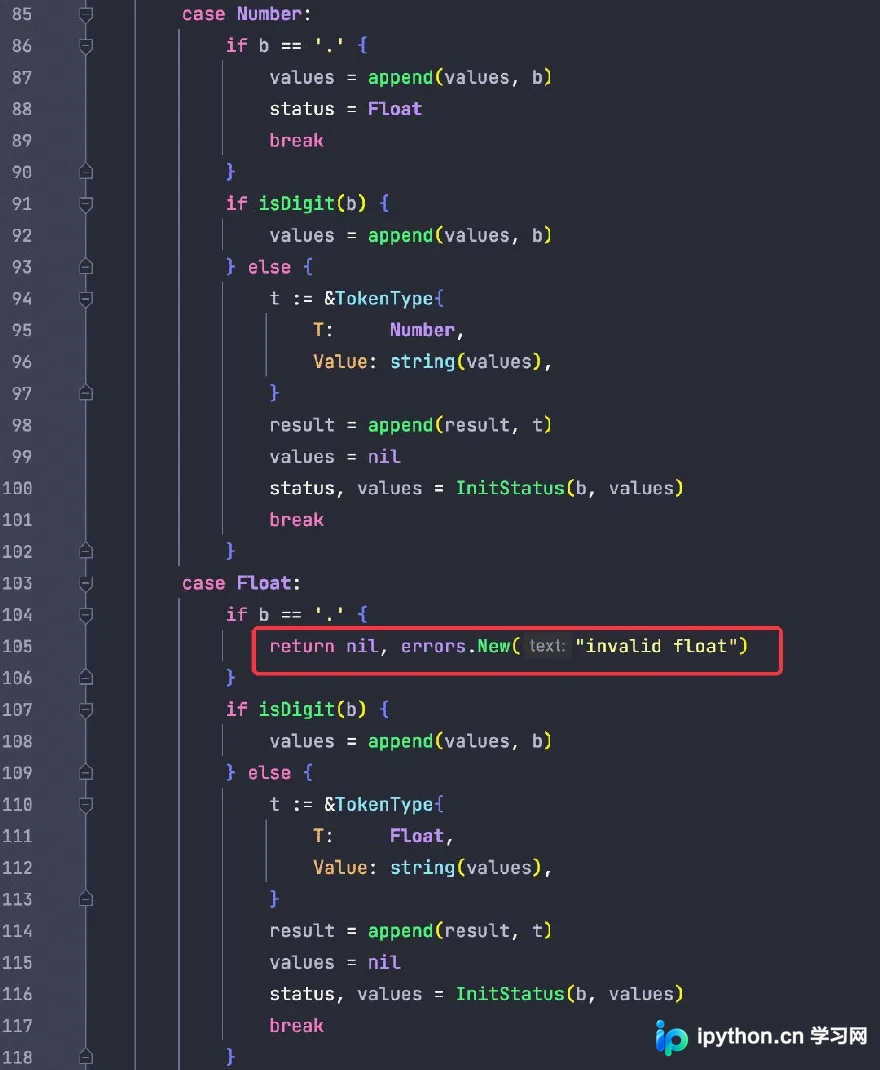
这种机制确保了只有合法的 Token 才能进入后续的语法分析环节。
构建 JSONObject 树
拿到 Token 序列后,下一步是构建结构树。我们可以类比判断括号是否合法的问题:[<()>] 是合法的,而 [<()>) 则是非法的。
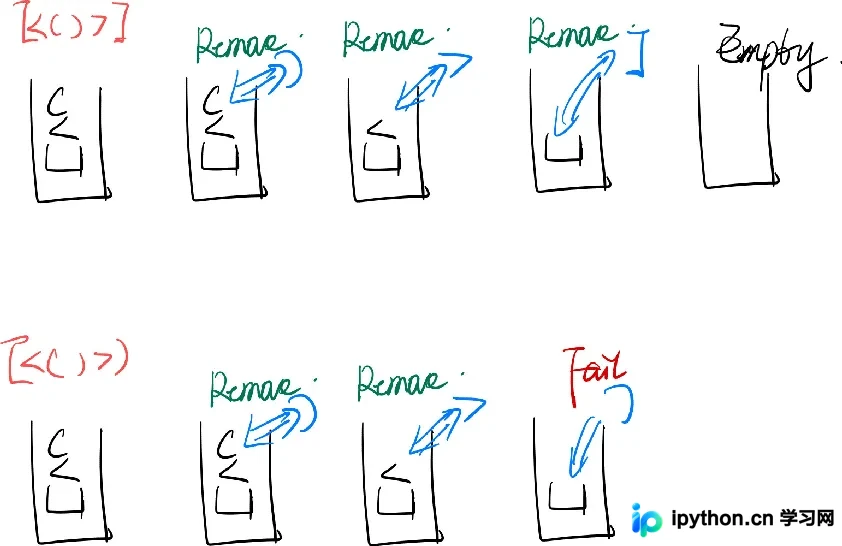
解决此类问题的经典方法是使用栈(Stack)结构:
- 遇到左边界符(如
{或[)时,入栈一个新的容器(Map 或 Slice)。 - 遇到右边界符(如
}或])时,与栈顶元素匹配并弹出,完成当前层级的闭合。
在 JSON 解析中,我们同样需要维护一个栈和一个全局状态机:
- 对象解析:当读到
BeginObject,栈内压入一个新的 Map;当读到Key时暂存,直到遇到SepColon,此时状态标记为StatusColon,等待值;读到值后,写入当前的 Map,并弹出 Key。 - 数组解析:类似地,遇到
BeginArray压入 Slice,逐个添加元素。
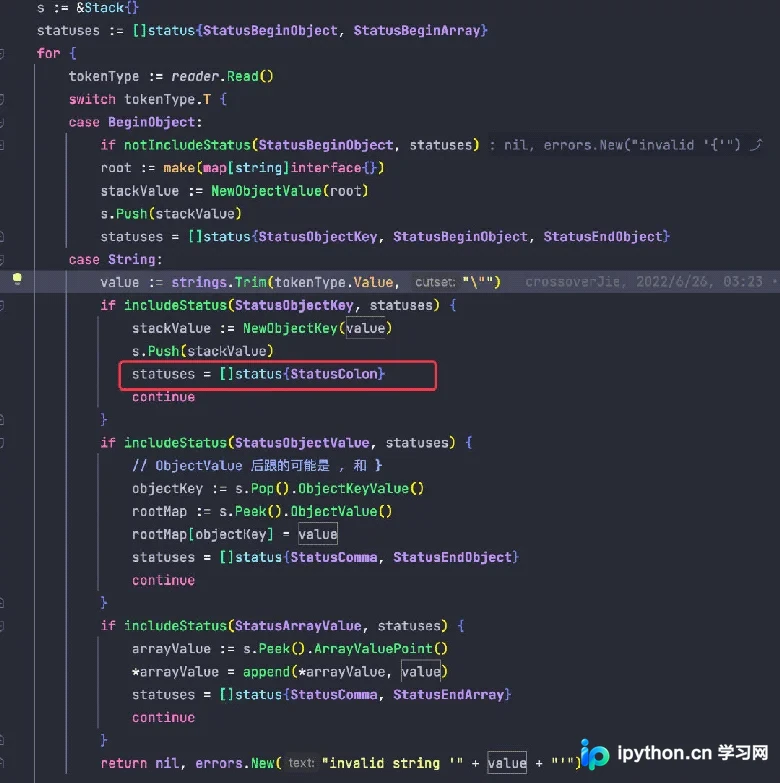
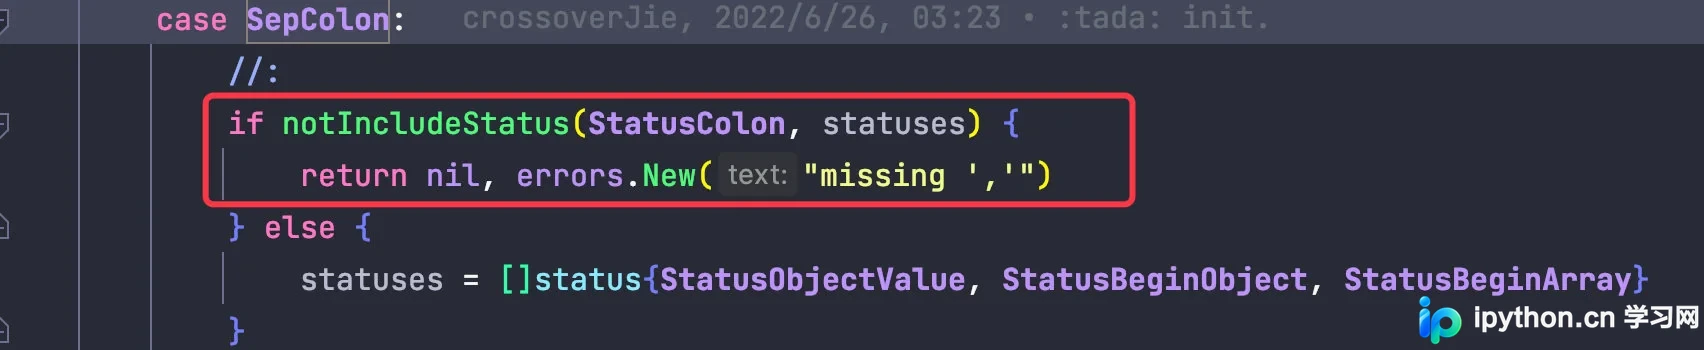
这里的状态集是一个动态的集合。例如,解析完冒号后,下一个 Token 可能是值的开始、一个新对象的开始或新数组的开始,因此需要综合判断后续状态。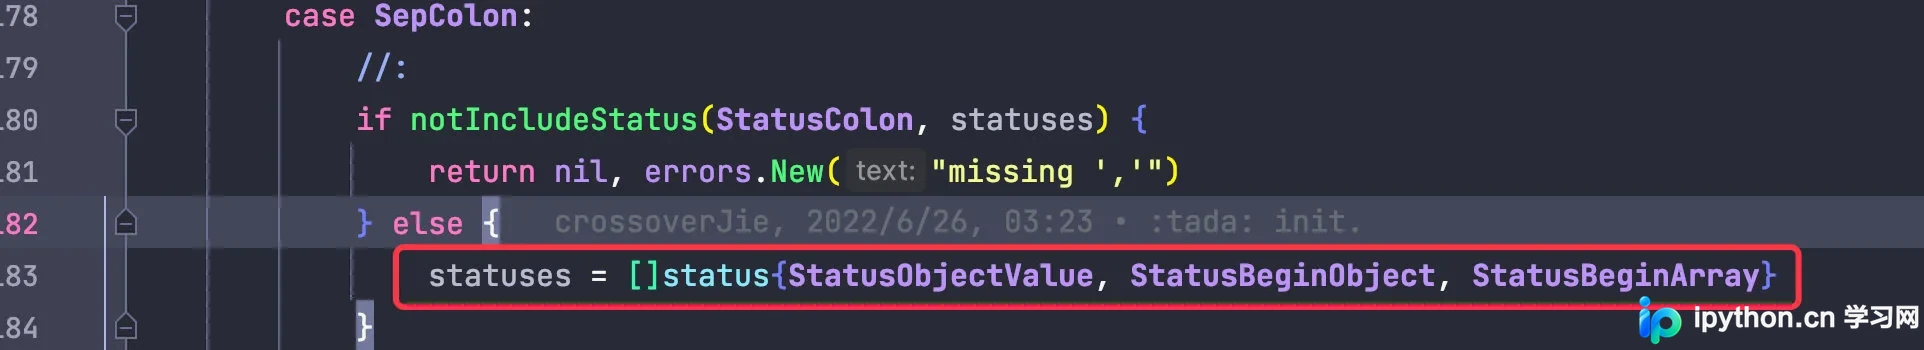
递归下降算法优化
纯基于栈的状态跳转虽然在逻辑上可行,但随着嵌套层数增加,条件分支会变得极其复杂且难以维护。例如,BeginArray 之后可能有四种情况(值、对象、数组结尾等)。为了提升代码的可读性和健壮性,通常会引入递归下降算法(Recursive Descent Parsing)。
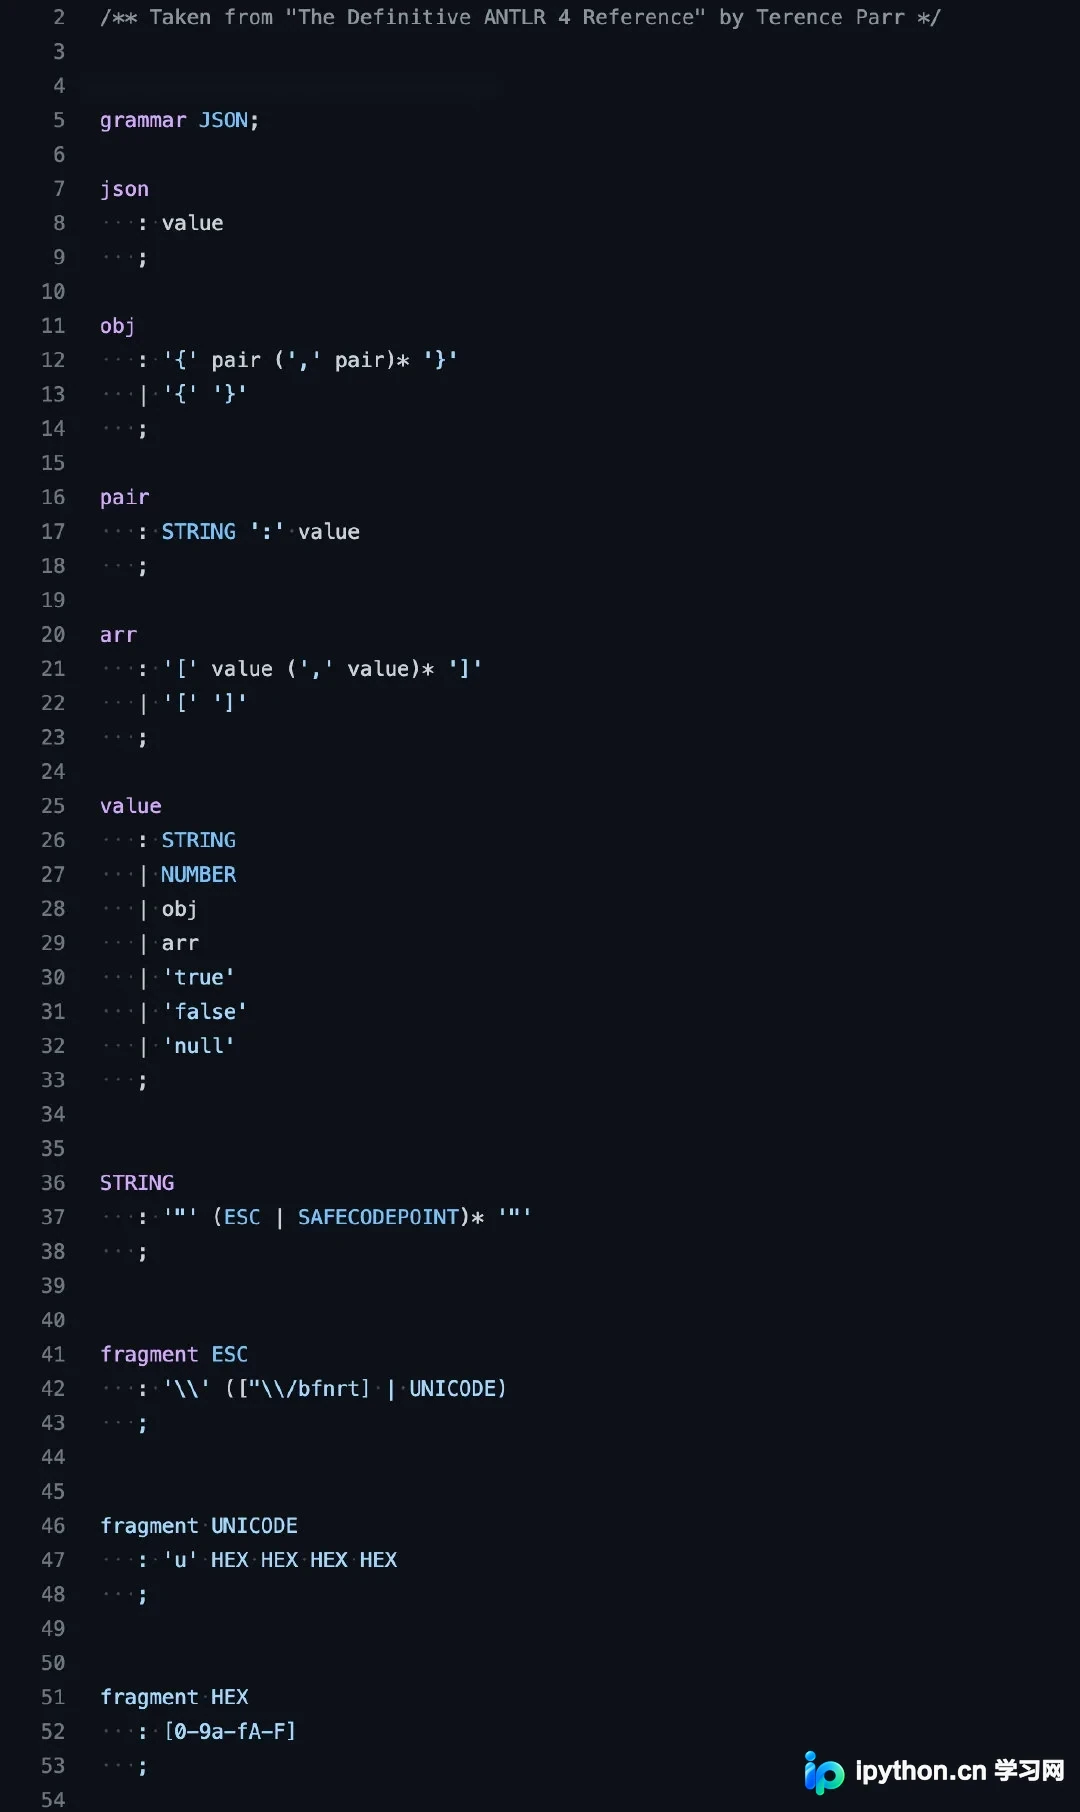
这种方法依据 JSON 的文法规则编写递归函数。例如,定义一个 parseValue() 函数,它会根据 Token 的类型递归调用 parseString(), parseObject() 等。这种方式不仅直观,而且能有效避免遗漏边界条件。
总结
本文展示了如何通过有限的代码量,从零构建一个功能完备的 JSON 解析器。这一过程涵盖了编译原理前端的核心技术:词法分析(DFA 状态机转换)与语法分析(栈结构与递归下降)。虽然在性能上可能与高度优化的官方库存在差距,但它是理解数据结构与编译器设计原理的优秀实践。
以上就是Go语言用八百行代码实现一个JSON解析器的详细内容,更多关于Go语言实现JSON解析器的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















