


C#正则表达式(Regex)过滤提取内容的实战指南

在处理海量文本或网页数据时,手动查找特定信息效率极低。本文演示如何利用C#中的 Regex(正则表达式)类,快速从字符串或文件流中过滤并提取符合特征的内容,掌握核心匹配规则与循环输出技巧。
准备环境与基本原理
正则表达式的核心作用是对文本数据进行高效的检索与匹配。在编程领域,面对百万级的文字量,人工逐一搜索几乎不可能完成,而正则表达式可以通过定义特定的“匹配规则”瞬间定位目标。
在C#中使用正则表达式,首先需要引入对应的命名空间:
using System.Text.RegularExpressions;实现步骤:从读取到提取
第1步:读取源文本内容
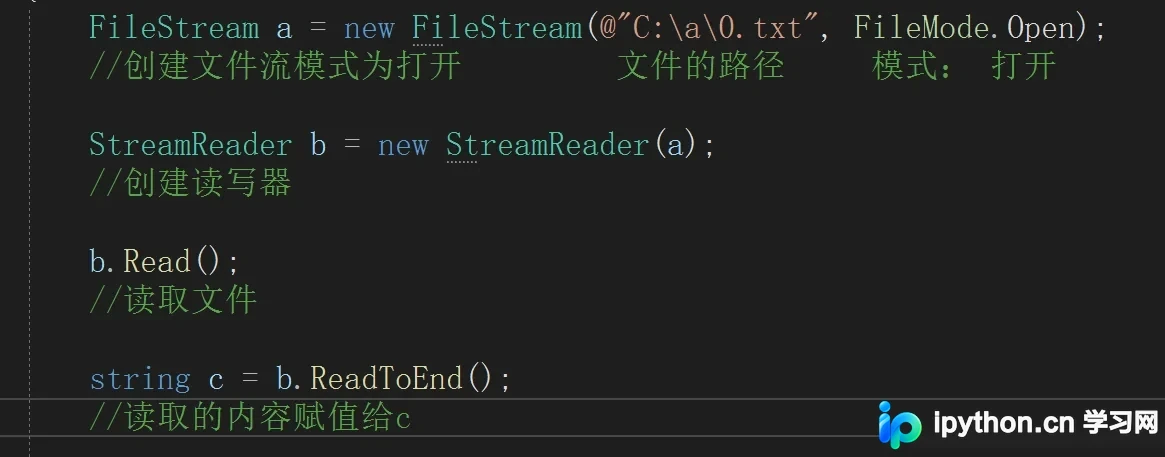
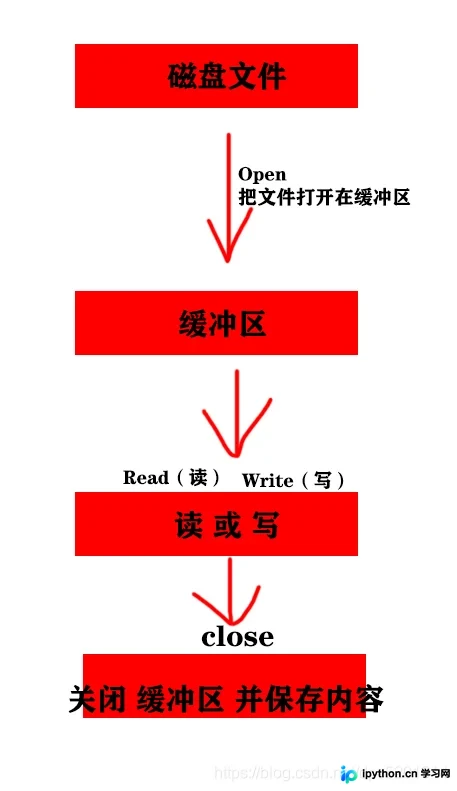
无论是处理内存中的字符串还是外部文件,第一步都是将待处理的数据加载到程序中。若涉及文件操作,需先将文件打开在缓冲区中,以便进行后续读写。
这种缓冲区的概念有助于理解数据的流向:数据来源 → 缓冲区 → 正则引擎处理 → 结果输出。
第2步:创建正则表达式模式
这是最关键的一步。我们需要定义一个字符串(Pattern),告诉程序我们需要什么样的数据。例如,如果需要提取文本中的所有数字,可以使用以下两种写法之一:
- [
\d] :匹配任意单个数字字符(0-9)。 - [
0-9] :同理,匹配0到9之间的数字。
常见的部分匹配规则如下:
- [
\d] :只需数字 0-9。 - [
\D] :非数字字符(大写D表示排除)。 - [
^\d] :除了数字以外的所有内容(注意位置含义)。 - [
\w] :字母 (a-z, A-Z)、数字、下划线及部分汉字。 - [
a-c] :指定范围内的字符,如 a 到 c 的所有单词。 - [
a|b] :只需 a 或 b。
在本例中,我们的目标是找出文本中的5个特定数字(2, 4, 8, 9, 6),因此我们使用的匹配模式为 [\d]。
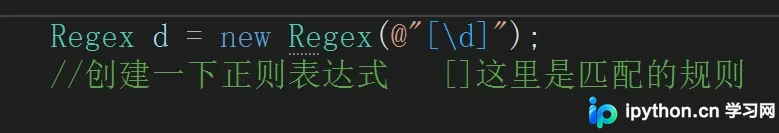
第3步:执行匹配并输出结果
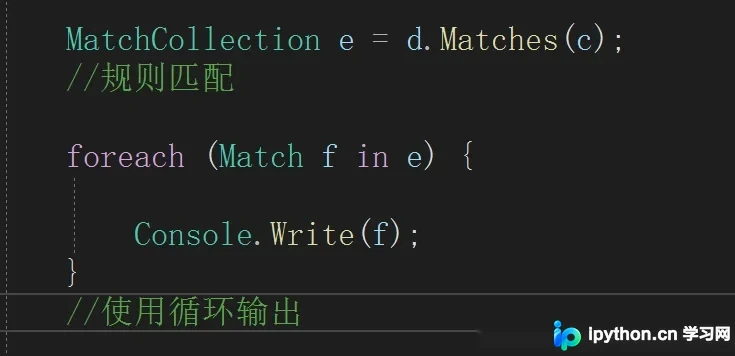
利用 Regex.Matches() 方法可以在文本中找到所有匹配项,返回类型为 MatchCollection。我们可以通过 foreach 循环遍历每一个匹配结果。
提示:在循环中如果不确定具体数据类型,建议使用 var 关键字,编译器会根据上下文自动推断类型(通常结果为 string 类型)。
// 假设 textContent 包含了需要处理的完整文本字符串
string pattern = "[\\d]"; // 匹配规则
MatchCollection results = Regex.Matches(textContent, pattern);

// 遍历所有匹配到的数字
foreach (var item in results)
{
    Console.WriteLine(item.ToString()); // 打印每个匹配的数字
}
运行上述代码后,控制台将按顺序输出所有找到的数字。
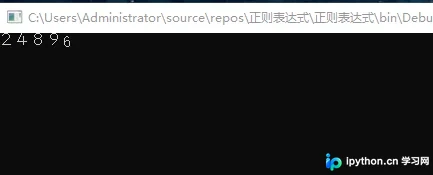
进阶应用:过滤不符合条件的字符
除了提取,有时我们需要从一个长字符串中剔除不符合要求的字符,保留纯净的目标数据。以下示例展示了如何筛选字符串中的非十六进制字符,最终得到一个只包含有效十六进制数的新字符串。
string str = "abcdsefghias12321312"; // 原始目标字符串
string pattern = "[A-Fa-f0-9]";      // 十六进制字符匹配规则
string strRet = "";

// 获取所有匹配的十六进制字符
MatchCollection results = Regex.Matches(str, pattern);

// 拼接有效字符
foreach (var v in results)
{
       strRet += v.ToString();
}
// 此时 strRet 仅包含 "aabcdefas12321312"
以上就是C#中正则表达式(Regex)过滤提取内容的基本详细内容,更多关于C# Regex数据处理与过滤的代码资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















