


MySQL查询性能优化:使用optimizer_trace分析索引选择

在 MySQL 性能调优中,EXPLAIN 常用来查看执行计划和是否命中索引,但往往无法解释“为什么”优化器选择了某个特定的索引,特别是在参数化查询导致不同传参走不同索引的场景下。本文介绍如何使用 optimizer_trace 工具深入追踪优化器的内部决策逻辑,通过分析各索引的成本(Cost)和扫描行数,精准定位索引选择的根本原因。
什么是 optimizer_trace?
optimizer trace(优化器追踪) 是 MySQL 提供的一个诊断工具,能够记录优化器生成执行计划的详细全过程。它不仅展示最终结果,还包含访问表的方法、开销计算、转换逻辑以及各种备选方案的对比数据。
第1步:查看 optimizer_trace 配置
首先,确认当前数据库中相关变量的状态:
show variables like '%optimizer_trace%';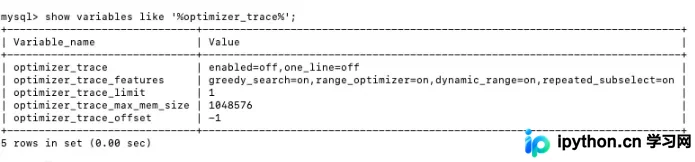
输出参数详解:
optimizer_trace:主配置项。值为enabled=on表示开启,off表示关闭;one_line控制是否将JSON压缩显示为一行。optimizer_trace_features:包含贪心搜索、范围优化等可选特性开关。optimizer_trace_limit:追踪最大显示数目,默认仅为1条。optimizer_trace_max_mem_size:追踪占用的最大内存容量。optimizer_trace_offset:指定从第几条追踪记录开始显示。
第2步:手动开启 optimizer_trace
该功能默认处于关闭状态。可以在会话级别临时开启以进行排查:
SET optimizer_trace="enabled=on";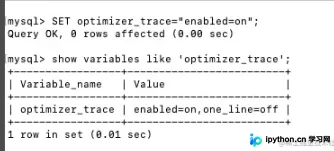
第3步:复现并执行目标 SQL
为了说明优化器在复杂条件下的行为,我们创建一个测试表并插入少量数据:
CREATE TABLE `user` (
  `id` int NOT NULL AUTO_INCREMENT COMMENT '主键',
  `name` varchar(100) NOT NULL COMMENT '姓名',
  `gender` tinyint NOT NULL COMMENT '性别',
  PRIMARY KEY (`id`),
  KEY `idx_name` (`name`),
  KEY `idx_gender_name` (`gender`,`name`)
) ENGINE=InnoDB COMMENT='用户表';表中存在两个索引:(name) 单列索引和 (gender, name) 联合索引。先执行一个符合预期的查询:
select * from user where gender=0 and name='一灯';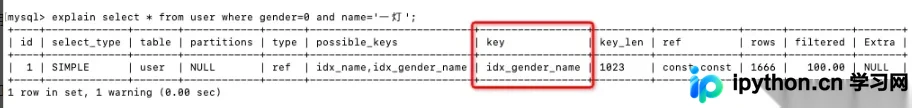
由于 WHERE 条件同时包含 gender 和 name,优化器正确优先使用了联合索引 (gender, name)。
关键异常现象
尝试将查询参数替换为另一个值,观察执行情况:
select * from user where gender=0 and name='张三';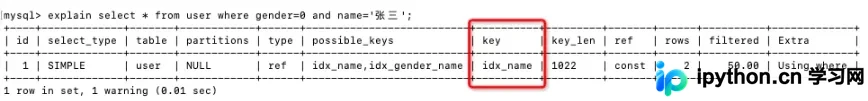
结果显示,同一条 SQL 因为传参内容的统计分布差异,竟然改用了 (name) 索引。在这种单语句多路径切换的情况下,仅靠 EXPLAIN 很难直观判断出底层取舍的逻辑。此时需要借助 optimizer_trace 找出真相。
第4步:获取并分析 Trace 信息
再次执行上述引发问题的 SQL 后,查询跟踪结果:
SELECT * FROM information_schema.OPTIMIZER_TRACE;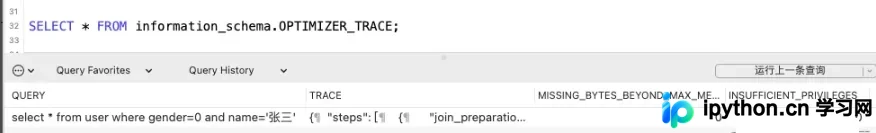
返回结果包含四列,其中重点查看 TRACE 字段中的 JSON 数据:
QUERY:原始执行的 SQL 语句。TRACE:详细的优化过程分析,重点关注此处的结构。MISSING_BYTES_BEYOND_MAX_MEM_SIZE:当追踪内容超过内存限制时,被截断的剩余部分会显示在此。INSUFFICIENT_PRIVILEGES:权限状态。0 表示有权查看,1 表示无权限。
深入解析 TRACE JSON 结构中的 range_scan_alternatives 节点,它详细记录了所有候选索引的评估过程:
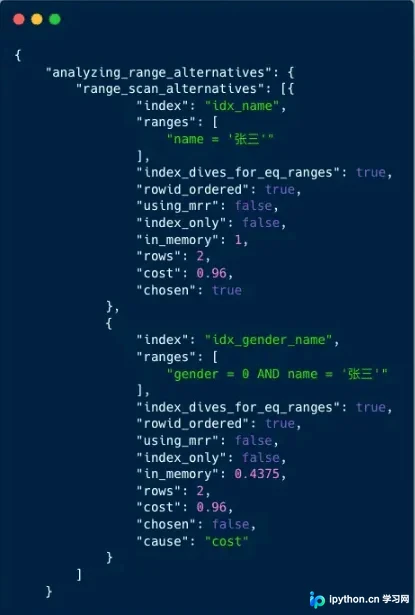
主要输出字段含义:
index:参与评估的索引名称。rows:预估扫描行数。cost:预估总成本,数值越小代表优化器越倾向于选择。chosen:布尔值,标记是否最终被选定。cause:如果未被选中,说明具体原因(如 cost 过高)。ranges:实际使用的索引扫描范围条件。index_dives_for_eq_ranges:是否启用了利用主键或唯一索引进行“潜水”优化的逻辑。rowid_ordered:查询结果是否需要按主键排序。using_mrr:是否启用 MRR (Multi-Range Read)。index_only:是否为覆盖索引查询(无需回表)。in_memory:内存消耗大小。
结论
在上述案例中,通过 TRACE 数据可以看出,虽然联合索引理论覆盖度更高,但针对特定参数组合,单列索引 (name) 的整体预估成本(Cost)远低于联合索引。因此优化器果断放弃了联合索引。这便是“用错”索引的根本原因。
掌握了 optimizer_trace 的分析方法,就能彻底看清优化器的黑盒决策过程。这对于处理复杂的参数化查询优化、临时的索引选型争议具有极高的实战价值。
以上就是 MySQL 查询性能优化中使用 optimizer_trace 分析索引选择的详细内容,更多关于 MySQL 链路追踪排查的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















