


C语言内存存储详解:原码补码、大小端与浮点数格式

C语言中不同数据类型在内存中的存储方式直接决定了程序的运行结果与底层行为。本文详细解析整型的原码、反码、补码存储及其对加减法运算的影响,阐述大端与小端字节序的差异及检测方法,并依据IEEE 754标准深入剖析浮点数在内存中的特殊编码规则,帮助开发者理解变量存储的本质。
数据类型的根本意义
在C语言中,内置类型如 char、short、int、long、float 和 double 的定义主要包含两层核心含义:
- 空间开辟:确定该类型在内存中占据的字节数,从而限定数值的表达范围。
- 解读视角:指定编译器如何解析这片二进制内存。同样的二进制串,被解释为整数或浮点数时,代表的数值截然不同。
整型数据的内存存储:补码的优势
计算机内部对整型数据的存储并非直接使用“原码”,而是采用补码(Two's Complement)。要理解这一点,需先明确三种二进制表示形式:
- 原码:直接将数值转换为二进制,最高位为符号位(0正1负)。
- 反码:原码的符号位不变,其余各位按位取反。
- 补码:反码加 1。
为什么使用补码? CPU仅配备加法器,使用补码可以将减法运算转化为加法,同时统一处理符号位与数值域,无需额外的硬件电路来支持不同的运算逻辑。
第1步:验证整型存储的补码形态
目的:观察编译器在内存中实际存放的整型二进制值。
操作:声明一个正值和一个负整型变量,并在调试器中查看其内存地址对应的十六进制值。
#include

int main()
{
    int a = 20;
    int b = -10;
    return 0;
} 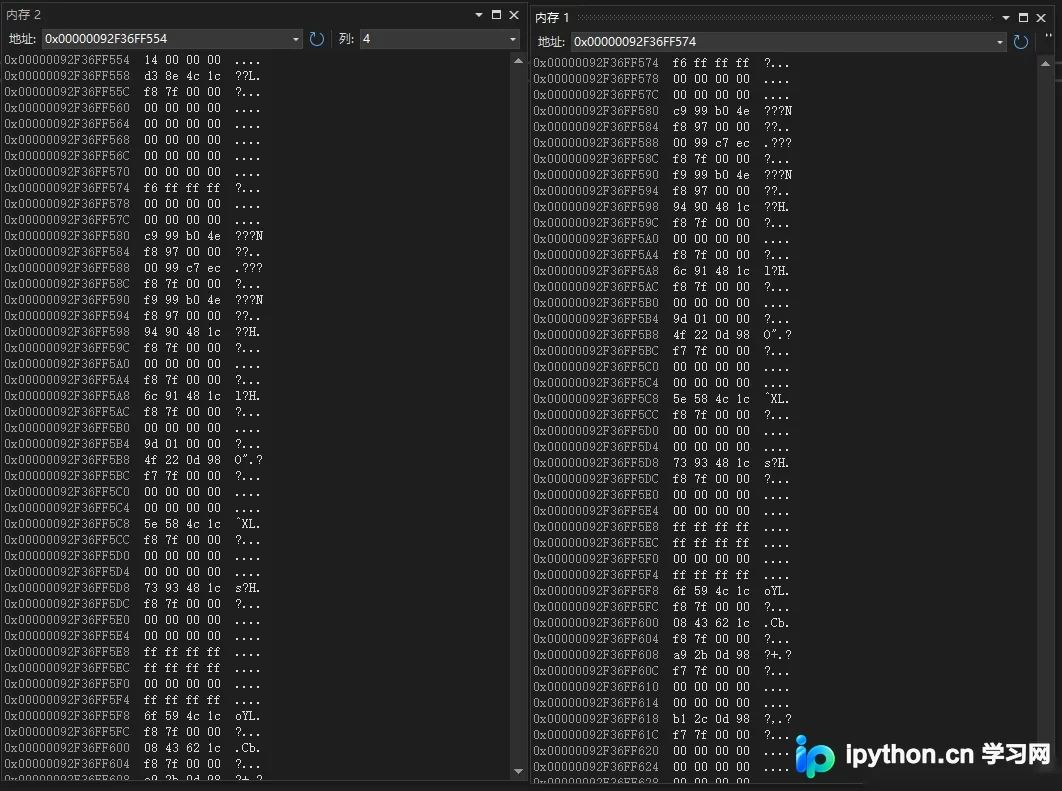
以 -10 为例进行还原:
- 原码:
10000000 00000000 00000000 00001010 - 反码:
11111111 11111111 11111111 11110101 - 补码:
11111111 11111111 11111111 11110110
将补码转换为十六进制即为 ff ff ff f6,这与调试器显示的值一致,证实了整型在内存中确实存储的是补码。
字节序问题:大端与小端
当数据长度大于1字节(如 int 占4字节)时,多字节的存储顺序成为关键。这里区分高位字节(数值大的部分)和低位字节(数值小的部分)。
- 大端模式(Big-Endian):数据的高位字节保存在内存的低地址处,低位字节保存在高地址处。
- 小端模式(Little-Endian):数据的低位字节保存在内存的低地址处,高位字节保存在高地址处。主流x86架构通常采用此模式。
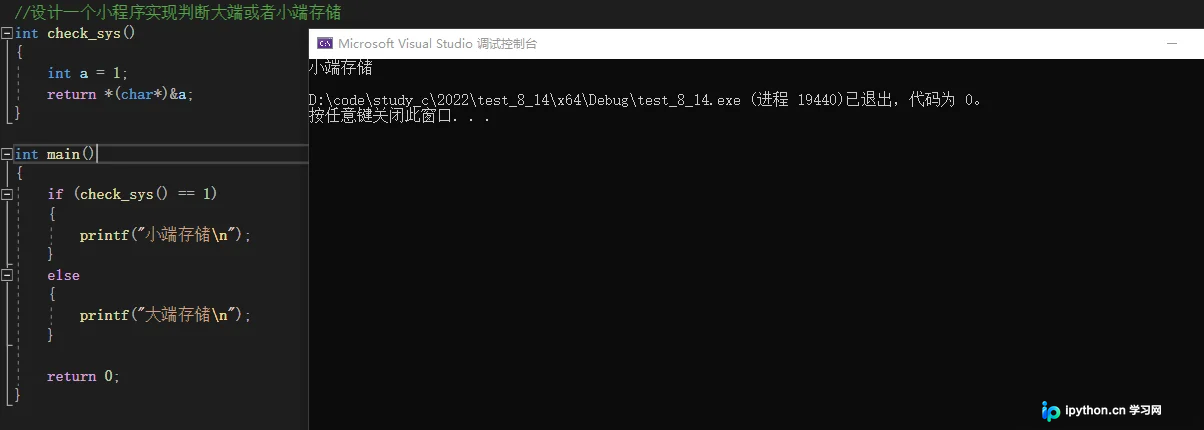
第2步:设计程序检测当前机器字节序
原理:利用联合体(Union)或指针类型强转的特性,访问多字节数据的最低地址单元。若最低地址存的是低位字节,则为小端。
int check_sys()
{
    int a = 1; // 二进制: ...0001, 1是低位
    // *(char*)&a 强制将指向int的指针转为char指针,只取首字节
    return *(char*)&a;
}

int main()
{
    if (check_sys() == 1)
    {
        printf("小端存储\n");
    }
    else
    {
        printf("大端存储\n");
    }
    return 0;
}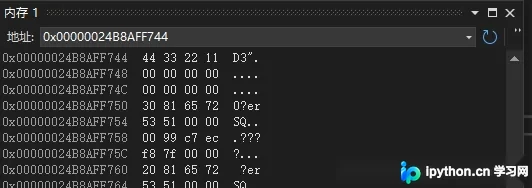
在Visual Studio等常见开发环境中,上述代码输出“小端存储”,因为整数 1 的低位字节被存放在低地址起始位置。对比验证可参考下图所示的内存分布:
浮点数的神秘存储:IEEE 754标准
浮点数在内存中的存储规则与整型完全不同。根据IEEE 754标准,任意二进制浮点数 V 可表示为:
V = (-1)^S * M * 2^E
- S (Sign):符号位。0为正,1为负。
- M (Mantissa):有效数字,范围 [
1, 2)。 - E (Exponent):指数位。
存储细节与特殊规则
- 有效数字 S 的简化:
在存储M时,由于其二进制形式总是1.xxxx...,首位恒为1。因此计算机只保存小数部分.xxxx...,读取时自动加上首位的1。这为32位浮点数节省了一位精度。 - 指数 E 的偏移量:
指数可以是负数,但内存存储需为无符号整数。因此存入时需加上中间数:32位浮点数加127,64位浮点数加1023。
例如:2^10的指数为10,内存中存入10 + 127 = 137。 - E 的全0与全1情况:
- E不全为0且不為1:真实指数 = 存储值 - 127,有效数字前加1。
- E全为0:真实指数为
1-127,有效数字不加1(即0.xxxx),用于表示零或接近零的次正规数。 - E全为1:若有效数字全为0,表示无穷大(±INF)。
第3步:剖析经典笔试题——类型重解释
题目背景:
int n = 9;
float* pFloat = (float*)&n;
printf("%f\n", *pFloat); // 输出 0.000000
*pFloat = 9.0;
printf("%d\n", n);       // 输出 1091567616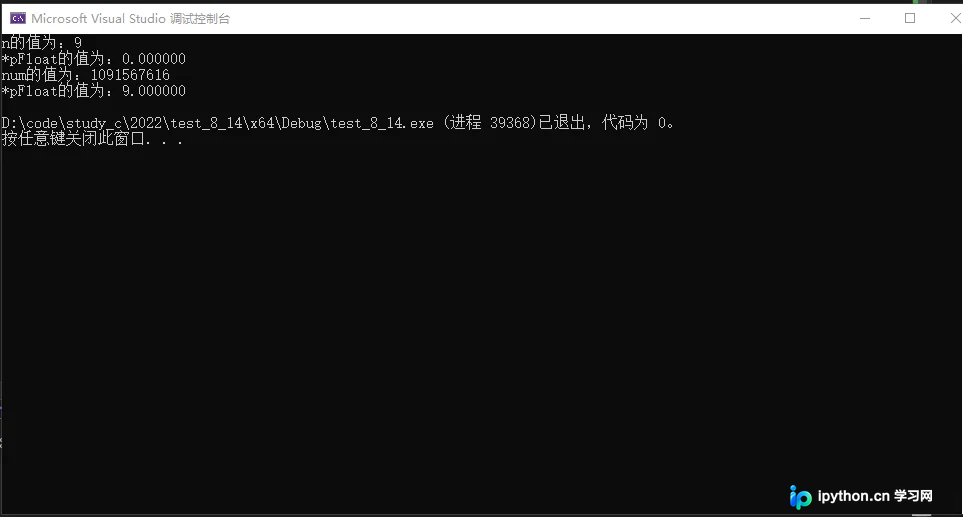
分析第一部分(整型转浮点打印):
整数 9 的补码为 00000000 00000000 00000000 00001001。
当将其按浮点数规则解读时:
- S = 0
- E =
00000000(全0) - M =
000...001001
由于E全为0,指数视为 1-127 = -126,且有效数字不补首位1,结果为极小的非零数,格式化打印即为 0.000000。
分析第二部分(浮点写入后变整型打印):
赋值 *pFloat = 9.0 时,9.0的二进制为 1001.0,即 1.001 * 2^3。
存入内存的规则如下:
- S = 0
- E = 3 + 127 = 130 (
10000010) - M =
001 0000 ...(省略1后的部分)
组合后的32位二进制为:0 10000010 001 0000 ...
转换为十进制整数即为 1091567616。这就是为何同一块内存因类型解读不同而产生巨大差异。
总结
掌握C语言数据的内存存储原理,是进阶高性能编程的基础。从整型的补码运算优势,到大端小端的字节序差异,再到IEEE 754浮点数存储的精妙设计,每一层规则都服务于计算机硬件的效率与标准化。理解这些底层机制,能有效避免类型混合运算中的隐蔽Bug,并为跨平台开发和协议解析提供理论支撑。
以上就是C语言不同类型数据在内存中的存储的详细分析,更多关于C语言基础与底层原理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















