


MySQL COUNT函数使用详解与性能优化指南

本文详细解析MySQL中COUNT函数的多种参数形式及其底层逻辑差异。内容涵盖COUNT(*)、COUNT(1)、COUNT(字段)在NULL值处理上的具体表现,演示DISTINCT去重统计的方法,并提供基于LIMIT 1的海量数据存在性检查优化方案,帮助开发者提升SQL执行效率。
COUNT函数的核心逻辑与参数差异
COUNT是MySQL中最常用的聚合函数之一,主要用于统计数据表的行数或满足特定条件的记录数。许多开发者容易混淆不同参数的行为,特别是在面对NULL值和主键索引时。理解其底层处理机制对于编写正确且高效的查询至关重要。
第1步:统计所有记录数(COUNT * / COUNT 1)
目的:获取表中完整的物理行数,包含所有列值为NULL的行。
入口:任意SELECT语句,无需指定列名。
动作:使用COUNT(*)或COUNT(1)作为聚合参数。
重要参数:引擎层直接扫描索引(InnoDB下通常使用主键索引)。
完成状态:返回表中的总行数,结果不受列值是否为空影响。
在InnoDB存储引擎中,COUNT(1)的执行计划通常一致,因为MySQL Optimizer会将其自动优化为最简化的全表扫描逻辑。两者均统计所有行,无论某一行中其他列的值是否为NULL。
第2步:统计非NULL值的行数(COUNT 字段)
目的:仅统计指定列中不为NULL的记录数量。
入口:SELECT COUNT(列名) ... FROM 表名。
动作:数据库逐行读取该列的值,若值为NULL则跳过累加,若非NULL则计数器+1。
重要参数:指定的列名。若该列为NOT NULL定义,行为等同于COUNT(*);若允许NULL,则排除NULL行。
完成状态:返回该列有效非空数据的行数。
需要注意的是,COUNT(字段)不会统计该列值为NULL的行,但会统计该列为空字符串''的情况。这在业务逻辑中需要特别注意区分“无数据”与“空数据”的概念。
第3步:统计去重后的非NULL行数(COUNT DISTINCT)
目的:去除重复值后,统计唯一非NULL值的数量。
入口:SELECT COUNT(DISTINCT 列名) ...。
动作:内存或磁盘临时排序/哈希去重,忽略NULL值。
重要参数:需去重的列名。若涉及多列如COUNT(DISTINCT col1, col2),只要其中任一列为NULL,该行即被忽略,即使另一列有值。
完成状态:返回消除重复项后的有效唯一记录数。
COUNT实战与常见误区排查
为了准确验证上述逻辑,我们通过构建测试表来观察不同COUNT方式的结果差异。以下是标准的建表与数据插入脚本,注意观察ID为主键,而Name列允许NULL值的情况。
-- MySql统计函数count测试
-- 创建用户表,新增测试数据
CREATE TABLE `user` (
  `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT 'ID主键',
  `name` varchar(64) DEFAULT NULL COMMENT '姓名',
  `sex` varchar(8) DEFAULT NULL COMMENT '性别',
  `age` int(4) DEFAULT NULL COMMENT '年龄',
  `born` date DEFAULT NULL COMMENT '出生日期',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 ROW_FORMAT=DYNAMIC COMMENT='用户表';

INSERT INTO `category`.`user`(`id`, `name`, `sex`, `age`, `born`) VALUES (1, '%张三%', '男', 22, '2022-04-22');
INSERT INTO `category`.`user`(`id`, `name`, `sex`, `age`, `born`) VALUES (2, '李四', '女', 12, '2022-04-01');
INSERT INTO `category`.`user`(`id`, `name`, `sex`, `age`, `born`) VALUES (3, '王小二', '女', 12, '2022-04-28');
INSERT INTO `category`.`user`(`id`, `name`, `sex`, `age`, `born`) VALUES (4, '赵四', '男', 23, '2022-04-28');
INSERT INTO `category`.`user`(`id`, `name`, `sex`, `age`, `born`) VALUES (5, '', '女', 23, '2022-04-28');
INSERT INTO `category`.`user`(`id`, `name`, `sex`, `age`, `born`) VALUES (6, NULL, '女', 60, '2022-04-28');
INSERT INTO `category`.`user`(`id`, `name`, `sex`, `age`, `born`) VALUES (7, NULL, '女', 61, '2022-04-28');

select * from user;

-- 统计数据:7条数据,统计所有的记录(包括NULL)。
select count(*) from user;

-- 统计数据:7条数据,统计不为NULL 的记录。
select count(1) from user;

-- 统计数据:5条数据,COUNT(字段):统计该"字段"不为NULL 的记录,注意是null不是空''字符串
select count(name) from user;

-- 统计数据:5条数据,COUNT(DISTINCT 字段):统计该"字段"去重且不为NULL 的记录。
select count(distinct name) from user;
从测试结果可见:
海量数据下的存在性检查优化
当数据量达到千万级时,使用COUNT()来判断“是否存在”或“有多少条”会产生巨大的性能开销,因为它需要遍历整个索引树进行累加。如果业务目标仅仅是确认数据是否存在,应摒弃COUNT,转而使用带LIMIT限制的查询。
第1步:传统COUNT存在性检查的问题
现象:在500万数据的员工表(emp)上执行
第2步:采用LIMIT 1策略
目的:快速获取一条记录以证明存在性,避免全表/全索引扫描。
入口:SELECT 1 FROM 表名 LIMIT 1。
动作:数据库利用索引找到第一条匹配记录后立即返回,不再继续查找。
重要参数:LIMIT 1。
完成状态:时间降至0.001秒级别,极大提升响应速度。
-- SQL查找是否"存在"
-- 员工表,存在则进行删除
drop table if EXISTS emp;
create table emp(
    id int unsigned primary key auto_increment,
    empno mediumint unsigned not null default 0,
    empname varchar(20) not null default "",
    job varchar(9) not null default "",
    mgr mediumint unsigned not null default 0,
    hiredate datetime not null,
    sal decimal(7,2) not null,
    comn decimal(7,2) not null,
    depno mediumint unsigned not null default 0
);

-- 新增cehsi数据
测试数据:https://blog.csdn.net/m0_37583655/article/details/124383655

-- cahxun
select * from emp ;

-- 时间:1.082s,数据:5000000
explain select count(*) from emp;
id	select_type	table	partitions	type	possible_keys	key	key_len	ref	rows	filtered	Extra
1	  SIMPLE																																				Select tables optimized away

-- 时间:1.129s,数据:5000000
explain select count(1) from emp;
id	select_type	table	partitions	type	possible_keys	key	key_len	ref	rows	filtered	Extra
1	  SIMPLE																																				Select tables optimized away

-- 时间:1.695s,数据:5000000
explain select 1 from emp;
id	select_type	table	partitions	type	possible_keys	key	          key_len	ref	rows	  filtered	Extra
1	  SIMPLE			emp																		idx_emp_depno		3					4981060		100.00	Using index

-- SQL不再使用count,而是改用LIMIT 1,让数据库查询时遇到一条就返回,不要再继续查找还有多少条了,业务代码中直接判断是否非空即可
-- 时间:0.001s,数据:5000000
explain select 1 from emp LIMIT 1;
id	select_type	table	partitions	type	possible_keys	key	          key_len	ref	rows	  filtered	Extra
1	  SIMPLE			emp																		idx_emp_depno		3					4981060		100.00	Using index
如上对比所示,在使用LIMIT 1的情况下,数据库只需定位到第一个符合条件的索引项即可返回,避免了遍历数百万行的开销。在Java/PHP等业务代码中,只需检查查询结果集是否为空即可确定存在性。
阿里Java开发规范与建议
遵循阿里巴巴《Java开发手册》中的SQL规范,可以避免许多常见的性能陷阱与逻辑错误:
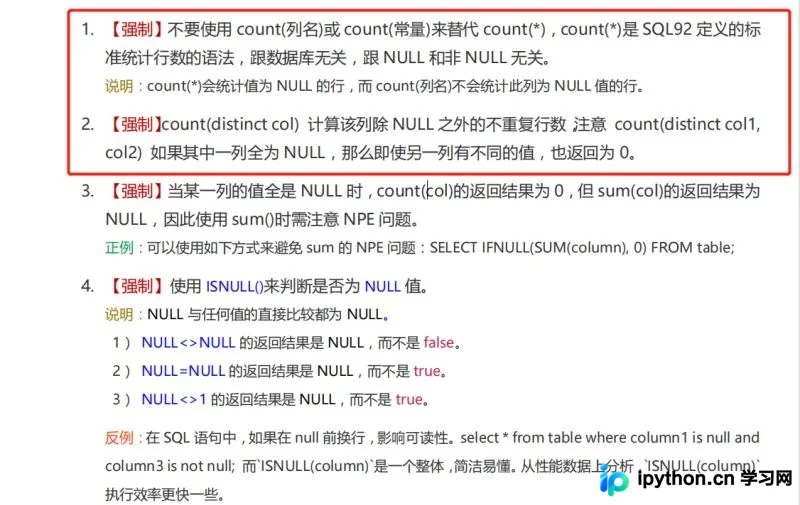
- 【强制】首选COUNT(*):不要使用COUNT(列名)或COUNT(常量)替代COUNT(*)。COUNT(*)是SQL92标准定义的统计行数语法,语义明确,且与数据库类型及列是否可为NULL无关。它专门用于统计整张表的行数。
- 【强制】DISTINCT谨慎使用:COUNT(DISTINCT col)仅计算除NULL之外的不重复行数。特别注意,若使用多列去重如COUNT(DISTINCT col1, col2),只要其中一列全为NULL,即使另一列有不同值,最终结果仍返回0。这在复杂报表统计中极易导致数据偏差。
以上就是MySQL统计函数COUNT的具体使用详解与性能优化方法,更多关于SQL高效查询的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















