


MySQL事务原理及ACID特性详解

数据库事务是保证数据操作安全与一致性的核心机制。以银行转账为例,涉及多个修改操作的完整业务逻辑必须作为一个整体执行,要么全部成功,要么全部失败。本文将详细解析MySQL InnoDB引擎的事务实现原理、手动控制方法以及著名的ACID特性,并探讨不同隔离级别对数据并发读取的影响。
什么是事务
事务本质上是一个完整的业务逻辑单元。为了直观理解,我们可以参考经典的转账场景:从A账户向B账户转账10000元。这一过程包含两个关键步骤:
- A账户余额减去10000元(Update语句);
- B账户余额增加10000元(Update语句)。
这两个更新操作构成了最小的工作单元。如果只完成第一步而第二步失败,A的钱将无故消失;反之亦然。因此,要求这两个语句要么同时成功,要么同时失败,以保障资金的正确性。
注意:在MySQL中,仅有DML(insert、delete、update)语句具备事务属性,DDL和DCL等其他类型语句通常不纳入事务管理范畴。事务的本质就是确保多条DML语句能够同时成功或同时失败。
事务是如何做到同时成功失败的
InnoDB存储引擎通过引入一组专门用于记录事务性活动的日志文件来实现上述功能。其工作原理如下:
- 记录操作:在事务执行期间,每一条DML操作的数据变更都会先写入“事务性活动的日志文件”。此时数据尚未彻底持久化到具体的数据表中。
- 提交事务(Commit):当用户确认所有操作无误后,执行提交。此时系统会清空事务日志文件,并将数据彻底持久化到数据库表中。提交标志着事务以全部成功的方式结束。
- 回滚事务(Rollback):若发现错误需撤销,则执行回滚。系统将依据日志撤销之前所有的DML操作,并清空事务日志文件。回滚标志着事务以全部失败/撤销的方式结束。
如何提交回滚事务
SQL提供了明确的指令来控制事务流程:
- 提交事务:
commit; - 回滚事务:
rollback;
第1步:了解MySQL默认的事务行为
MySQL默认开启“自动提交”模式。这意味着每执行一次DML语句,系统会自动执行一次commit;。如果需要在一个业务逻辑中包含多条DML语句并使用rollback进行统一回滚,必须先关闭自动提交,即显式开启事务:start transaction;
第2步:演示回滚事务的操作
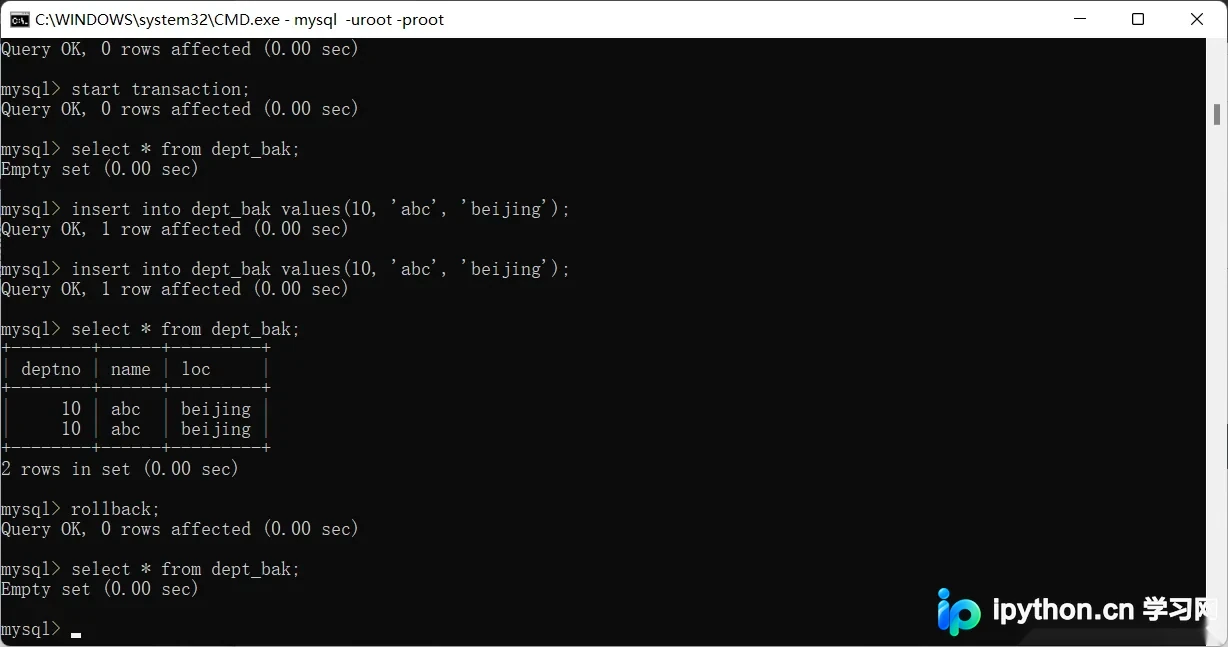
回滚只能撤销上一次提交点之前的操作。以下示例展示了如何开启事务、插入数据并进行回滚:
mysql> start transaction;
Query OK, 0 rows affected (0.0 sec)
mysql> select * from dept_bak;
Empty set (0.0 sec)
mysql> insert into dept_bak values(10, 'abc', 'beijing');
Query OK, 1 row affected (0.0 sec)
mysql> insert into dept_bak values(10, 'abc', 'beijing');
Query OK, 1 row affected (0.0 sec)
mysql> select * from dept_bak;
+--------+------+---------+
| deptno | name | loc     |
+--------+------+---------+
|     10 | abc  | beijing |
|     10 | abc  | beijing |
+--------+------+---------+
2 rows in set (0.0 sec)
mysql> rollback;
Query OK, 0 rows affected (0.0 sec)
mysql> select * from dept_bak;
Empty set (0.0 sec)
操作结果显示,尽管中间插入了两条记录,但执行rollback后查询为空,证明数据被完全撤销。
第3步:演示提交事务的操作
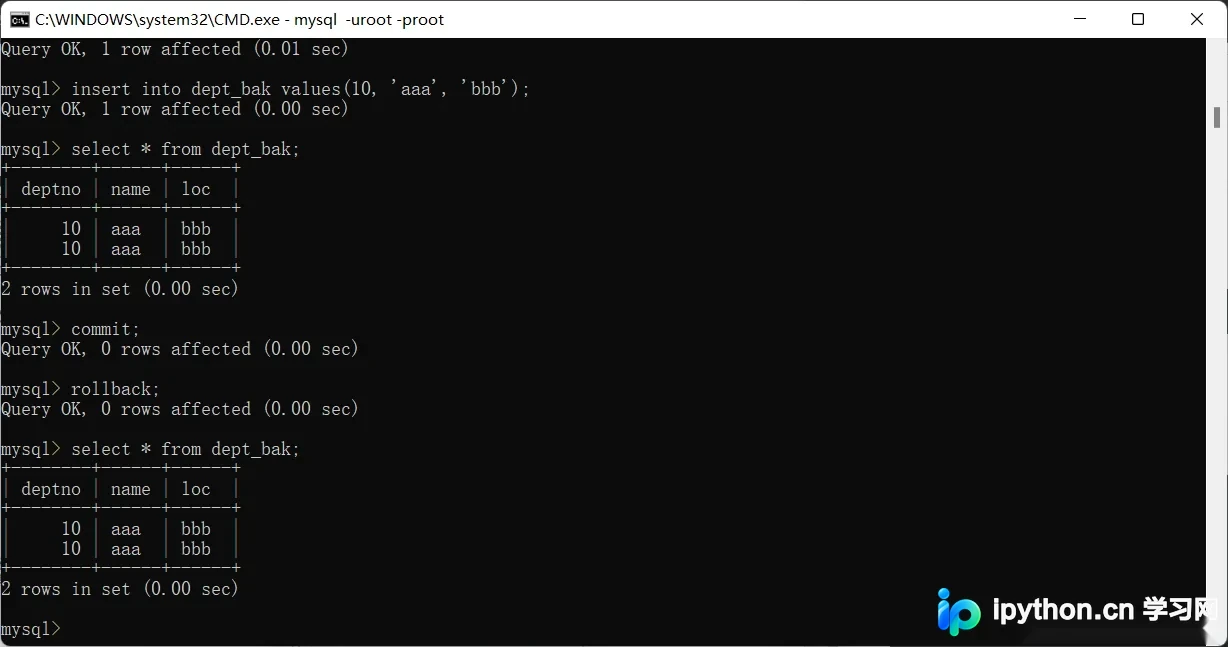
当数据验证无误后,使用commit;将其永久保存。后续再尝试回滚将无法还原数据:
mysql> select * from dept_bak;
Empty set (0.0 sec)
mysql> insert into dept_bak values(10, 'aaa', 'bbb');
Query OK, 1 row affected (0.01 sec)
mysql> insert into dept_bak values(10, 'aaa', 'bbb');
Query OK, 1 row affected (0.0 sec)
mysql> select * from dept_bak;
+--------+------+------+
| deptno | name | loc  |
+--------+------+------+
|     10 | aaa  | bbb  |
|     10 | aaa  | bbb  |
+--------+------+------+
2 rows in set (0.0 sec)
mysql> commit;
Query OK, 0 rows affected (0.00 sec)
mysql> rollback;
Query OK, 0 rows affected (0.00 sec)
mysql> select * from dept_bak;
+--------+------+------+
| deptno | name | loc  |
+--------+------+------+
|     10 | aaa  | bbb  |
|     10 | aaa  | bbb  |
+--------+------+------+
2 rows in set (0.0 sec)
可以看到,执行完commit后再次rollback,数据库中依然保留着刚才插入的两条数据。
事务的4个特性(ACID)
可靠的事务必须具备以下四个特性:
- A(Atomicity)原子性:说明事务是不可分割的最小工作单元,要么都做,要么都不做。
- C(Consistency)一致性:所有事务操作完成后,数据必须处于一种逻辑上正确的状态。例如转账前后,两个账户的资金总和应保持不变。
- I(Isolation)隔离性:多个事务并发执行时,彼此之间具有一定的隔离作用,互不干扰。
- D(Durability)持久性:事务一旦提交,对数据的修改就是永久性的,即使系统发生故障(如断电),数据也不会丢失。
事务的隔离性与隔离级别
在多用户并发访问数据库时,隔离性决定了事务间互不干扰的程度。MySQL定义了四个隔离级别,级别越高安全性越好,但性能开销也越大:
1. 读未提交(Read Uncommitted)
这是最低级别的隔离。事务A可以读取到事务B尚未提交的最新数据。
- 风险:会导致脏读(Dirty Read)现象,即读到的是其他事务还没改好甚至最终不要的数据。
2. 读已提交(Read Committed)
事务A只能读取到事务B已经提交后的数据。
- 优点:解决了脏读问题。
- 风险:存在不可重复读的问题。即在同一个事务中,第一次读取到的数据行数(假设为3行)与稍后第二次读取的数据行数(因其他事务提交了新增导致变为4行)不一致,导致数据不一致感。
3. 可重复读(Repeatable Read)
MySQL的默认隔离级别。事务A开启后,无论执行多久,在该事务内部每次读取到的数据都是事务刚开始时的快照数据。
- 优点:解决了不可重复读问题,保证了同一事务内数据的一致性。
- 风险:理论下仍可能存在幻影读(Phantom Read),即事务A两次查询结果集的大小可能因为其他事务插入新数据而不同,但在MySQL的默认实现(MVCC+Next-Key Lock)下,极大程度抑制了此问题。
4. 序列化/串行化(Serializable)
这是最高的隔离级别,效率最低。
- 原理:强制事务排队执行,不能并发。
- 优点:彻底解决了脏读、不可重复读和幻影读,每次读取的都是最真实的物理数据。
以上就是关于MySQL事务原理及ACID特性的详细内容,更多关于MySQL事务机制与优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















