


C语言数据结构:顺序栈与链栈实现详解

栈是一种运算受限的线性表,遵循“后进先出”(LIFO)原则。在C语言学习中,熟练掌握其顺序存储(基于数组)和链式存储(基于链表)的实现是数据结构的重点。本文将结合具体代码,详细解析这两种结构在初始化、入栈、出栈及边界处理上的逻辑差异。
学习目标
理解栈的核心特性及其在实际计算中的应用场景,掌握以下关键点:
- 清晰界定栈顶(Top)、栈底(Bottom)与空栈的概念。
- 区分并实现顺序栈(预分配内存)与链栈(动态分配内存)的结构。
- 掌握进栈(Push)与出栈(Pop)操作的底层逻辑及状态检测(上溢/下溢)。
栈的基本概念
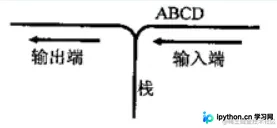
栈是限定仅在表尾进行插入和删除操作的线性表。这种受限性使得栈的操作具有严格的单向性:
- 栈顶:允许进行插入(进栈)和删除(出栈)的一端。
- 栈底:不允许操作的另一端。
- LIFO 原则:栈元素遵循
Last In First Out(后进先出)。就像洗盘子或叠放书脊一样,最后放入的元素必须最先取出。
顺序栈(Sequential Stack)实现
顺序栈利用一段连续的内存空间(通常为一维数组)来存储数据元素,使用整型变量 top 作为栈顶指针指示当前位置。
第1步:定义结构与初始化
首先需要定义栈的数据类型,包括用于存储数据的数组指针和记录栈顶位置的索引。初始化时,需要为数组动态分配内存,并将 top 置为 0(表示初始为空栈)。
#include <stdio.h>
#include <stdlib.h>

#define MAXSIZE 6 // 定义最大容量

typedef struct {
    int *data;  // 存储元素的数组指针
    int top;    // 栈顶指针(索引)
} SeqStack;

// 初始化函数
SeqStack initSeqStack() {
    SeqStack s;
    s.data = (int *)malloc(MAXSIZE * sizeof(int));
    if (!s.data) {
        printf("内存分配失败!\n");
        exit(0);
    }
    s.top = 0; // 初始栈顶为0
    return s;
}
第2步:判断栈空与栈满
在进行入栈前检查是否“上溢”(Full),出栈前检查是否“下溢”(Empty),这是防止程序崩溃的关键。
// 判断栈是否为空
int isEmpty(SeqStack s) {
    return s.top == 0;
}

// 判断栈是否已满
int isFull(SeqStack s) {
    return s.top == MAXSIZE;
}
第3步:进栈(Push)与出栈(Pop)
进栈:将新元素存入当前 top 指向的位置,随后 top 自增。如果栈已满,则无法执行此操作。
出栈:top 先自减,再读取该位置的值并返回。如果栈已空,说明无元素可取,即发生“下溢”错误。
// 进栈操作
void push(SeqStack *s, int value) {
    if (isFull(*s)) {
        printf("栈满,无法进栈!\n");
        return;
    }
    s->data[s->top] = value;
    s->top++;
}

// 出栈操作
int pop(SeqStack *s) {
    if (isEmpty(*s)) {
        printf("栈空,无法出栈!\n");
        return -1; // 根据需求定义错误码
    }
    s->top--;
    return s->data[s->top];
}
第4步:获取栈顶元素(Get Top)
与出栈不同,Get Top 仅查看不移动栈顶指针。由于 C 语言数组从 0 开始编号,当 top=N 时,最后一个有效元素的索引为 N-1。
int getTop(SeqStack s) {
    if (isEmpty(s)) {
        printf("栈空!\n");
        return -1;
    }
    return s.data[s.top - 1];
}
链栈(Linked Stack)实现
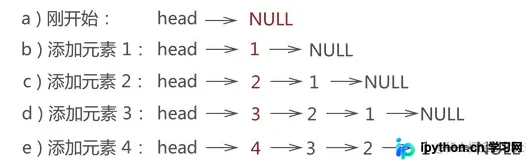
链栈采用单链表结构实现,通常在链表头部作为栈顶。这样做的好处是不像顺序栈那样需要预先固定容量,而是利用系统的动态内存管理,理论上只受限于系统可用内存。
第1步:定义链栈节点
链栈节点包含数据域和指向下一个节点的指针域。头指针 head 指向栈顶的第一个元素。
typedef struct Node {
    int data;
    struct Node *next;
} LNode, *LinkStack;
第2步:链栈的进栈与出栈
由于是在链表头部操作,进栈类似于头插法,出栈则是移除首元结点,两者的时间复杂度均为 O(1)。
// 进栈(头插法)
void push(LinkStack *stack, int val) {
    LNode *newNode = (LNode *)malloc(sizeof(LNode));
    newNode->data = val;
    newNode->next = (*stack)->next;
    (*stack)->next = newNode;
}

// 出栈
int pop(LinkStack stack) {
    if (stack->next == NULL) {
        printf("栈空!\n");
        return -1;
    }
    LNode *temp = stack->next;
    int val = temp->data;

    // 修改头指针的指向
    stack->next = temp->next;
    free(temp); // 释放被弹出节点的内存
    return val;
}
考试要点:手动模拟进出栈序列
在期末或自考考试中,经常会出现要求列出特定输入序列所有可能的输出排列的题目。这类题目不涉及复杂代码,但核心在于严格遵循 LIFO 原则:
- 明确限制条件:只能在入栈过程中选择在任何时刻暂停入栈并开始出栈。
- 不可越级:如果元素 A 已经入栈且尚未出栈,那么位于它后面入栈的元素 B、C... 必须先于 A 出栈。因此,绝对不可能出现“A 进、B 进、B 出、C 进、A 出”这样的逆序错误。
例题演示:输入序列为 A, B, C。求所有合法的出栈序列。
- A进, A出 -> (空栈) -> B进, B出 -> C进, C出 => ABC
- A进, B进, B出, A出 -> (空栈) -> C进, C出 => BAC
- A进, B进, C进, C出, B出, A出 => CBA
- 以此类推,共有5种合法情况(卡特兰数问题的一种表现形式)。
总结
无论是顺序栈还是链栈,其本质都是利用特定的内存布局来实现“后进先出”的逻辑约束。顺序栈适合规模已知且固定的场景,而链栈则在处理不确定长度数据时展现了灵活性。掌握了这两者的C语言底层实现,不仅有助于通过数据结构课程的考核,也为后续学习复杂的树形结构和图算法打下坚实基础。
以上就是C语言顺序栈与链栈实现的详细内容,更多关于C语言数据结构栈的知识请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















