


Java中获取字符串字节长度及按字节截断的方法

在Java开发中,字符串的长度通常指字符数(int),但底层存储、网络传输以及数据库交互往往受限于字节数(Byte)。由于UTF-8等可变长编码的存在,中文等多字节字符会导致字符长度与字节长度不一致。本文将详细说明如何正确计算字符串的字节长度,并介绍如何在需要限制字节数的场景下(如数据库插入)安全地截取字符串。
1. 计算字符串的字节长度
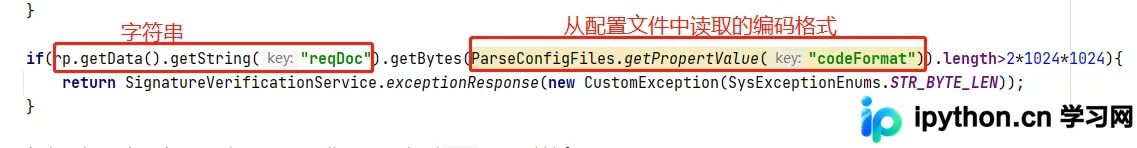
String.length() 返回的是该字符串中的 char 数量,即Unicode字符的个数。如果需要知道该字符串在特定编码下占用的字节大小,最简便且标准的方法是使用 getBytes(Charset) 方法。
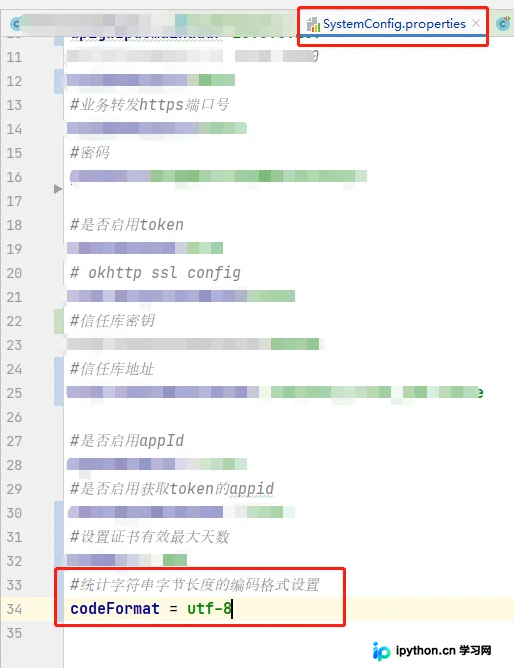
第一步:确定编码格式
在进行转换前,必须明确目标环境使用的编码格式。常见的编码包括 UTF-8(最常见,变长)、GBK/GB2312(中文环境常用)和 ISO-8859-1(拉丁语系单字节)。不同编码下,同一个字符串的字节长度会有显著差异。例如,一个汉字在 GBK 中占用 2 个字节,而在 UTF-8 中通常占用 3 个字节。
第二步:执行转换并获取长度
通过 String.getBytes(Charset charset) 将字符串转换为指定编码的字节数组,随后调用数组的 .length 属性即可得到字节长度。
import java.nio.charset.StandardCharsets;

public class StringSizeExample {
    public static void main(String[] args) {
        String content = "测试不同编码格式的字节长度";

        // 方式一:推荐写法,使用标准类库,无需捕获异常
        int utf8Length = content.getBytes(StandardCharsets.UTF_8).length;
        System.out.println("UTF-8 byte length: " + utf8Length);

        // 方式二:旧版写法,容易抛出 UnsupportedEncodingException
        try {
            int gbLength = content.getBytes("GBK").length;
            System.out.println("GBK byte length: " + gbLength);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}注意:在实际工程中,建议将使用的编码格式配置在配置文件(如application.properties或yml文件)中,并在代码读取后统一应用。这样可以保持代码灵活性,避免因硬编码导致的维护困难。
2. 按指定字节数截取字符串
在某些业务场景中,如向数据库中插入记录或对接固定长度的接口协议,我们需要对字符串进行裁剪,使其严格控制在指定的字节数内。直接使用 substring(int beginIndex, int endIndex) 是基于索引(字符)切分,可能会导致末尾被截断处正好是一个多字节字符的一部分,从而产生乱码或非法编码。
实现逻辑
- 首先将原始字符串按系统默认编码或指定编码转为字节数组。
- 如果字节总长小于设定阈值,直接返回原串。
- 否则,取出前 N 个字节还原为临时字符串。
- 校验这个临时字符串在再次转回字节数组时是否依然满足长度要求。因为截断点可能切在一个汉字的前半部分,导致还原后的新字符串在转回字节时长度发生变化(通常是变小了,因为丢失了半个字,或者需要更精确的处理)。
- 根据情况微调截取位置,确保最终的字节数不超过上限。
参考代码
import java.nio.charset.Charset;
import java.nio.charset.StandardCharsets;

/**
 * 按字节长度截取字符串的安全方法
 * @param content 待处理的字符串
 * @param maxLength 允许的最大字节数
 * @param charset 指定编码,建议使用 StandardCharsets.UTF_8
 * @return 截断后的字符串
 */
public static String getLimitedByteString(String content, int maxLength, Charset charset) {
    if (content == null || content.isEmpty()) {
        return content;
    }

    // 1. 转换为字节数组
    byte[] bytes = content.getBytes(charset);

    // 2. 判断是否超长
    if (bytes.length <= maxLength) {
        return content;
    }

    // 3. 先尝试截取 maxLen 长度的字节转为字符串
    // 这种强制转换可能会导致包含不完整的多字节字符
    String tempString = new String(bytes, 0, maxLength, charset);

    // 4. 关键检查:tempString 再次转回字节数组后的真实长度
    int tempBytesCount = tempString.getBytes(charset).length;

    // 如果实际字节数仍然大于 maxLength,说明上一个循环取到的末尾是个半截字
    // 此时需要向前回溯,直到找到一个完整的字符边界
    if (tempBytesCount > maxLength) {
        // 简单的策略是直接再减去1,但对于某些复杂字符集可能还需递归查找截断点。
        // 此处为了演示核心思想,采取逐次递减的方式寻找正确的截断点。
        // 生产环境中可使用 Pattern 或专门处理CJK字符的逻辑来加速。
        int searchIndex = maxLength - 1;
        while (searchIndex >= 0) {
             // 重新切片验证
             // 更好的做法是从末尾往前找第一个合法的字符起始位
             if (isValidCutPoint(content, searchIndex, maxLength, charset)) {
                 return content.substring(0, searchIndex);
             }
             searchIndex--;
        }
    } else {
        // 如果 tempBytesCount <= maxLength,说明刚才转出来的字符串刚好够塞进 buffer,可以直接用?
        // 不完全是,上面的逻辑里,new String(byte[], off, len) 是固定的。我们实际上应该针对子串做操作。
        return tempString;
    }

    return content;
}

// 辅助校验逻辑:从 end 开始,往回数几个字节能构成完整字节序列
private static boolean isValidCutPoint(String s, int charEndIndex, int limit, Charset c) {
    // 简化版:验证截取到 charEndIndex 的字节数是否等于 limit
    String sub = s.substring(0, charEndIndex);
    return sub.getBytes(c).length <= limit;
}
上述展示的核心在于解决“多字节字符被从中切断”的问题。在真实的 Java 高并发项目中,推荐使用专门的工具类或 Hutool 等第三方库中的 str.trunc 功能,其内部已经封装了完善的 Unicode 字符检测逻辑,能更高效、准确地完成按字节截断的任务。
总结
理解字符(Code Point/Char)与字节(Byte)的区别是处理 Java 字符串的基础。当涉及到文件系统、数据库读写或网络传输时,务必使用 getBytes() 结合确定的 Charset 来计算和验证真正的资源消耗。在需要限制长度的操作中,采用安全的截断算法可以避免因乱码引发的后续程序崩溃或数据存储错误。
以上就是Java计算字符串字节长度与按字节截断的详细内容,更多关于Java字符串处理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















