


C语言桶排序原理、实现与复杂度分析

桶排序是一种非基于比较的线性排序算法,其核心在于将数据划分到有限数量的有序“桶”中,分别排序后合并。在C语言实现中,常利用结构体数组配合单链表来动态管理桶内元素。本文将解析如何利用链表处理桶内插入与排序,提供完整C语言代码示例,并针对时间复杂度与空间开销进行深度评估。
C语言实现桶排序
第1步:理解桶排序映射原理
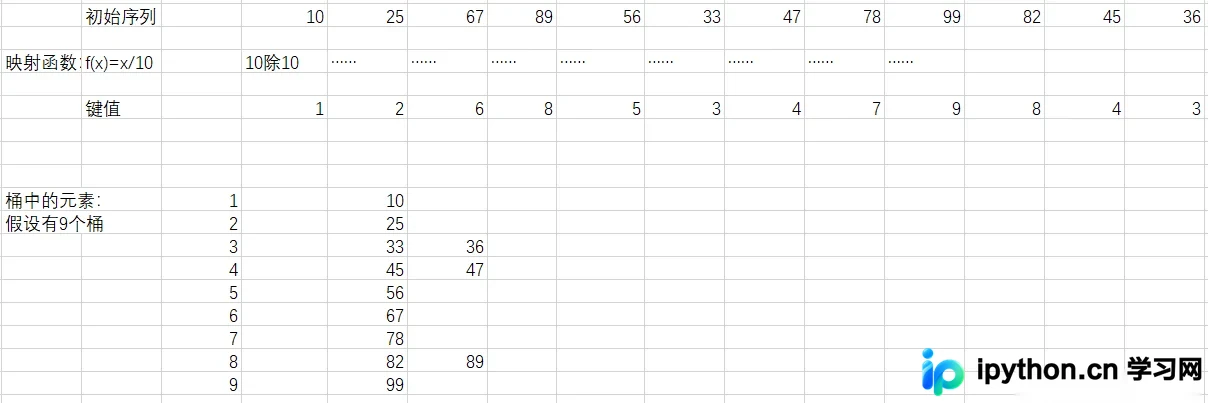
桶排序首先通过一个映射函数(如取模或除法)计算每个元素的键值(Bucket Index),将其分配到对应的桶中。随后对每个桶内的数据进行内部排序,最后按顺序将所有非空桶的元素依次输出,形成最终有序序列。
第2步:掌握核心数据结构设计
在C语言中,由于桶的数量通常是预先确定的固定范围,而每个桶内的元素数量不定,使用“数组+单链表”是最灵活的结构方案。结构体需包含两个关键变量:key存储元素值,next指针指向链表中下一个节点。数组单元即作为各链表的头节点入口。

第3步:分配元素至对应桶中
遍历待排序数组,根据映射规则(例如 index = value / 10)计算索引,创建新节点并加入对应桶的链表中。若该桶目前为空(head->key == 0),直接挂载;若桶内有元素,则需遍历链表找到合适位置进行有序插入,以保持桶内数据的预排序状态。
第4步:执行桶内有序插入逻辑
对于非空桶,为了保证后续无需二次大规模排序,需要在插入时保持升序。具体做法是移动游标直至找到第一个大于当前值的后继节点,并将新节点插入其间。以下是核心插入逻辑的代码片段:
// bucket_table[index] 为当前桶的头节点,node_branch 为新创建的待插入节点
if(p->key == 0){
	// 桶为空,直接将新节点作为链表的第二个元素(头节点仅计数)
	bucket_table[index]->next = node_branch;
	(bucket_table[index]->key)++;
} else{
	// 链表中已有元素,寻找插入位置
	while(p->next!=NULL && p->next->key <= node_branch->key){
		p=p->next;
	}
	// 执行插入操作
	node_branch->next = p->next;
	p->next = node_branch;
	(bucket_table[j]->key)++; // 更新桶内元素计数
}
第5步:完整C语言实现源码
以下代码展示了完整的桶排序流程:包括初始化桶结构、元素分桶、链表内部维护以及最终的打印输出。注意,此示例侧重于演示算法逻辑,实际生产环境中应添加内存释放机制以防止泄漏。
#include <stdio.h>
#include <stdlib.h>

// 定义链表节点结构
typedef struct node *Snode;
typedef struct node{
	int key;
	Snode next;
}BBc;

void sort(int keys[], int keys_size, int bucket_size)
{
	// 1. 为桶表分配空间并初始化
	Snode *bucket_table = (Snode *)malloc(bucket_size*sizeof(Snode));
	for(int i=0; i<bucket_size; i++)
	{
		bucket_table[i] = (Snode)malloc(sizeof(Snode));
		bucket_table[i]->key = 0;
		bucket_table[i]->next = NULL;
	}

	// 2. 分桶并插入
	for(int j=0; j<keys_size; j++)
	{
		Snode node_branch = (Snode)malloc(sizeof(Snode));
		node_branch->key = keys[j];
		node_branch->next = NULL;

		// 计算桶索引 (此处以除以10为例,适用于特定范围的整数)
		int index = keys[j]/10;

		// 简单的边界检查,防止数组越界
		if(index >= bucket_size) index = bucket_size - 1;

		Snode p = bucket_table[index];

		// 插入逻辑
		if(p->key == 0){
			bucket_table[index]->next = node_branch;
			(bucket_table[index]->key)++;
		} else{
			while(p->next!=NULL && p->next->key <= node_branch->key){
				p=p->next;
			}
			node_branch->next = p->next;
			p->next = node_branch;
			(bucket_table[index]->key)++; // 修复原稿中可能存在的变量j混淆错误
		}
	}

	// 3. 依次输出每个桶中的所有元素
	for(int i=0; i<bucket_size; i++){
		for(Snode k = bucket_table[i]->next; k!=NULL; k = k->next){
			printf(" %d ", k->key);
		}
	}
	// 注意:实际使用中需在函数末尾释放所有 malloc 分配的内存
}

int main(){
	int keys[] = {49, 26, 53, 47, 89, 31, 72, 11, 33};
	int keys_size = sizeof(keys)/sizeof(int);
	int bucket_size = keys_size + 2; // 桶数量略大于元素数量
	sort(keys, keys_size, bucket_size);
	return 0;
}
与其他实现方式的对比与进阶分析
思想扩展:基于区间的离散化桶
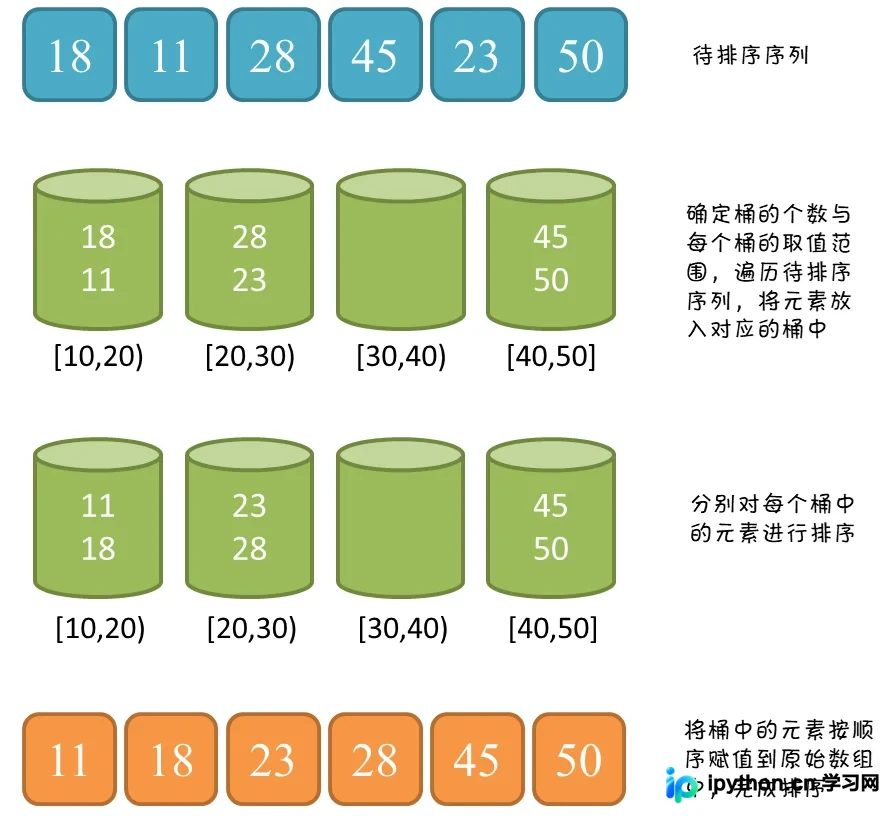
不同于上述基于固定除数的方法,更通用的桶排序是将数据最大值与最小值之间的范围划分为 N 个区间。每个桶负责存放落在该区间的所有数据。这种模式更接近于数学上的映射,能够适应不同取值范围的数组。
复杂度深度剖析
1. 时间复杂度:O(N + C)
主要步骤分为两部分:
- 分配阶段:遍历数组装入桶中,耗时 O(N)。
- 排序阶段:对 M 个桶分别排序。若使用高效的内部排序,平均每个桶有 N/M 个元素,总耗时可近似为 O(M * (N/M)log(N/M))。
综合来看,当桶的数量 M 接近元素数量 N 时,复杂度趋近于线性 O(N)。
2. 空间复杂度:O(N + M)
需要额外的数组和链表节点空间。桶越多,空间占用越大,但能显著减少内部排序的时间。这本质上是一种典型的“空间换时间”策略。
稳定性分析
桶排序本身是不稳定的,其稳定性完全依赖于桶内排序算法的选择。如果桶内采用插入排序或归并排序等稳定算法,且分配/收集过程保持稳定,则整体可实现稳定排序;反之若桶内使用快速排序等不稳定算法,则整体也不稳定。
总结
桶排序在处理分布均匀的数值型数据时表现优异。C语言实现的关键在于利用链表灵活管理桶容量,同时需要注意内存管理与边界条件检查。虽然存在空间开销,但在大数据量且已知数据分布的情况下,它是突破 O(N log N) 瓶颈的有效手段。
以上就是C语言中桶排序原理、实现与复杂度分析的详细内容,更多关于C语言算法设计与优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















