


C语言字符大小写转换:基于ASCII差值与位运算的实现

在C语言编程中,将大写或小写字母相互转换是一项基础技能。实现这一功能通常有两种主流思路:一种是基于ASCII码数值差(±32)的逻辑判断,另一种是利用按位异或(XOR 32)直接操作二进制位。本文将通过分析典型代码案例,揭示其中的逻辑陷阱,并展示更高效的位运算实现方式。
基于ASCII码差值的转换逻辑
C语言中字符的本质是整数,存储在内存中的是其对应的ASCII码值。了解大写字母与小写字母的ASCII码关系是实现转换的关键:
- 大写字母范围:
'A'到'Z',对应十进制 65 - 90。 - 小写字母范围:
'a'到'z',对应十进制 97 - 122。 - 转换规律:同一字母的小写和大写ASCII码值相差32。例如 'a' (97) - 'A' (65) = 32。
因此,直观的转换代码如下:
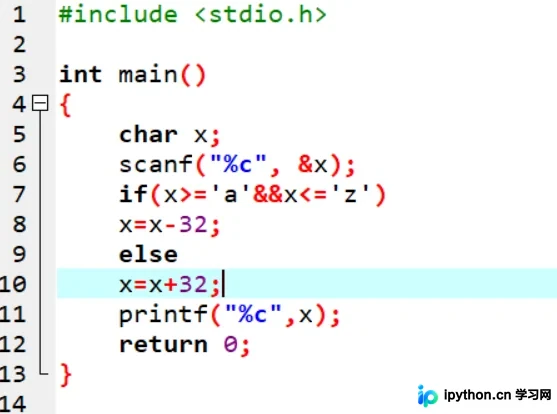
上述代码逻辑看似合理:先判断是否为大写,若是则+32转为小写;否则-32转回大写。我们先测试一段纯大写的输入,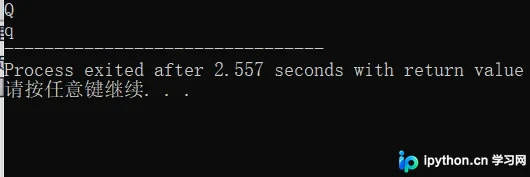 ,此时结果符合预期。
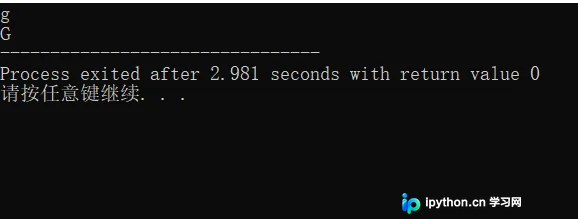
然而,这种“非此即彼”的逻辑在处理混合字符串时会暴露缺陷。如果输入包含非字母字符(如标点符号),程序仍会执行 x = x - 32 的操作。以逗号 ',' 为例(ASCII 44),减32后变成了 '[' (ASCII 12),导致输出异常。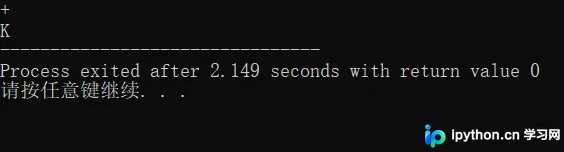
问题在于 else 分支执行的条件过于宽泛,它捕获了所有不在 (x<='a'||x>='z') 范围内的字符,而不仅仅是需要转换的小写字母。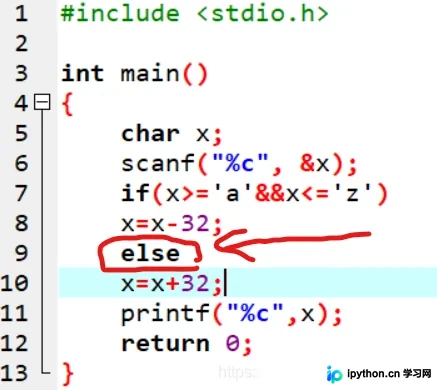
修正方案:必须明确限定 else 的执行条件,将其改为 else if,确保只有真正的字母才参与转换。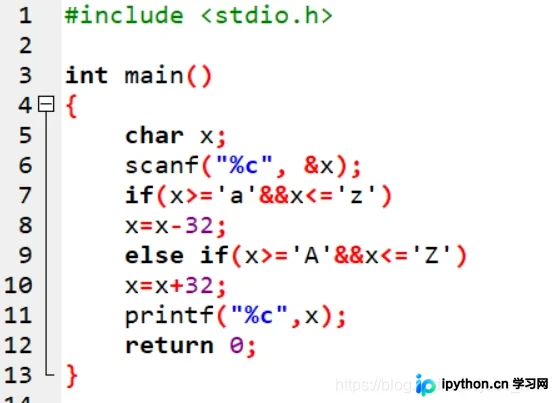
基于位运算的高效转换技巧
除了加减法,从二进制存储的角度观察,大小写转换可以通过位运算更高效地完成。对比 'A' 和 'a' 的二进制表示:
| 字符 | DEC | BIN (8-bit) |
|---|---|---|
| 'A' | 65 | 01000001 |
| 'a' | 97 | 01100001 |
| 'B' | 66 | 01000010 |
| 'b' | 98 | 01100010 |
可以观察到:
- 相同字母的大写和小写,其低4位完全一致。
- 唯一的区别在于高4位的第6位(从右向左数,索引为5):大写是
0,小写是1。
利用按位异或(^)的性质:任何数与特定值异或,若该位为1则翻转,为0则不变。我们寻找一个目标值,使其低4位为0,第6位为1,其余为0。这个数的二进制是 00100000,即十进制的 32。
公式:char_var ^ 32
- 大写转小写:
01000001 ^ 00100000 = 01100001('A' → 'a') - 小写转大写:
01100001 ^ 00100000 = 01000001('a' → 'A')
这种方法无需判断字符是字母还是其他符号。虽然对非字母字符进行操作也会改变其值,但在实际应用中,通常配合字母判断使用,或者仅在确定输入全是字母时使用。以下是结合两者优势的完整示例:
#include<stdio.h>
int main(){
    int i;
    char s[100];
    // 读入字符串
    gets(s);
    for(i=0;s[i]!='\0';i++)
    {
        // 判断是否为字母
        if((s[i]>='A'&&s[i]<='Z')||(s[i]>='a'&&s[i]<='z'))
            s[i]^=32; // 核心语句,利用异或实现大小写互换
    }
    printf("%s",s);
    return 0;
}
测试样例:
输入: Hello,Java!
输出: hELLO,jAVA!
以上就是C语言实现字母大小写转换的详细技术解析,更多关于C语言基础算法优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















