


C++内存分区模型详解:代码区、全局区、栈区与堆区

发布时间:2026-10-16 |
5人浏览过
C++程序在执行过程中将内存划分为四个核心区域:代码区、全局区、栈区和堆区。理解各区域的数据生命周期与存储特性,是掌握C++内存管理的基础。本文重点解析new操作符在堆区的应用及其与栈区的区别。
一、内存分区概览
C++程序执行时,内存大方向上被划分为以下四个区域,不同区域赋予数据不同的生命周期:
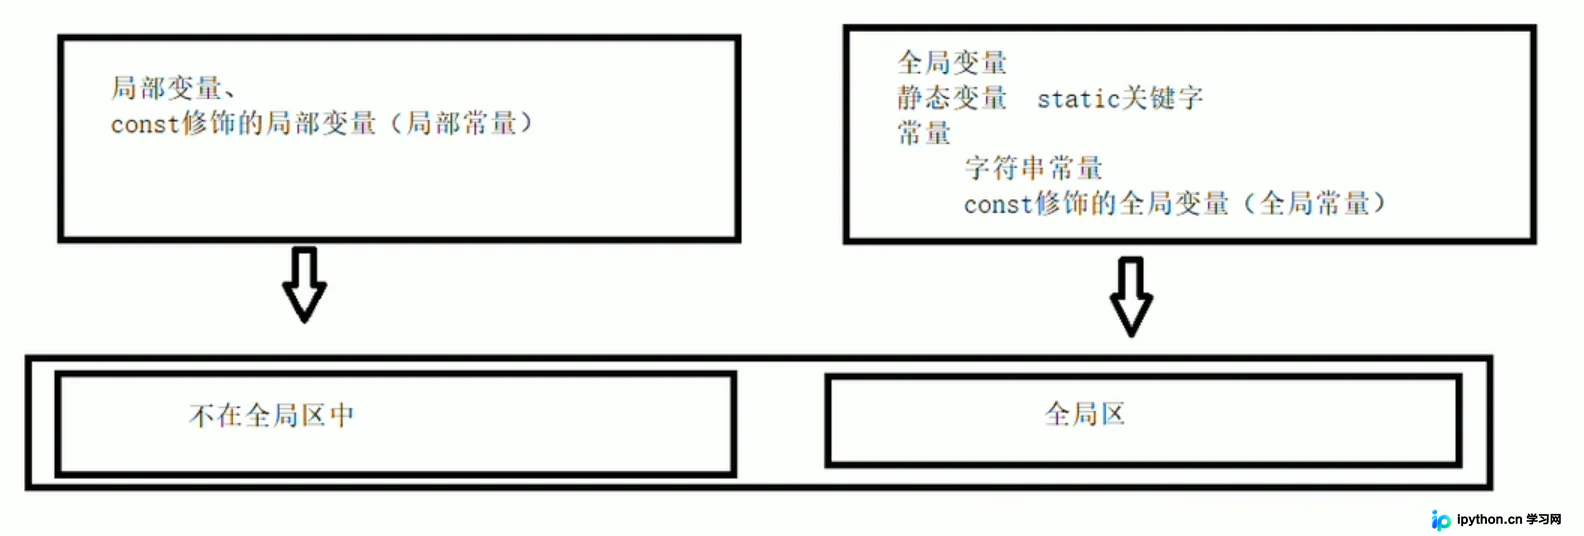
- 代码区:存放函数体的二进制代码,由操作系统管理。该区域具有共享性(减少内存占用)和只读性(防止意外修改指令)。
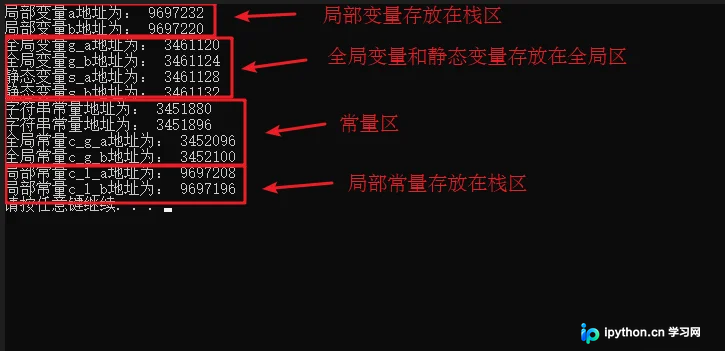
- 全局区:存放全局变量、静态变量以及常量(包括字符串常量)。
- 栈区:由编译器自动分配和释放,主要用于存放函数的参数值及局部变量。
- 堆区:由程序员分配和释放;若程序员不释放,程序结束时由操作系统回收。
二、程序运行前的内存分布
当C++源文件编译后生成可执行程序(exe),但在未执行前,内存主要分为两个区域:
- 代码区
- 全局区
此阶段主要涉及编译后的指令存储与全局/静态数据的预备布局。具体结构可参考以下示意图:
三、程序运行后的内存扩展
程序正式加载运行后,内存中会新增栈区和堆区。理解这两者的差异对于避免内存错误至关重要。
第1步:栈区与局部变量的生命周期
目的:了解为什么不能返回局部变量的地址。
栈区由编译器自动管理。函数执行完毕后,其中的局部变量会被自动销毁。如果尝试返回局部变量的地址,指针将成为悬空指针,访问该地址会导致未定义行为。
int * func()
{
	int a = 10;
	return &a; // 危险!函数结束后a的生命周期结束
}

int main() {
	int *p = func();
	cout << *p << endl;   // 第一次访问可能正常,但实际已无意义
	cout << *p << endl;   // 崩溃或输出垃圾数据的风险
	system("pause");
	return 0;
}
第2步:堆区与new关键字的使用
目的:掌握如何在堆区开辟内存并正确管理其生命周期。
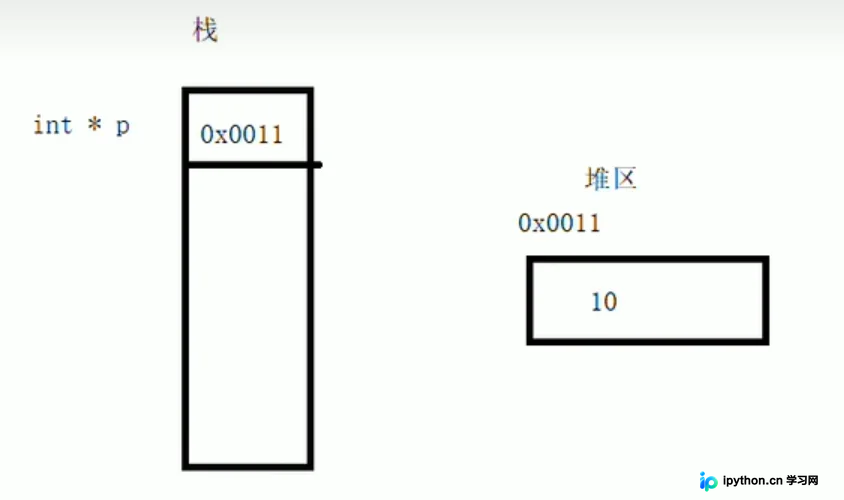
堆区的数据由程序员手动管理。利用 new 关键字可以在堆区开辟空间。虽然存储数据的指针本身是局部变量(位于栈区),但它保存的地址指向的是堆区数据,因此即使函数结束,堆区数据依然存在,直到手动释放。
基本类型内存分配示例
int* func()
{
	// 在堆区开辟数据,返回该数据的地址
	// 指针 p 在栈区,但 *p 指向堆区
	int* a = new int(10);
	return a;
}

int main() {
	int *p = func();
	cout << *p << endl; // 访问有效
	cout << *p << endl; // 依然有效,因为堆区数据未被回收

	// 手动释放内存
	delete p;
	// cout << *p << endl; // 报错!释放的空间不可访问
	system("pause");
	return 0;
}
数组类型的内存分配与释放
开辟数组时需使用 new[],释放时必须使用 delete[],二者必须对应,否则可能导致程序异常。
// 堆区开辟数组
int main() {
	int* arr = new int[10]; // 注意方括号

	for (int i = 0; i < 10; i++)
	{
		arr[i] = i + 100;
	}

	for (int i = 0; i < 10; i++)
	{
		cout << arr[i] << endl;
	}

	// 释放数组 delete 后加 []
	delete[] arr;
	system("pause");
	return 0;
}
总结
C++内存管理的核心在于明确每个数据块的归属。代码区只读共享,全局区贯穿全程,栈区自动化但短暂,堆区手动管理且灵活。正确使用 new 和 delete 可以有效避免内存泄漏和悬空指针问题。以上就是关于C++内存分区模型的详细内容,更多关于C++内存管理与new/delete用法的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















