


Python如何删除重复文件?基于MD5校验的自动化去重脚本

面对海量同类文档或备份残留,手动核对极其耗时。通过Python标准库遍历目录,采用文件大小初筛配合MD5精准比对的双层逻辑,可快速定位并清理冗余数据。本文提供含安全提示的去重脚本、执行参数配置说明及常用路径操作对照指南,协助开发者高效、安全地完成批量文件去重。
去重原理与安全预警
判断文件是否重复的标准并非仅看文件名,而是依赖底层数据特征。本方案采用两层过滤机制:
1. 大小初筛:读取文件的字节体积。体积不同的文件绝对不可能重复,直接跳过后续计算,大幅降低CPU与磁盘I/O压力。
2. 哈希比对:对体积相同的候选文件计算MD5摘要值。只要哈希值完全一致,即可判定为内容重复文件,触发物理删除操作。
⚠️ 风险提示:脚本中的 file.unlink() 会直接从磁盘移除文件且不进入回收站。执行前请务必确认目标文件夹内的数据已备份,或先在测试目录中验证流程。
脚本构建与参数配置
第1步:定义哈希计算入口
使用内置 hashlib 模块读取二进制流并生成十六进制摘要。此函数作为去重的核心校验器,接收文件绝对路径字符串,返回对应文件的MD5标识。
def getmd5(filename):
    with open(filename, 'rb') as f:
        data = f.read()
    return hashlib.new("md5", data).hexdigest()
第2步:加载目录与排序策略
调用 pathlib.Path 获取指定路径下的所有子项。脚本默认按名称字典序升序排列,此时相同文件会保留创建时间较新的那个;若将列表反转(reverse=True),则改为保留日期较久或文件名较短的版本。开发者可根据实际业务需求调整排序方式。
第3步:全量遍历与条件删除
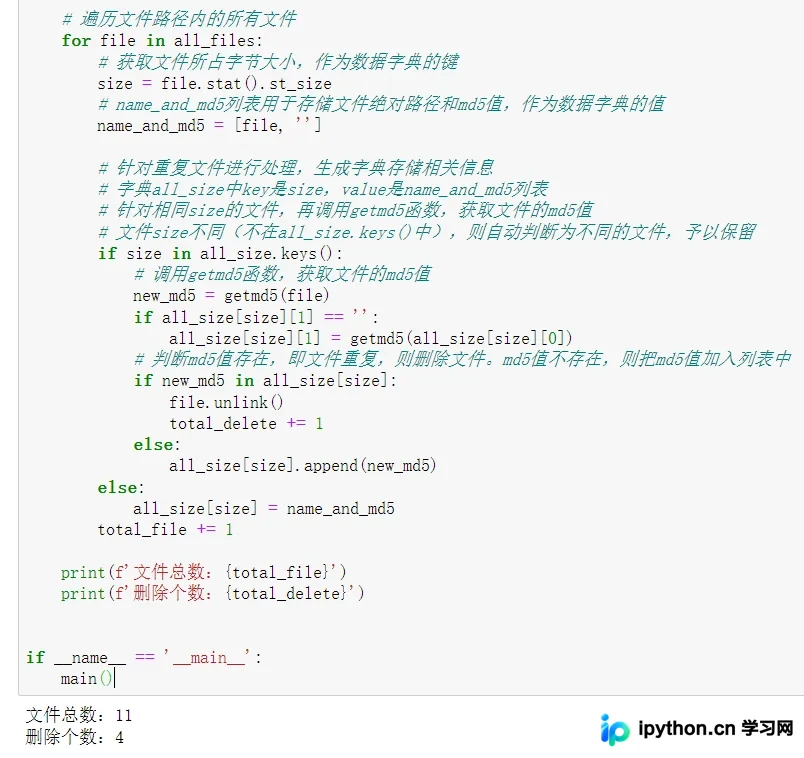
维护一个字典 all_size 记录已遇见的【文件大小 → 文件路径及MD5】映射关系。遍历过程中,若当前文件大小未出现过,则将其存入字典;若已存在,则调用哈希函数进行二次核验。当确认MD5相同时,执行卸载删除指令并累加计数器;否则将该新文件的哈希值追加至同一尺寸组中避免误删。
from pathlib import Path
import hashlib


def getmd5(filename):
    # 接收文件路径,返回文件md5值
    with open(filename, 'rb') as f:
        data = f.read()
    file_md5 = hashlib.new("md5", data).hexdigest()
    return file_md5


def main():
    # 请替换为目标扫描根目录
    path = r"F:\FileRecv\删除文件测试"
    all_size = {}
    total_file = 0
    total_delete = 0

    # 获取路径内的所有文件名,默认是升序排列,相同文件将会保留日期时间最新的
    all_files = Path(path).glob('*.*')

    # 降序排列,相同文件将会保留文件名最短的(即日期时间最久的)
    all_files = sorted(all_files, reverse=True)

    # 遍历文件路径内的所有文件
    for file in all_files:
        # 获取文件所占字节大小,作为数据字典的键
        size = file.stat().st_size
        # name_and_md5列表用于存储文件绝对路径和md5值,作为数据字典的值
        name_and_md5 = [file, '']

        # 针对重复文件进行处理,生成字典存储相关信息
        # 字典all_size中key是size,value是name_and_md5列表
        # 针对相同size的文件,再调用getmd5函数,获取文件的md5值
        # 文件size不同(不在all_size.keys()中),则自动判断为不同的文件,予以保留
        if size in all_size.keys():
            # 调用getmd5函数,获取文件的md5值
            new_md5 = getmd5(file)
            if all_size[size][1] == '':
                all_size[size][1] = getmd5(all_size[size][0])
            # 判断md5值存在,即文件重复,则删除文件。md5值不存在,则把md5值加入列表中
            if new_md5 in all_size[size]:
                file.unlink()
                total_delete += 1
            else:
                all_size[size].append(new_md5)
        else:
            all_size[size] = name_and_md5
        total_file += 1

    print(f'文件总数:{total_file}')
    print(f'删除个数:{total_delete}')


if __name__ == '__main__':
    main()
保存为 .py 文件后直接在终端运行,脚本会自动统计处理进度并输出最终清理数量。
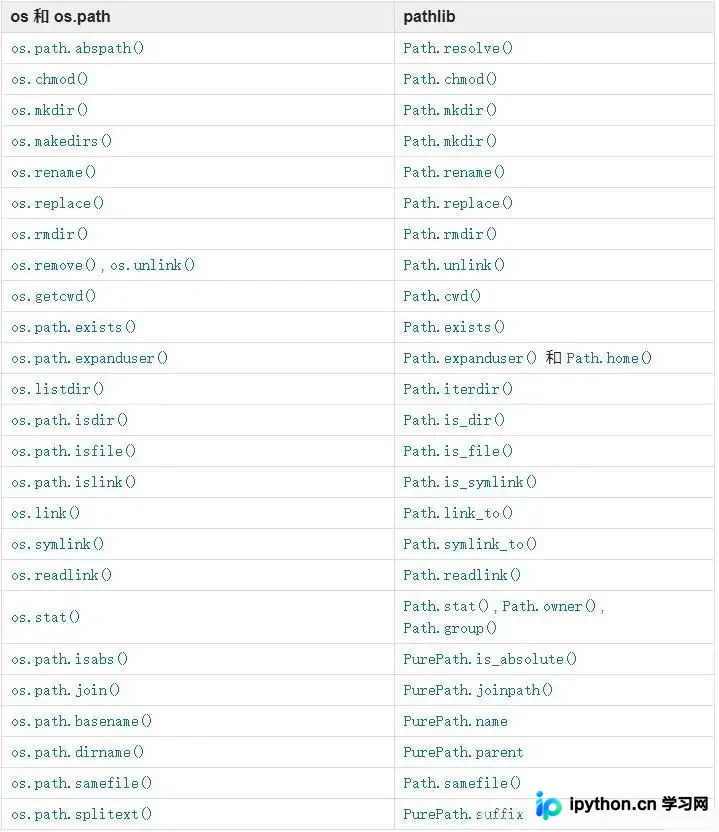
路径模块常用方法对照
现代Python开发推荐使用 pathlib 替代传统的 os.path。下方整理了核心对象的常用属性与方法,便于日常路径解析与结构操作:
Path(path).name:返回完整文件名(含后缀)Path(path).stem:返回不带后缀的文件名Path(path).suffix:返回文件扩展名Path(path).suffixes:返回多级后缀列表(如 .tar.gz)Path(path).parts:返回路径各段组成的元组Path(path).parent:返回父级目录对象Path(path).parents:返回包含所有上级目录的序列Path.exists():验证路径对应的文件或文件夹是否存在Path.is_dir()/Path.is_file():区分目录与文件属性Path.mkdir() / .rmdir() / .unlink():分别对应新建空目录、删除空目录与强制卸载文件
以上就是Python如何实现删除重复文件的详细内容,更多关于Python自动化办公与批量文件管理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















