


MySQL分组查询每组最新一条数据的三种实现方法

在报表统计或业务逻辑中,经常需要根据用户 ID 分组查询其最新的操作记录。然而在 MySQL 中,直接使用 `GROUP BY` 配合子查询 `ORDER BY` 往往会得到意料之外的错误结果(如最早的一条)。本文将深入剖析这一现象的技术原因,并分享三种稳定可靠的实现方案及性能对比。
常见误区与排查前提
在进行复杂的 SQL 查询前,确保你的环境满足基础条件。MySQL 5.7+ 版本默认开启了 sql_mode=only_full_group_by,这会阻止查询未出现在 GROUP BY 中的非聚合列。
检查 SQL Mode:
select @@sql_mode;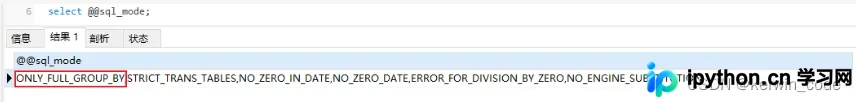
若需要移除限制以兼容旧版查询逻辑(建议生产环境谨慎使用),可通过以下命令调整:先查看当前模式,再剔除 only_full_group_by。如果是 JDBC 等应用层连接,重启服务通常更稳妥。
set global sql_mode='STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_ENGINE_SUBSTITUTION';
set session sql_mode='STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_ENGINE_SUBSTITUTION';
构建测试数据表
为了演示准确的数据流转,我们建立一个模拟的用户钱包明细表。表中包含自增主键 id、用户标识 customer_id、金额变动 happen_amount 及时间戳 create_time。
DROP TABLE IF EXISTS `customer_wallet_detail`;
CREATE TABLE `customer_wallet_detail`  (
  `id` bigint(20) NOT NULL AUTO_INCREMENT,
  `customer_id` bigint(20) NULL DEFAULT NULL COMMENT '用户ID',
  `happen_amount` varchar(15)  NULL DEFAULT '0' COMMENT '发生金额',
  `balance_amount` varchar(15) NULL DEFAULT '0' COMMENT '可用余额',
  `create_time` bigint(20) NULL DEFAULT NULL COMMENT '发生时间',
  PRIMARY KEY (`id`) USING BTREE
) ENGINE = InnoDB COMMENT = '用户钱包明细' ;

-- 插入测试数据:假设 create_time 越大代表越新的记录
INSERT INTO `test`.`customer_wallet_detail` VALUES (1, 1, '100', '100', 1670300656630);
INSERT INTO `test`.`customer_wallet_detail` VALUES (2, 1, '-10', '90', 1670300656640);
INSERT INTO `test`.`customer_wallet_detail` VALUES (3, 1, '5', '95', 1670300656650);
INSERT INTO `test`.`customer_wallet_detail` VALUES (4, 3, '998', '998', 1670300656660);
INSERT INTO `test`.`customer_wallet_detail` VALUES (5, 3, '-100', '898', 1670300656670);
INSERT INTO `test`.`customer_wallet_detail` VALUES (6, 3, '-98', '800', 1670300656680);
INSERT INTO `test`.`customer_wallet_detail` VALUES (7, 2, '666', '666', 1670300656690);
INSERT INTO `test`.`customer_wallet_detail` VALUES (8, 2, '-66', '600', 1670300656695);
INSERT INTO `test`.`customer_wallet_detail` VALUES (9, 2, '-600', '0', 1670300656699);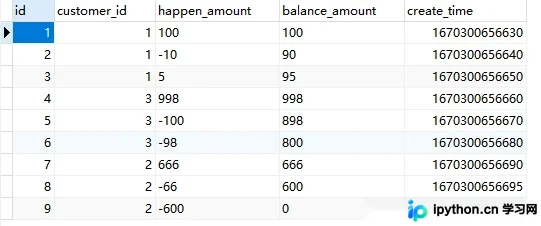
错误尝试:为什么子查询 ORDER BY 失效?
很多人的第一反应是使用子查询将数据按时间倒序排列,外层再进行分组:
SELECT * FROM (
  SELECT * FROM customer_wallet_detail
  ORDER BY create_time DESC
) t1
GROUP BY t1.customer_id;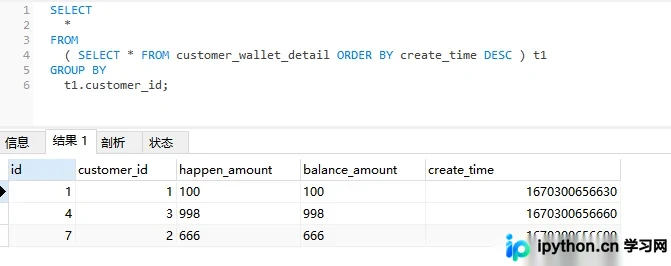
结果分析:执行上述语句,你会发现返回的并不是每个人的“最新”记录,而是“最旧”的记录。这是因为在 MySQL 的执行机制中,当 `GROUP BY` 不与 `LIMIT` 配合使用时,内层子查询的 ORDER BY 会被忽略。子查询仅作为数据集合传递给外层,而 GROUP BY 选取每一组的第一条原始记录(通常是物理存储顺序靠前或索引顺序靠前的数据)。
方法一:强制激活 ORDER BY(加 LIMIT)
要打破 MySQL 的这一“优化规则”,最通用的手段是加上 LIMIT 关键字。这迫使引擎必须对子查询进行完整的排序后,再截断输出,从而保留了排序后的顺序供外层分组读取。
注意:虽然语法上可行,但需要先计算总行数填入 LIMIT,或者设置一个极大的数值,实际业务中并不推荐这种硬编码方式。
SELECT * FROM (
  SELECT * FROM customer_wallet_detail
  ORDER BY create_time DESC
  LIMIT 99999 -- 需大于预期最大数据量
) t1
GROUP BY t1.customer_id;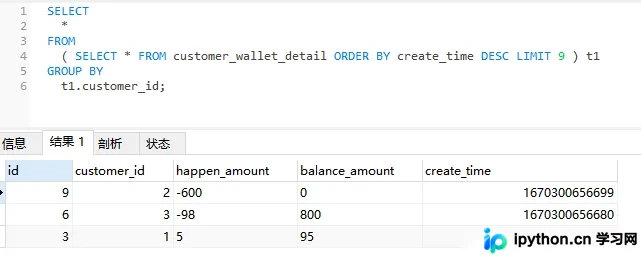
方法二:利用 Max(ID) + WHERE IN(适用于有序 ID)
如果业务表的 id 是自增且严格递增的,那么最大的 ID 必然对应着最新的创建时间。我们可以先查出每个分组的最大 ID,再利用 IN 找回对应的整行数据。
SELECT * FROM customer_wallet_detail
WHERE id IN (
    SELECT MAX(id) FROM customer_wallet_detail
    GROUP BY customer_id
)
ORDER BY customer_id;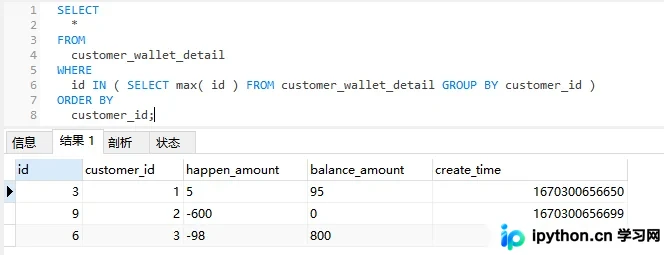
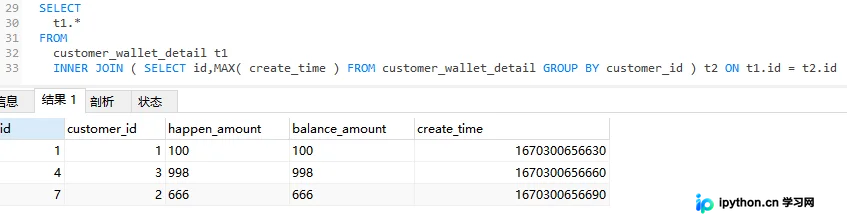
缺点提示:部分 MySQL 版本不支持在 FROM 子句中直接更新/删除包含 SELECT 的表,但在简单的查询场景中通常表现良好。需注意不要写错成 SELECT MAX(create_time) 来获取整行,因为这样会丢失其他字段。
方法三:Inner Join 自连接(推荐高性能方案)
该方法与方法二逻辑一致,但用 INNER JOIN 替换了 WHERE IN。在处理百万级数据时,Join 的方式通常比 In 拥有更好的索引命中率,本地 20w 条数据测试表明其性能提升约 50%。
SELECT t1.* FROM customer_wallet_detail t1
INNER JOIN (
    SELECT MAX(id) AS max_id FROM customer_wallet_detail
    GROUP BY customer_id
) t2 ON t1.id = t2.max_id;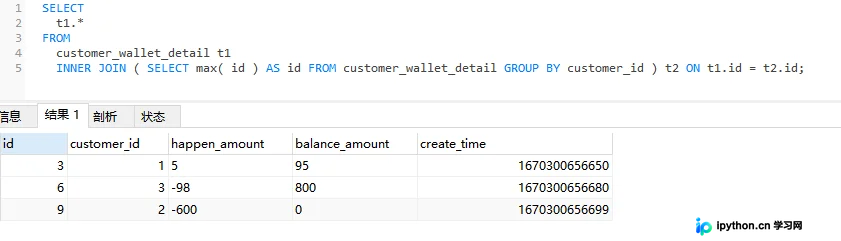
总结与技术避坑指南
综合对比,方法三(Inner Join)** 在可读性、性能和通用性上是最佳选择;方法二次之但依赖特定索引;方法一虽巧妙但不具备工程实用性。
核心知识点:GROUP BY 与聚合函数的陷阱
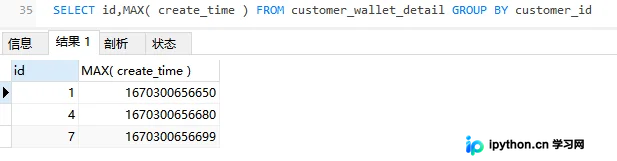
初学者常犯的一个错误是直接写出:SELECT customer_id, MAX(create_time), happen_amount FROM ... GROUP BY customer_id。
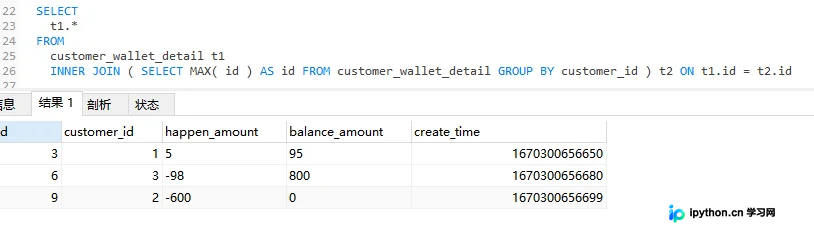
这种做法会导致数据错位:MAX(create_time) 能正确取出最新的时间值,但由于 GROUP BY 的非确定性,happen_amount 取出的往往是该分组下的某一条(可能是最旧的)无关数据。时间戳和交易金额无法匹配同一笔业务。
以上就是 MySQL 分组查询每组最新一条数据的详细内容,更多关于 MySQL 高阶用法与优化技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















