


Java 缓冲流原理详解与高效读写实战

Java 中的缓冲流(BufferedInputStream、BufferedOutputStream、BufferedReader、BufferedWriter)通过内存缓冲区减少对磁盘的频繁 I/O 操作,显著提升读写效率。本文详解其底层工作原理、默认缓冲区大小,并提供包含字节数组批量读取、readLine/newLine 方法使用的完整代码示例,涵盖从基础用法到性能优化的最佳实践。
高级流的封装与设计
在 Java I/O 体系中,除了基础的字节和字符流(如 FileInputStream、FileReader),缓冲流属于“高级流”。它们并非直接操作数据源,而是对基本流进行装饰器模式封装。这种设计允许我们在不改变原有流接口的前提下,叠加新功能或优化性能。
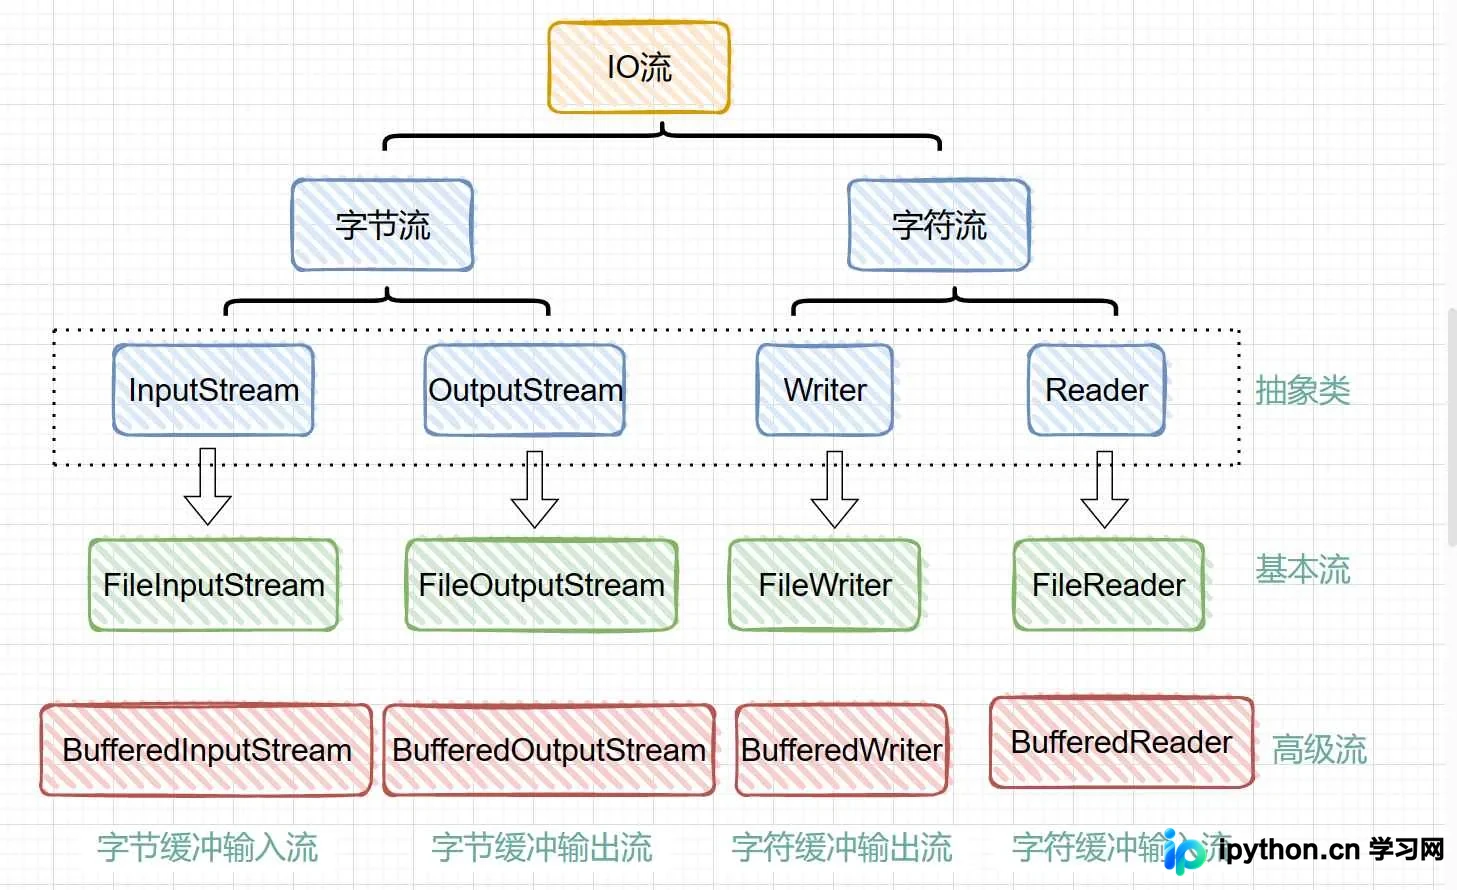
所有高级流在底层依然依赖基本流完成实际的数据读写,但其核心价值在于引入了内部缓冲机制以及新增的高级操作方法(如按行读取),从而简化开发并提升效率。
字节缓冲流:原理与实现
字节缓冲输入流 BufferedInputStream 和输出流 BufferedOutputStream 主要用于处理二进制数据。其核心优势在于内置缓冲区。当开启一个 BufferedInputStream 时,JDK 默认会在内存中开辟一个大小为 8192 字节(即 8KB)的数组。后续的数据读取不再是每次请求都调用底层系统 API 去磁盘中拿取一个字节,而是先填满这 8KB 的缓冲区,之后对缓冲区的访问速度极快,大幅减少了系统调用次数。
初始化与参数配置
可以通过构造函数指定自定义缓冲区大小。若传入大小小于等于 0,JDK 会抛出 IllegalArgumentException 异常。源码结构如下:
    public BufferedInputStream(InputStream in) {
        this(in, DEFAULT_BUFFER_SIZE); // DEFAULT_BUFFER_SIZE 通常为 8192
    }

    public BufferedInputStream(InputStream in, int size) {
        super(in);
        if (size <= 0) {
            throw new IllegalArgumentException("Buffer size <= 0");
        }
        buf = new byte[size];
    }
基础文件拷贝操作
以下是使用字节缓冲流进行文件拷贝的标准流程。注意:关闭高级流即可,无需单独关闭传入的基本流,因为高级流的 close() 方法内部会自动触发底层流的关闭。
import java.io.*;

public class Test {
    public static void main(String[] args) throws IOException {
        // 1. 创建流对象:将基本流包装进缓冲流
        BufferedInputStream bis = new BufferedInputStream(new FileInputStream("test.txt"));
        BufferedOutputStream bos = new BufferedOutputStream(new FileOutputStream("copy.txt"));

        // 2. 逐个字节读取(效率较低,仅作演示)
        int b;
        while ((b = bis.read()) != -1) {
            bos.write(b);
        }

        // 3. 释放资源
        bos.close();
        bis.close();
    }
}
高性能批量读取优化
上述逐字节写入方式存在性能瓶颈。实际生产中应利用 read(byte[] b) 和 write(byte[] b, int off, int len) 方法。其中,read 返回实际读取到的字节数,若到达末尾则返回 -1;write 必须指定偏移量和长度,防止因上次残留数据导致文件污染。
// 申请 1024 字节的缓冲区
byte[] bytes = new byte[1024];
int len;
// 循环读取直到返回 -1
while ((len = bis.read(bytes)) != -1) {
    // 写入实际读取到的有效数据部分
    bos.write(bytes, 0, len);
}
字符缓冲流的高效处理
BufferedReader 和 BufferedWriter 虽然同样具备 8KB 的缓冲区以提升 IO 效率,但它们的核心价值在于提供了文本行的便捷处理能力。对于纯文本文件,字符缓冲流是首选。
按行读取与写入
BufferedReader.readLine() 能够一次性读取一整行字符串,遇到换行符停止,且不包含换行符本身。若读到文件尾,返回 null。
import java.io.*;

public class TextReadTest {
    public static void main(String[] args) throws IOException {
        BufferedReader br = new BufferedReader(new FileReader("test.txt"));
        String line;
        // 利用 readLine 自动处理换行逻辑
        while ((line = br.readLine()) != null) {
            System.out.println(line);
        }
        br.close();
    }
}同理,BufferedWriter.newLine() 会根据当前操作系统自动生成正确的换行序列(Windows 为 \r\n,Linux/Mac 为 \n),解决了跨平台换行符不一致的难题。
import java.io.*;

public class TextWriteTest {
    public static void main(String[] args) throws IOException {
        // true 表示追加模式
        BufferedWriter bw = new BufferedWriter(new FileWriter("test.txt", true));
        bw.write("第一行内容");
        bw.newLine(); // 智能换行
        bw.write("第二行内容");
        bw.close();
    }
}
读取过程图解与总结
无论是字节流还是字符流,缓冲流在内存中构建了一个中间层。读取数据的本质是一个解码和填充的过程,系统先将数据块读入内存缓冲区,随后应用程序再从内存中高速拉取数据。这种机制极大地降低了物理磁盘的 I/O 频率。
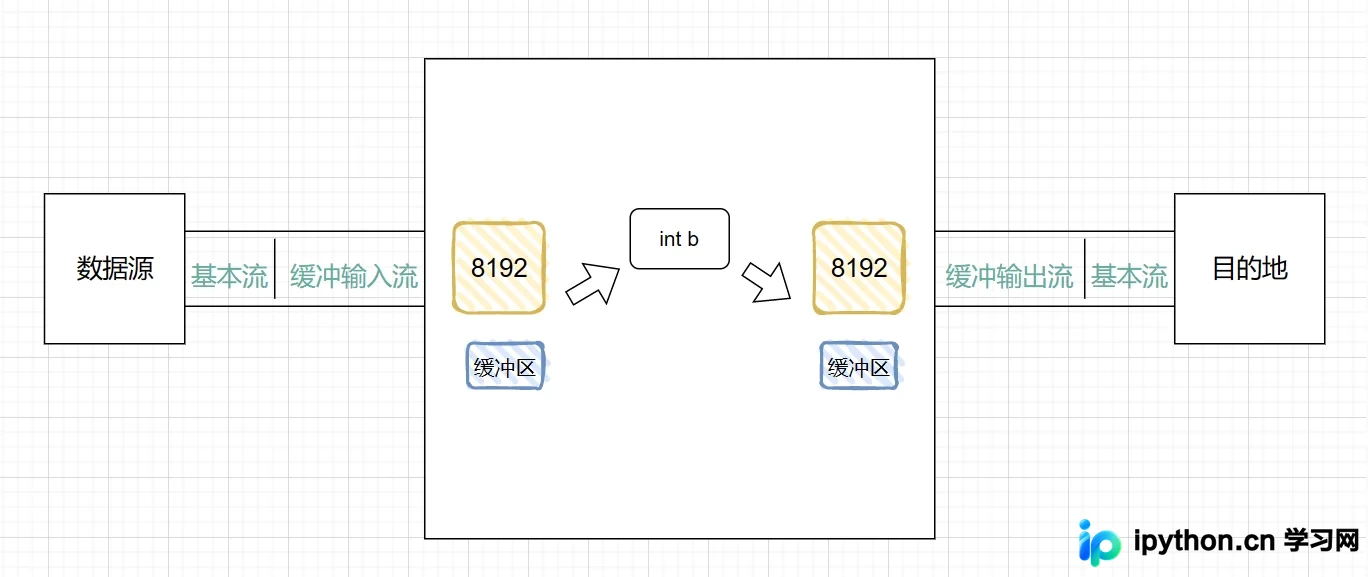
综上所述,掌握缓冲流的关键在于理解“缓冲”带来的性能红利,并在编码中熟练运用数组批量读写以及文本特有的行处理方法。以上就是 Java 缓冲流原理及实战应用的详细内容,更多关于 Java IO 流体系高效处理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















