


Golang Map底层实现原理与扩容机制解析

Golang 中的 map 基于哈希表实现,底层由 hmap 和 bmap 构成。理解其内部机制有助于掌握高效的键值对存取、应对哈希冲突引发的扩容行为,并避免在开发中因无序性或并发问题导致的隐患。
Map 的底层内存模型
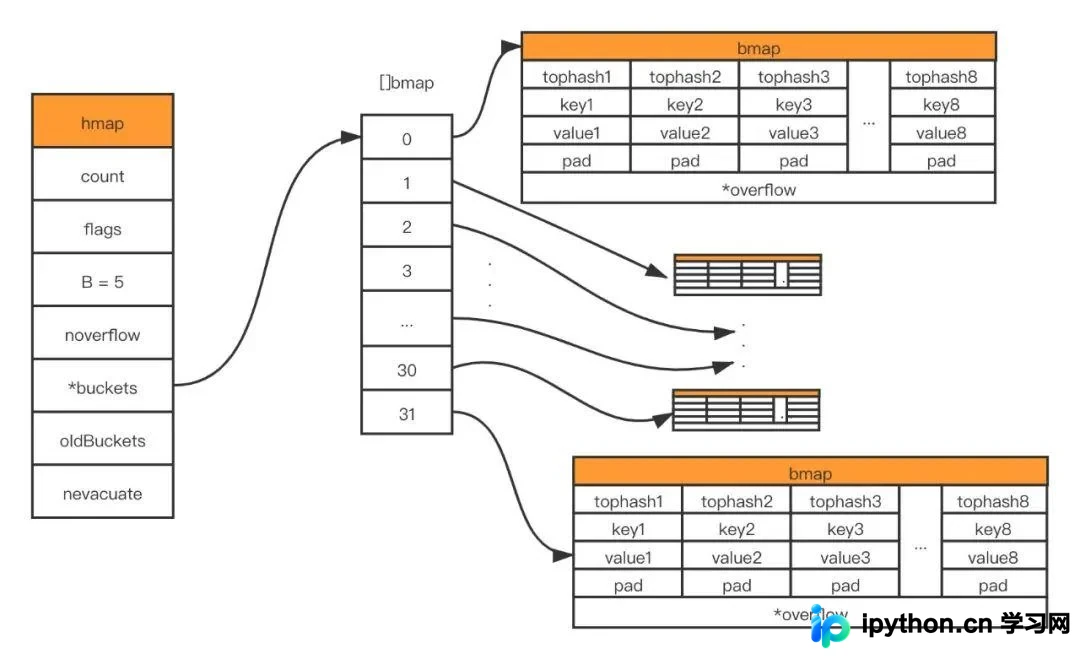
在 Go 语言源码中,map 的底层核心结构体为 hmap(hash map)。它负责管理整个哈希表的元数据:
type hmap struct {
    count     int            // map 中元素的数量
    flags     uint8          // 状态标记位(如是否正在写入)
    B         uint8          // bucket 数量的指数,bucket 总数 = 2^B
    noverflow uint16         // overflow bucket 的数量近似值
    hash0     uint32         // hash 种子
    buckets   unsafe.Pointer // 指向当前 bucket 数组的指针
    oldbuckets unsafe.Pointer // 扩容期间存放旧数组的指针
    nevacuate uintptr        // 表示已迁移完成的基准地址
    extra *mapextra         // 额外字段(如短字符串优化)
}
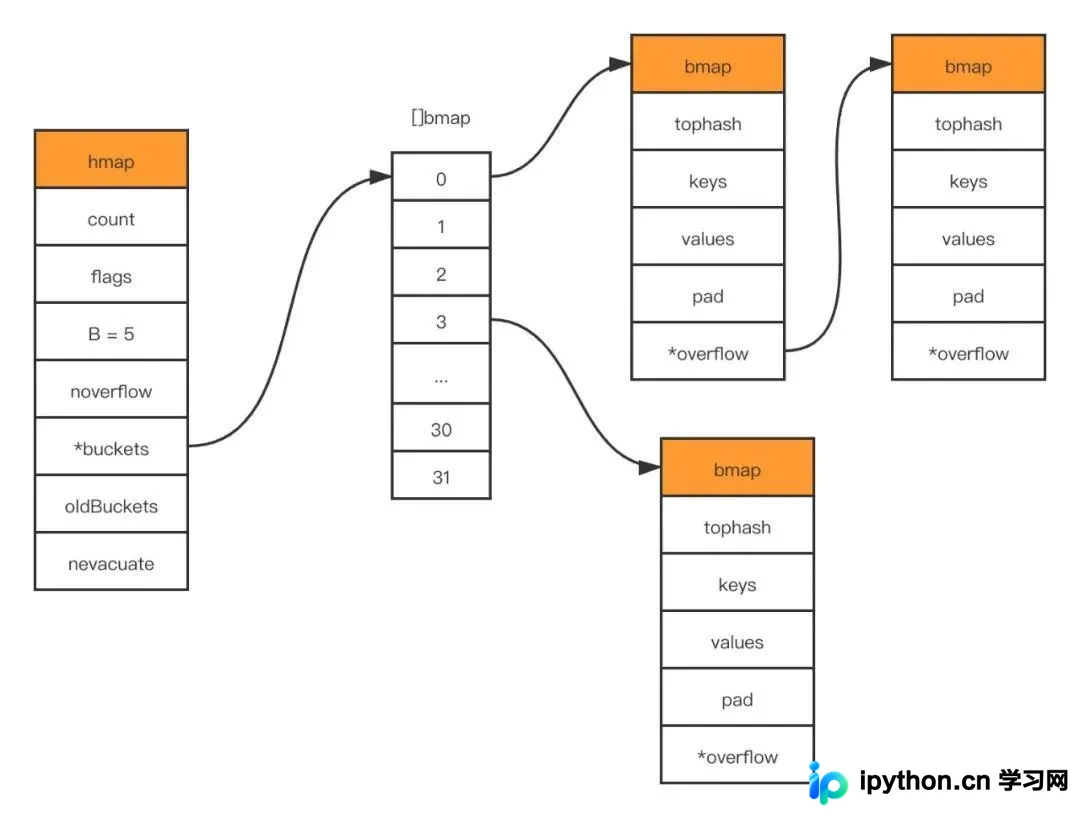
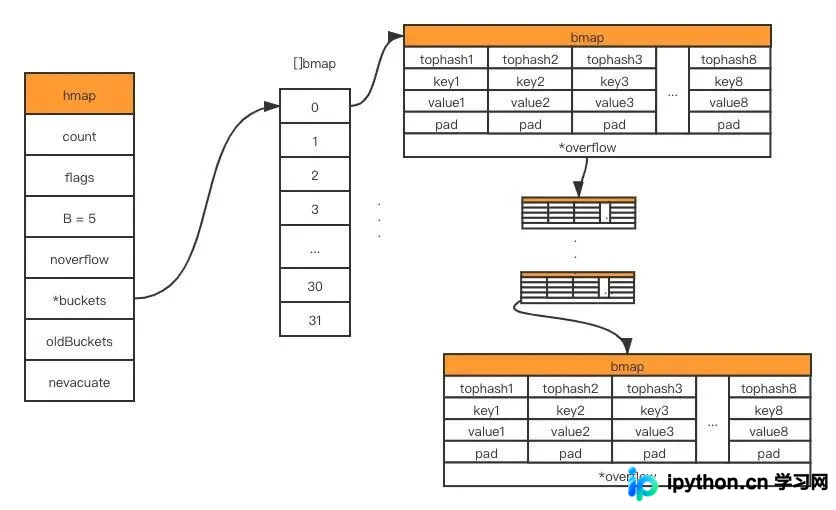
B 决定了 bucket 数组的长度为 2^B。bucket 本质上是 bmap 结构体的实例,但在编译器看来,它会动态包含 key 和 value 的数据区域:
type bmap struct {
    topbits [8]uint8      // 每个 key 的 hash 高 8 位
    keys    [8]keytype    // key 数据
    values  [8]valuetype  // value 数据
    pad     uintptr       // 内存对齐填充
    overflow uintptr      // 溢出桶指针,当 8 个位置满时使用
}
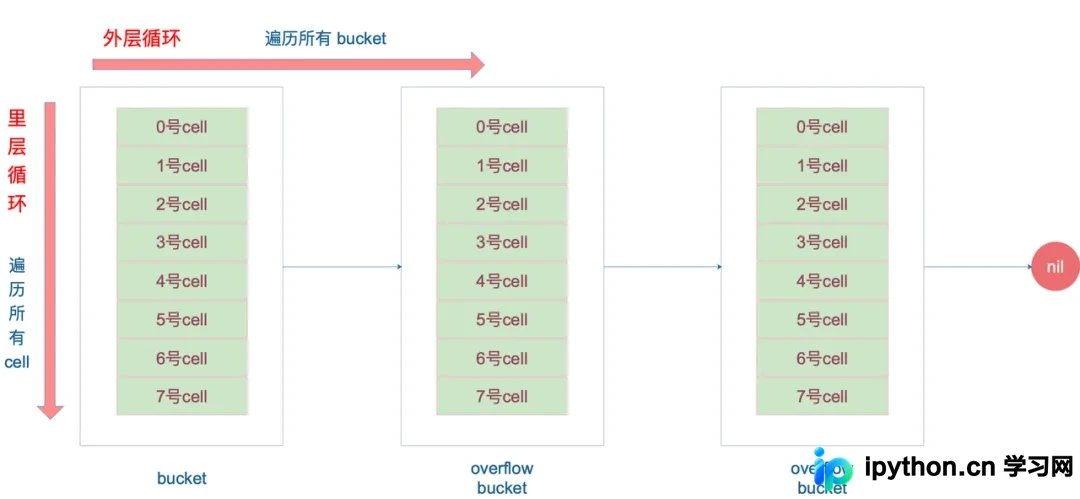
一个标准的 bucket 可以存储最多 8 组 key/value。如果发生哈希冲突导致空间不足,则通过 overflow 指针链接额外的 bucket 节点。具体的层级结构如下:
Map 的存与取逻辑
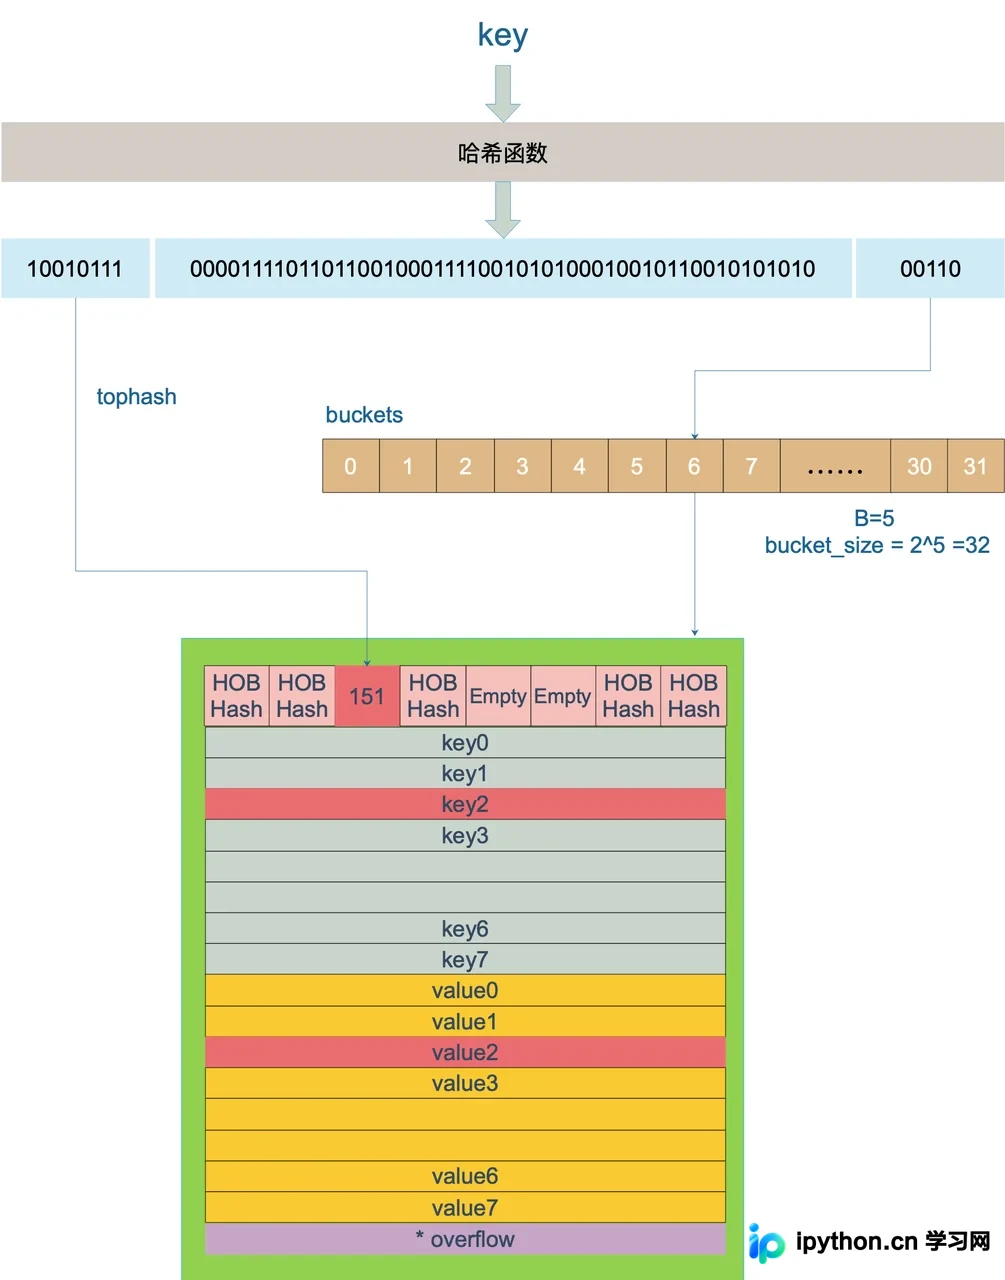
Map 的存取核心在于确定 key 应该存放在哪个 bucket 中的哪个位置。这主要依赖于哈希函数计算出的 hash 值:
- 定位 Bucket:利用 hash 值的低
B位作为掩码,计算出目标 bucket 在数组中的索引位置。 - 定位槽位:在每个 bucket 内,使用 hash 值的高 8 位(
tophash)快速比对,判断第几个槽位可能匹配对应的 key。 - 完整性校验:
tophash一致仅代表“可能在”,必须进一步通过内存地址读取完整的 key 值进行相等性判断。
以下是底层核心存取代码的逻辑流程:
func mapaccess2(t *maptype, h *hmap, key unsafe.Pointer) (unsafe.Pointer, bool) {
    if h == nil || h.count == 0 {
        return unsafe.Pointer(&zeroVal[0]), false
    }
    if h.flags&hashWriting != 0 {
        throw("concurrent map read and map write")
    }
    hash := t.hasher(key, uintptr(h.hash0))
    m := bucketMask(h.B)
    // 根据 hash 值后 B 位确定 bucket 索引
    b := (*bmap)(unsafe.Pointer(uintptr(h.buckets) + (hash&m)*uintptr(t.bucketsize)))

    // 处理扩容时的查找:如果在查找老数据,需指向 oldbuckets
    if c := h.oldbuckets; c != nil {
        if !evacuated(oldb) {
            b = oldb
        }
    }
    top := tophash(hash)

    // 遍历链表式的 bucket
    for ; b != nil; b = b.overflow(t) {
        for i := uintptr(0); i < bucketCnt; i++ {
            if b.tophash[i] != top {
                continue
            }
            // 提取 key 进行精确比较
            k := add(unsafe.Pointer(b), dataOffset+i*uintptr(t.keysize))
            if t.key.equal(key, k) {
                // 找到对应的位置,返回 value
                v := add(unsafe.Pointer(b), dataOffset+bucketCnt*uintptr(t.keysize)+i*uintptr(t.valuesize))
                return v, true
            }
        }
    }
    return unsafe.Pointer(&zeroVal[0]), false
}
寻址过程图解
整个寻址的过程是从顶层哈希分布到底层内存偏移量的映射,具体路径示意如下:
Map 的扩容机制
Go map 采用渐进式扩容策略,旨在减少单次扩容带来的性能损耗。触发扩容主要取决于以下两个条件:
情况一:负载因子过大(增量扩容)
当 bucket 中的平均元素数量超过阈值(源码设定为 6.5)时,触发增量扩容。此时,新的 bucket 数组大小仅为原来的 2 倍(B 加 1),原有的数据会被逐渐搬移。
情况二:Overflow 桶过多(等量扩容)
当哈希冲突严重,导致溢出桶(overflow bucket)过多时,普通的翻倍无法解决问题,因此触发等量扩容。此时新 bucket 数组的大小是原数组的 2 倍 甚至更多,目的是彻底消除溢出链,提升存取效率。
Map 的有序性与并发安全
1. 为什么遍历是无序的?
在 Go 语言中,map 是严格无序的。即使不进行任何修改操作,多次遍历同一个 map 的结果顺序也可能不同。这是因为官方在设计遍历时故意引入了随机化因素,防止开发者产生依赖顺序的代码逻辑。且在扩容过程中,数据会分散到新的内存块中,原本的位置关系被打破。
objMap := make(map[string]int)
for i := 0; i < 5; i++ {
   objMap[strconv.Itoa(i)] = i
}
var valStr1, valStr2 string
for k, _ := range objMap { valStr1 += k } // 第一次遍历
for k, _ := range objMap { valStr2 += k } // 第二次遍历
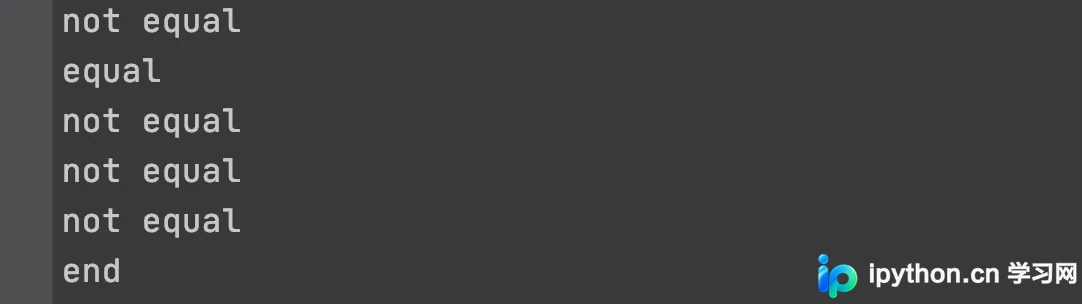
// 两次结果通常不相等
fmt.Println(valStr1 == valStr2)
运行结果证实了遍历的随机性:
2. 为什么并发读写会导致 Crash?
Go 原生 map 不支持并发读写。如果在多个 goroutine 中同时对 map 进行写入操作,程序会直接 panic 崩溃(fatal error: concurrent map writes)。 官方之所以不增加 Mutex 锁或抛出普通错误,而是选择崩溃,主要出于以下考量:
- 性能权衡:绝大多数 map 使用场景是单线程的,强制加锁会拖累所有用户的性能。
- 快速暴露 Bug:如果 silently 失败或返回错误,可能导致难以排查的数据竞争问题;而立即崩溃能将安全隐患提前暴露,便于开发者修复代码。
若涉及多线程环境下的 map 共享,请务必使用 sync.Map 或配合 sync.Mutex 进行保护。
简要总结
理解 Go map 的核心在于把握其底层哈希桶结构与渐进式扩容的策略。在日常开发中,需要牢记 map 无序的特性,避免将其用于排序场景,同时在需要跨协程访问时必须做好同步控制。以上就是Golang Map底层实现原理与扩容机制解析的详细内容,更多关于Golang map的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















