


C++中将十进制数值转换为十六进制字节数组的位操作法

在进行串口调试或底层数据解析时,往往需要将计算机内部表示为十进制的数值,按照特定的协议格式(通常是16进制字节流)封装到发送缓冲区中。对于开发者而言,理解如何利用位运算高效地将数值拆分并映射到无符号字符数组(`unsigned char`),是处理二进制数据的必备技能。
为什么需要十六进制字节输出?
在实际的工程场景中,例如通过串口(UART)、CAN总线或以太网发送数据时,传输的是原始的字节流。虽然内存中的数字以二进制补码形式存储,但在日志记录、抓包分析或遵循Modbus等工业协议时,我们习惯使用“0x”前缀的16进制数来直观地表达每个字节的值。将大整数(如32位或64位整型)拆解为多个8位的字节,通常涉及到大端序(Big-Endian)或小端序(Little-Endian)的处理,而直接采用位移与掩码的方式可以精确控制每一个字节的来源。
核心实现原理
假设我们需要将一个较大的数值(例如 `double` 的整数部分)存入一个字节数组中,关键步骤分为三类:
- 数据类型转换:确保数值具有明确的大小(如64位),消除精度丢失或类型溢出风险。
- 位移隔离高位**:利用右移运算符 `>>` 将特定8位的数据段移动到最低位。
- 掩码提取低位:利用按位与运算符 `& 0xFF` 屏蔽其他位,仅保留低8位。
具体操作步骤与代码实现
第1步:准备源数据并转换为定长整型
在处理浮点数转为二进制流的场景下,首先需将小数部分截断,并映射到足够容纳其值的整型上。例如,将一个双精度浮点数的整数部分赋给 `__int64`(即64位整型):
double b = 123456789.987;
__int64 B = (__int64)b;
此时,变量 `B` 在内存中占据8个字节,包含了完整的数值信息。
第2步:定义用于接收的字节数组
创建一个 `unsigned char` 类型的数组作为缓冲区。这里为了演示从已有数据后追加的效果,初始化了部分初始值:
unsigned char A[46] = { 0x12, 0xAB, 0x34, 0xCD };第3步:执行位移与填充
为了实现将数值 `B` 的低4个字节(4个 byte,共32位)依次放入数组后续位置,我们从最高有效字节开始处理,依次向左移动8位:
A[4] = (B >> 24) & 0xFF;    // 取最高8位放入第5个索引
A[5] = (B >> 16) & 0xFF;    // 取次高8位放入第6个索引
A[6] = (B >> 8)  & 0xFF;    // 取次低8位放入第7个索引
A[7] = (B >> 0)  & 0xFF;    // 取最低8位放入第8个索引
逻辑说明:
- `B >> 24`:将原本位于最左侧的第8个字节移动到最右侧,便于截取。
- `& 0xFF`:强制只保留结果的最后8位,其余高位全部清零。这是防止数据污染的关键操作。
完整验证代码
以下代码整合了上述步骤,并在循环中使用 `printf` 格式化输出每个元素的16进制值,以观察最终结果:
#include<stdio.h>
int main()
{
	double b = 123456789.987;
	__int64 B = (__int64)b;
	unsigned char A[46] = { 0x12, 0xAB, 0x34, 0xCD };

	// 进行字节填充
	A[4] = (B >> 24) & 0xFF;
	A[5] = (B >> 16) & 0xFF;
	A[6] = (B >> 8)  & 0xFF;
	A[7] = (B >> 0)  & 0xFF;

	// 遍历前8个元素进行打印测试
	for (int i = 0; i < 8; i++)
	{
		printf("%02X ", A[i]);
	}
	return 0;
}
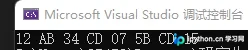
编译运行后,控制台将输出对应的16进制序列:
注意事项与扩展
- 大小端序问题:上面的示例采用的是将最高字节放在低索引位置(类似网络字节序/大端序)。如果你的硬件平台是小端序且要求相反的顺序,可以调整赋值顺序或使用联合体(Union)技巧。
- 安全性检查:在真实项目中,请务必确认数组 `A` 的索引不会越界(如本例中 `A` 至少要有8个元素才能访问到 `A[7]`)。
- 替代方法:除了位移,也可以使用 `memcpy` 直接复制内存块,但需注意目标缓冲区的对齐及长度控制,位移法则更利于针对特定字节范围进行精细操作。
以上就是关于C++中将十进制数据转换为16进制字节数组并输出的详细内容,更多关于C++串口数据处理与进制转换的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















