


C++实现MySQL数据库连接池:原理、代码与性能优化

在C++后端开发中,频繁的数据库连接创建与销毁是主要性能瓶颈之一。本文详细解析如何从零构建一个线程安全的MySQL数据库连接池,涵盖单例设计、队列管理、超时控制及智能指针回收机制,并通过多组压力测试代码验证其在单线程与多线程环境下的性能提升效果。
为何需要数据库连接池
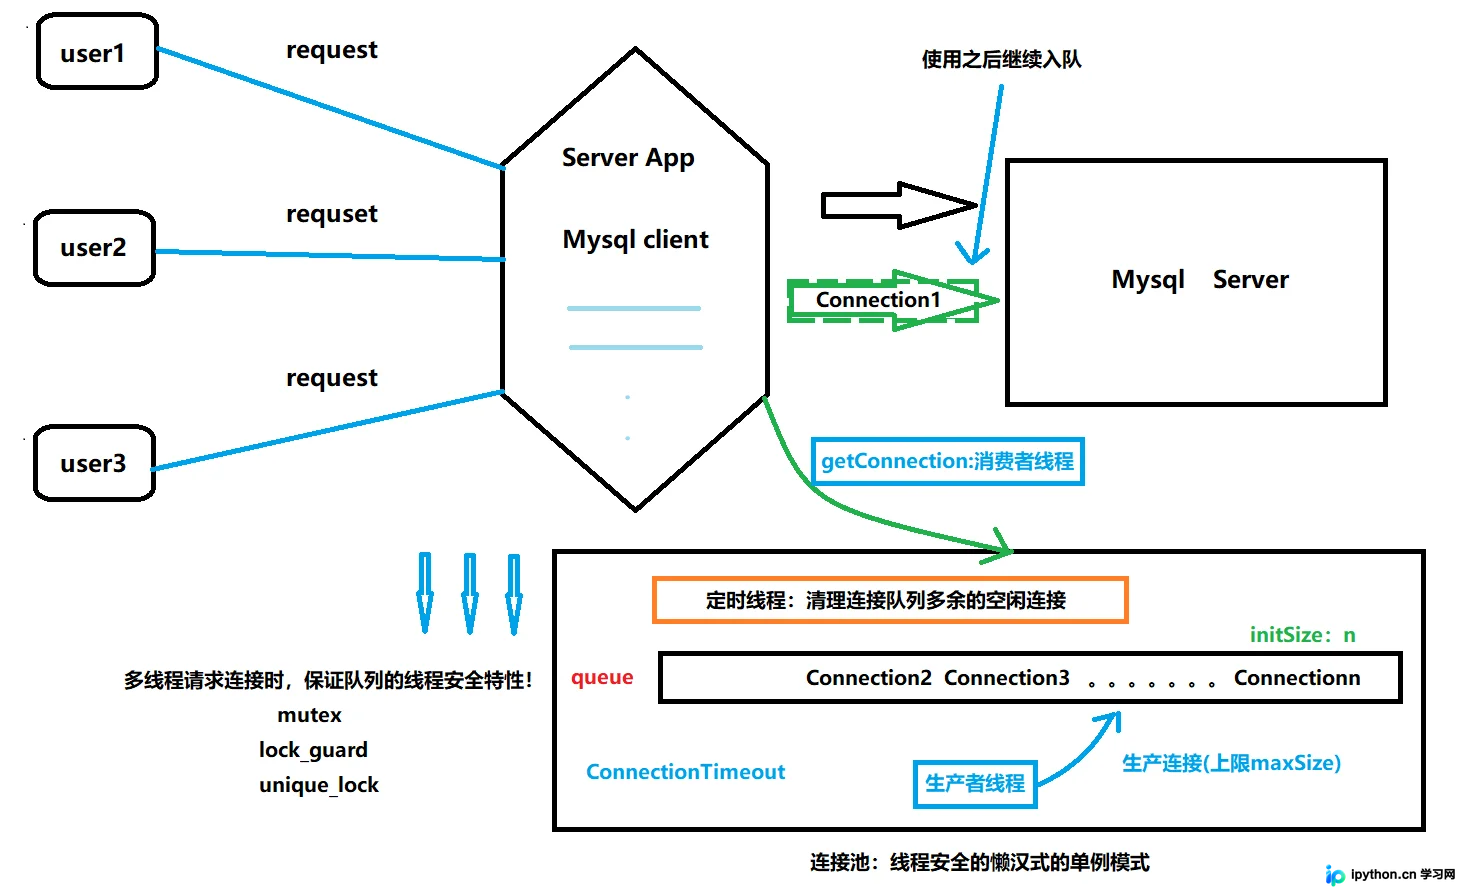
MySQL等关系型数据库基于C/S架构,客户端每一次交互都涉及TCP三次握手、身份认证、SQL执行以及TCP四次挥手释放资源。在高并发场景下,这些网络IO和系统调用会消耗大量CPU和内存资源,导致数据库服务器响应变慢甚至挂起。
常见的优化手段包括引入Redis缓存热点数据,或在服务端维护一个“连接池”。连接池预先创建一定数量的数据库连接并保持复用。应用发起请求时直接获取可用连接,操作完成后将连接归还至池中而非真正关闭。这消除了重复建连和断连的开销,显著提升吞吐量。
连接池核心功能设计
一个健壮的连接池需包含以下关键参数与逻辑:
- 初始连接量(initSize):服务启动时预创建的连接数量。确保系统冷启动后能立即处理请求,无需即时等待TCP握手。
- 最大连接量(maxSize):池内允许存在的最大连接数。受限于文件描述符和服务器内存,防止因连接泄漏或突发流量撑爆服务器资源。
- 最大空闲时间(maxIdleTime):连接在池中被标记为空闲的最长时间。超过此时限且未达到最小连接数的多余连接将被主动断开,以释放底层Socket资源。
- 连接超时时间(connectionTimeout):当池中无空闲连接且已达上限时,用户线程阻塞等待的时长。超时未获取到连接则返回失败,避免无限期挂起引发雪崩。
关键技术实现步骤
第1步:封装MySQL数据库连接类
首先需要对Oracle官方提供的C/C++ API进行轻量级封装,屏蔽底层细节。此类负责维护单一的MYSQL*指针,并提供连接、查询和更新方法。其中,记录进入空闲状态的起始时间戳对于后续的空闲回收至关重要。
class Connection
{
public:
    // 初始化底层句柄
    Connection();
    ~Connection();

    // 建立物理连接
    bool connect(string ip, unsigned short port,
                 string user, string password, string dbname);

    // DML操作
    bool update(string sql);
    // DQL操作,返回结果集
    MYSQL_RES* query(string sql);

    // 刷新最后一次使用时间
    void refreshAliveTime() { _alivetime = clock(); }
    // 计算当前空闲存活时间
    clock_t getAliveTime() const { return clock() - _alivetime; }
private:
    MYSQL* _conn;
    clock_t _alivetime;
};
在Windows环境下编译此模块前,需在IDE配置中完成以下设置:
- C/C++ → 常规 → 附加包含目录:添加
mysql.h所在的头文件路径。 - 链接器 → 常规 → 附加库目录:指向
libmysql.lib所在文件夹。 - 链接器 → 输入 → 附加依赖项:填入
libmysql.lib。 - 运行时依赖:将同架构的
libmysql.dll放置于工程输出目录。
第2步:构建线程安全单例模式
全局只需一个连接池实例。为保证在多线程环境中首次调用时的绝对安全且无需额外加锁,利用C++11标准中静态局部变量的特性实现懒汉式单例。
// Header
static ConnectionPool* getConnectionPool();

// Implementation
ConnectionPool* ConnectionPool::getConnectionPool()
{
    static ConnectionPool pool; // 编译器自动保证首次初始化的线程安全
    return &pool;
}
第3步:连接队列管理与初始化
连接池内部维护一个线程安全的队列。构造函数读取配置文件获取ip, port等信息,并根据initSize循环创建连接对象放入队列。
ConnectionPool::ConnectionPool()
{
    if (!loadConfigFile()) return;

    for (int i = 0; i < _initSize; ++i)
    {
        Connection* p = new Connection();
        p->connect(_ip, _port, _username, _password, _dbname);
        p->refreshAliveTime(); // 记录初始时间
        _connectionQue.push(p);
        _connectionCnt++;      // 使用atomic_int保证原子性
    }
}
第4步:多线程同步与生产者-消费者模型
为了应对突发流量,需在一个独立的后台线程中担任“生产者”角色。当检测到消费者需求但队列为空时,若总连接数未超maxSize,则新建连接并加入队列;否则进入等待状态。
// 生产线程逻辑片段
for (;;) {
    unique_lock lock(_queueMutex);
    // 只有队列空且达到上限时才真正等待唤醒
    cv.wait(lock, [this] { return !_connectionQue.empty() || _connectionCnt < _maxSize; });

    if (_connectionCnt < _maxSize) {
        Connection* p = new Connection();
        p->connect(...);
        _connectionQue.push(p);
        _connectionCnt++;
    }
    cv.notify_all(); // 通知消费者有新连接可取
} 同时,定义一个定时扫描线程专门用于清理“僵尸”连接。该线程周期性检查队首连接的空闲时长,若超过maxIdleTime且总连接数大于initSize,则弹出并销毁该连接,从而动态调节池大小。
第5步:智能指针定制删除器归还连接
外部业务层不应手动delete连接对象。通过shared_ptr结合Lambda表达式自定义析构行为:当智能指针作用域结束或重置时,自动将连接置回队列头部并刷新时间戳。
// 获取连接的接口实现
shared_ptr ConnectionPool::getConnection() {
    unique_lock lock(_queueMutex);
    while (_connectionQue.empty()) {
        // 此处可根据业务需求增加超时等待逻辑
        // ...
    }
    Connection* p = _connectionQue.front();
    _connectionQue.pop();

    // 绑定归还逻辑到智能指针
    return shared_ptr(p, [this](Connection* conn) {
        unique_lock lk(_queueMutex);
        conn->refreshAliveTime();
        _connectionQue.push(conn);
        cv.notify_one();
    });
}
性能压测与对比分析
为验证连接池的实际效果,编写了相同的插入负载(1000条记录),分别对比未使用池(直连)与使用池的场景。
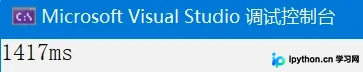
场景一:单线程插入1000条
在未使用连接池的情况下,每次循环均需经历完整的TCP建连、认证、执行、断连过程。
int main() {
    clock_t begin = clock();
    for(int i=0; i<1000; ++i) {
        Connection conn;
        conn.connect("127.0.0.1", 3306, "root", "password", "test_db");
        char sql[1024]; sprintf(sql, "INSERT INTO t VALUES('%s',%d)", "a", i);
        conn.update(sql);
    }
    cout << (clock()-begin) << "ms" << endl;
}
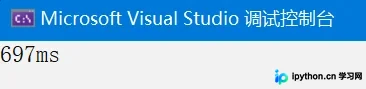
场景二:使用连接池单线程插入
通过连接池获取shared_ptr执行操作,利用完毕后自动归还。
int main() {
    clock_t begin = clock();
    ConnectionPool* cp = ConnectionPool::getInstance();
    for(int i=0; i<1000; ++i) {
        shared_ptr sp = cp->getConnection();
        char sql[1024]; sprintf(sql, "INSERT INTO t VALUES('%s',%d)", "a", i);
        sp->update(sql); // 退出block自动归还
    }
    cout << (clock()-begin) << "ms" << endl;
} 
场景三:多线程并发对比
开启4个线程各执行250次插入。直连方式下,4个线程并发争抢Socket资源及认证通道,耗时波动较大;连接池模式下,由于连接已预先准备好且处于活跃状态,整体耗时进一步降低。
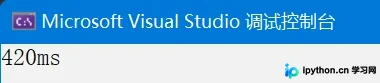
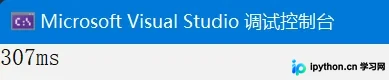
根据实际运行日志观察,引入连接池后,单次批量任务的执行时间通常有30%-50%的缩减,且有效抑制了并发高峰期的数据库拒绝连接现象。
总结
C++实现数据库连接池的核心在于合理利用现代C++特性(如智能指针、原子变量、条件变量)来解决底层的资源复用与线程安全问题。通过预设连接、动态扩容、超时剔除及安全归还四大机制,开发者可以在不依赖第三方重型库的情况下,构建出满足企业级高并发要求的数据库访问中间件。以上就是C++实现数据库连接池的详细教程,更多关于高性能网络编程与数据库优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















