


MySQL SQL语法顺序与解析原理详解

掌握SQL是访问关系型数据库的基础技能。许多开发者习惯按照SELECT...FROM...WHERE的顺序编写代码,但数据库引擎在后台却是按照完全不同的逻辑进行处理的。了解SQL语法与解析顺序的区别,对于排查性能瓶颈和处理复杂的JOIN与分组逻辑至关重要。
SQL语言的核心分类
SQL(Structured Query Language)作为一种标准的关系型数据库语言,广泛应用于Oracle、DB2、PostgreSQL及MySQL等产品中。随着NoSQL技术的发展,传统非关系型数据库也在不同程度上兼容了SQL接口。根据功能的不同,SQL主要划分为以下四类:
- DDL(数据定义语言):用于构建或修改数据库结构,如创建和删除表,涉及
CREATE、ALTER、DROP等关键字。 - DML(数据操作语言):负责处理表内的记录数据,包括插入、更新和删除,典型命令为
INSERT、UPDATE、DELETE。 - DCL(数据控制语言):管理数据库的安全性和权限分配,例如使用
GRANT赋予用户特定访问权。 - DQL(数据查询语言):主要用于检索数据,核心语句是
SELECT,配合FROM、WHERE等子句完成复杂查询。
虽然市面上有SQL 92、SQL 99等多种版本标准,但当前大多数数据库(如MySQL)均基于这些标准进行了扩展。例如MySQL独有的 LIMIT 关键字便不在早期国际规范之中。
SQL语法顺序与解析顺序的对比
初学者最容易混淆“写SQL的顺序”和“数据库解析SQL的顺序”。前者是为了方便人类阅读而设计的,后者则是数据库引擎实际执行的流程。下表清晰地展示了二者的差异:
第1步:明确语法规则与执行路径
目的:建立对SQL生命周期的宏观认知。
操作:对比参考以下代码块中的注释说明。
# === SQL编写时的语法顺序(由上至下) === SELECT DISTINCTFROM JOIN ON WHERE GROUP BY HAVING ORDER BY LIMIT # === 数据库引擎真实的解析顺序 === FROM ON JOIN WHERE GROUP BY HAVING SELECT -- 此时才真正去读取列 DISTINCT ORDER BY LIMIT
解析顺序表明,尽管我们在最前面写的是 SELECT,但实际上数据库最先处理的是确定数据来源的 FROM 部分。这种机制决定了为什么 SELECT 中定义的别名不能在 WHERE 中使用,却可以在 ORDER BY 中使用。
第一步解析:FROM与笛卡尔积
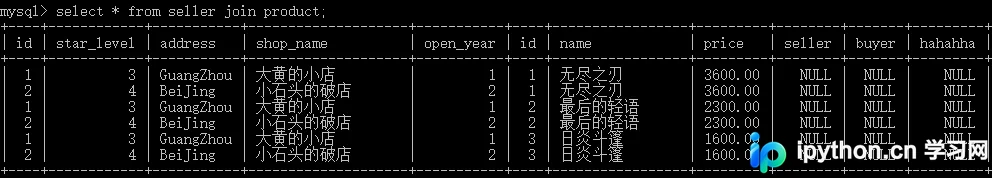
解析过程始于 FROM 子句。当涉及到多表连接时,数据库会先将 FROM 左边的表与右边的表进行笛卡尔积运算,生成一个临时虚表(VT1)。这个过程包含了所有行的组合,数据量通常会呈指数级增长。
select * from seller join product;
第二步解析:ON与连接筛选
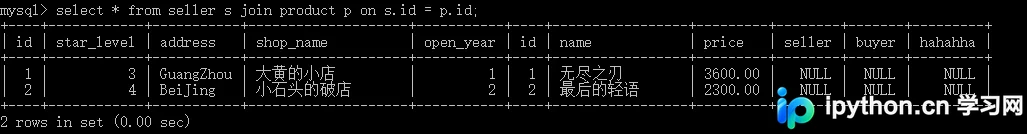
在生成 VT1 之后,系统会应用 ON 后面的条件进行严格筛选。只有满足 <join_condition> 条件的行才会被保留到新的虚表 VT2 中,其余不符合的行将被剔除。
select * from seller s join product p on s.id = p.id;
第三步解析:OUTER JOIN的特殊处理
如果是内连接(INNER JOIN),未匹配上的记录直接丢弃。但在外连接(LEFT/RIGHT OUTER JOIN)中,规则有所不同:
- LEFT (OUTER) JOIN:返回左表中所有的记录,以及右表中满足连接条件的记录。
- RIGHT (OUTER) JOIN:返回右表中所有的记录,以及左表中满足连接条件的记录。
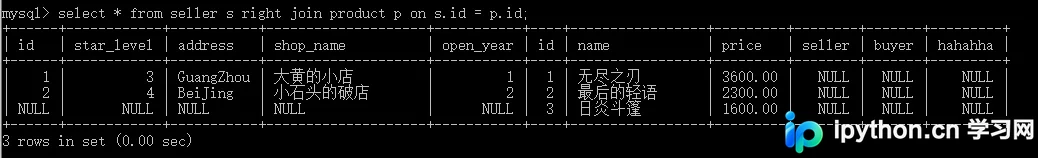
如果指定了外连接,即使某张表中存在未能在 ON 中匹配成功的行,这些行也会作为“外部行”被强制添加到结果集中(形成 VT3),并将另一侧缺失的字段用 NULL 填充。当存在多个表连续 JOIN 时,数据库会循环执行此步骤,将上一次的结果与下一张表进行同样的计算。
第四步解析:WHERE 行级过滤
经过连接操作后,WHERE 子句生效。它会对 VT3 中的每一行进行扫描,只保留符合 <where_condition> 的行。此时的条件通常不涉及聚合函数,针对的是原始字段的值。
第五步解析:GROUP BY 分组
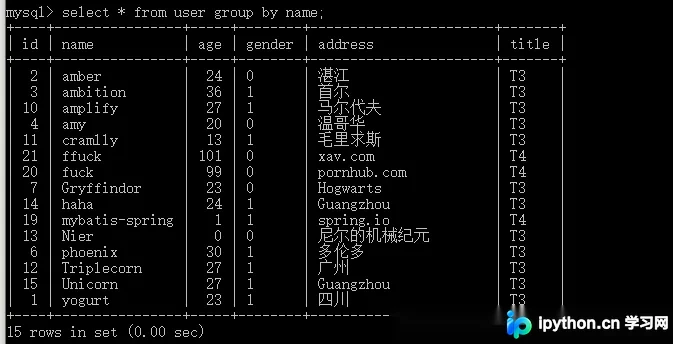
GROUP BY 将上一阶段剩下的结果集按照指定的列进行归类。在进行分组时,需要注意 MySQL 5.7+ 及默认配置下启用的 ONLY_FULL_GROUP_BY 模式。在这种模式下,未出现在 GROUP BY 子句中的列不能随意出现在 SELECT 列表中,除非它们被聚合函数包裹。
-- 查看当前 MySQL 版本及sql_mode设置
select version(),@@sql_mode;

-- 若需临时禁用该限制以便执行常规Group By(生产环境需谨慎)
set global sql_mode='STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_ENGINE_SUBSTITUTION';
set session sql_mode='STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_ENGINE_SUBSTITUTION';

-- 执行分组查询
select * from user group by name;
第六步解析:HAVING 组级过滤
分组完成后,系统应用 HAVING 条件。与 WHERE 不同,HAVING 可以包含聚合函数(如 COUNT()、SUM()),用于筛选符合统计标准的分组。例如,找出成绩总和超过80分的班级。
第七步解析:SELECT 选取投影
到了这一步,数据库才开始真正去“看” SELECT 后面指定的列名,并从内存中提取这些数据构建结果集。这也是为什么在 WHERE 子句中无法直接使用 SELECT 里的列别名——因为解析 WHERE 的时候,虚拟表里还没有这列数据。
第八步解析:DISTINCT 去重处理
如果语句中包含 DISTINCT,系统会根据 SELECT 选出的列集合对所有行进行去重比较。必须注意:DISTINCT 关键字必须紧接在 SELECT 之后。写在其他列之后(如 select id, distinct name from table;)会导致语法错误。同时,如果要实现基于某几列的组合唯一性,只需将它们一同放入 DISTINCT 后即可,这等同于对这多列做了拼接后再去重。
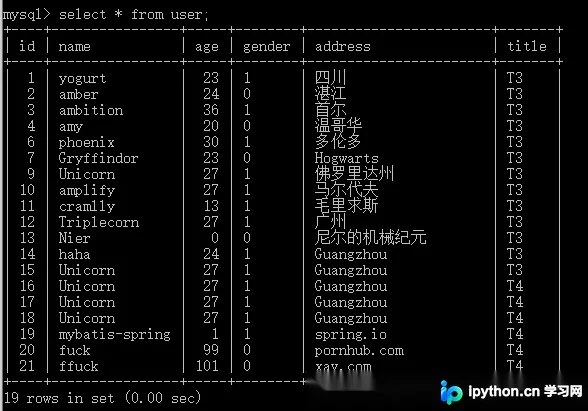
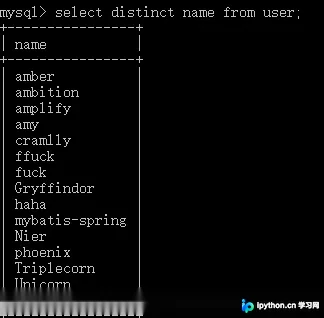
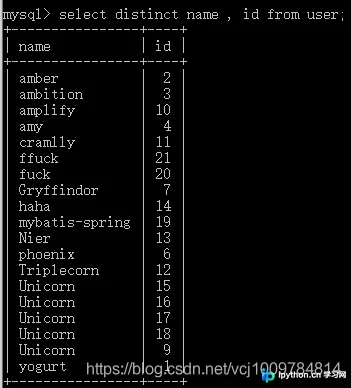
如果在 MySQL 中遇到需要基于某一列去重且返回整行数据的场景(即取最新或第一条记录),使用 DISTINCT 往往难以达到预期效果,此时更推荐使用窗口函数或 GROUP BY 配合最大索引的方式来实现。
第九步解析:ORDER BY 排序输出
此时数据已完成所有筛选与计算,最后通过 ORDER BY 指定升序(ASC)或降序(DESC)排列。需要注意的是,由于排序发生在最后一步,此时完全可以使用在 SELECT 中定义的字段别名来进行排序。
第十步解析:LIMIT 分页截断
这是 MySQL 特有的扩展语法,用于限制返回的最大行数或指定偏移量。由于它在解析树的绝对末尾执行,因此能够高效地控制最终呈现给客户端的数据规模。

总结
理解 SQL 的真正执行顺序能帮助我们在面对复杂查询时避免逻辑陷阱。无论是处理多表关联的空值填充,还是利用分组聚合进行数据分析,遵循“先定源(FROM)、再过滤(WHERE/HAVING)、后排序(LIMIT)”的思维路径,能让编写的 SQL 更加严谨高效。以上就是MySQL学习之SQL语法及SQL解析顺序的详细内容,更多关于SQL基础优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















