


Go 语言 pprof 性能分析与优化实战

本文详细讲解 Golang 中使用 pprof 进行性能分析的三种主要类型:CPU、内存及阻塞分析。通过具体的代码示例,演示如何生成分析文件并利用内置工具或第三方库进行可视化的瓶颈排查。重点分析了字符串拼接导致的内存分配过高问题,并提供使用 strings.Builder 的优化方案。最后介绍了如何在基准测试(Benchmark)中直接生成 profile 数据以辅助性能调优。
一、Golang 性能分析的主要类型
Go 语言的运行时提供了强大的性能剖析能力,主要通过采样机制来采集程序运行时的状态。常见的分析维度包括以下三类:
1. CPU 性能分析
CPU 性能分析是定位热点代码最常用的手段。启动后,Go 运行时默认每隔 10ms 进行一次中断采样,记录当前正在运行的协程堆栈信息。通过分析收集到的数据,可以找出消耗时间占比最高的代码路径。函数在采样中出现的频率越高,说明其执行耗时越长。
2. 内存性能分析
该分析专注于堆内存(Heap)的分配情况,忽略栈内存。默认配置下,每发生 1000 次内存分配采样一次,此比例可通过参数调整。由于采用采样方式,只能大致评估内存使用趋势,难以做到绝对精确的全量统计。
3. 阻塞性能分析
这是 Go 并发编程特有的分析类型,用于记录协程等待共享资源所花费的时间,常用于发现并发瓶颈。典型阻塞场景包括:在无缓冲信道上发送/接收数据、信道满/空时读写、以及获取已被占用的互斥锁等。通常建议在解决 CPU 和内存瓶颈后,再深入分析此类问题。
二、CPU 性能分析实操
本节以一段冒泡排序代码为例,演示如何通过标准库 runtime/pprof 进行 CPU 分析并查看结果。
第1步:编写被测代码
首先创建一个简单的生成随机数并排序的程序 main.go:
package main
import (
	"math/rand"
	"time"
)

func generate(n int) []int {
	rand.Seed(time.Now().UnixNano())
	nums := make([]int, 0)
	for i := 0; i < n; i++ {
		nums = append(nums, rand.Int())
	}
	return nums
}

func bubbleSort(nums []int) {
	for i := 0; i < len(nums); i++ {
		for j := 1; j < len(nums)-i; j++ {
			if nums[j] < nums[j-1] {
				nums[j], nums[j-1] = nums[j-1], nums[j]
			}
		}
	}
}

func main() {
	n := 10
	for i := 0; i < 5; i++ {
		nums := generate(n)
		bubbleSort(nums)
		n *= 10
	}
}
第2步:嵌入 Profiling 代码
在 main 函数入口处引入 pprof 包并开启 CPU 分析:
import (
	"math/rand"
	"os"
	"runtime/pprof"
	"time"
)

func main() {
	// 开始 CPU Profile,输出到标准输出
	pprof.StartCPUProfile(os.Stdout)
	defer pprof.StopCPUProfile()

	// ... 原有业务逻辑 ...
}
运行命令并将输出重定向至文件,即可得到性能数据:
go run main.go > cpu.pprof
第3步:分析数据与可视化
生成 cpu.pprof 文件后,可以使用 Go 自带的工具启动 Web 界面进行直观分析。确保系统已安装 Graphviz(Ubuntu 下执行 apt install graphviz):
go tool pprof -http=:9999 cpu.pprof
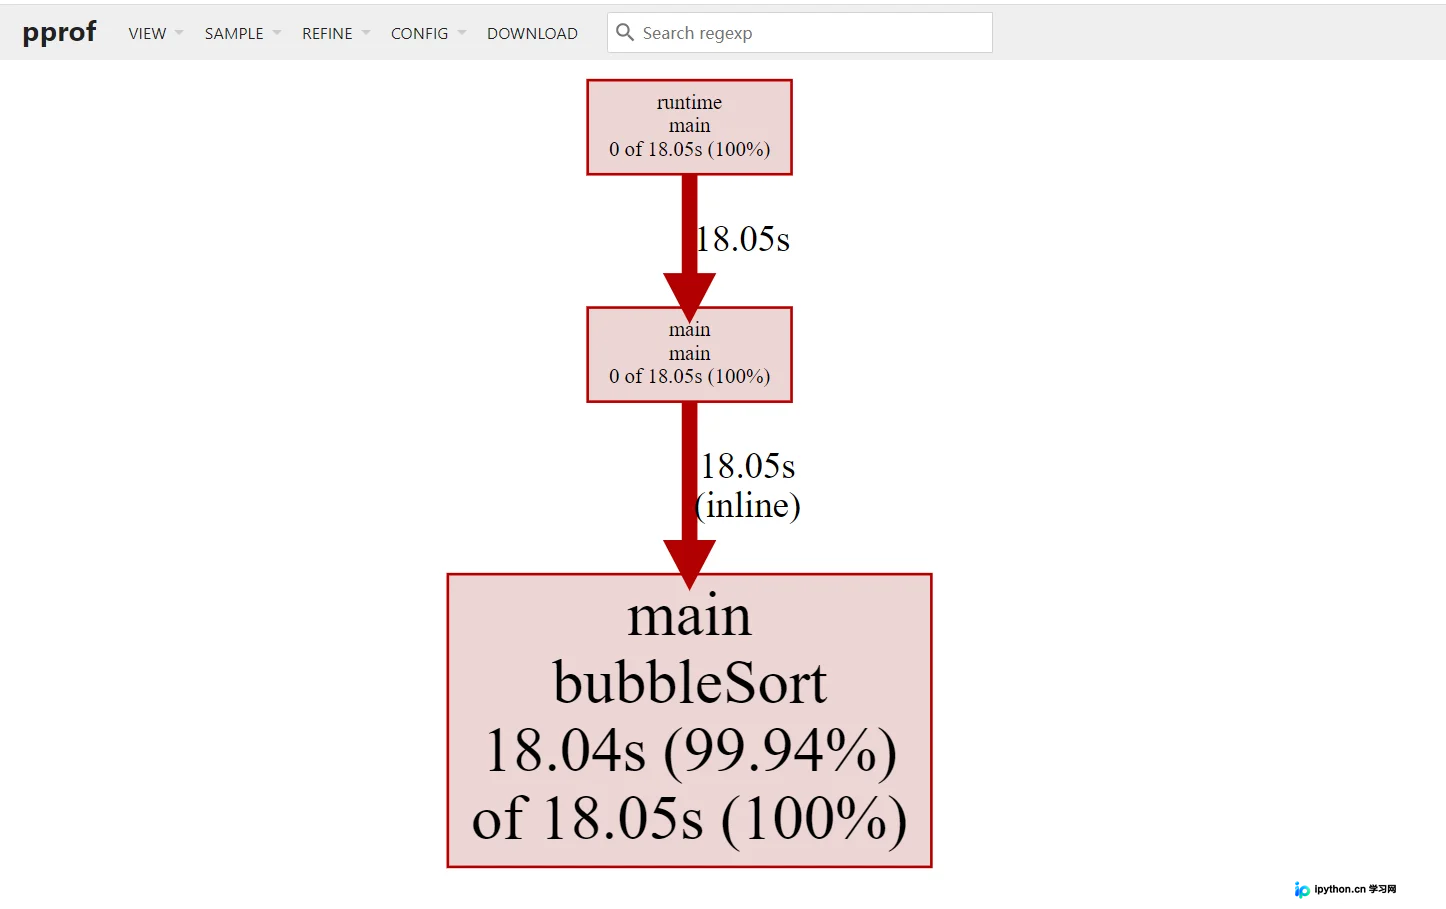
访问 localhost:9999 可以看到调用关系图。除了 Web 界面,也可以使用交互式命令行进行深入分析。启动命令如下:
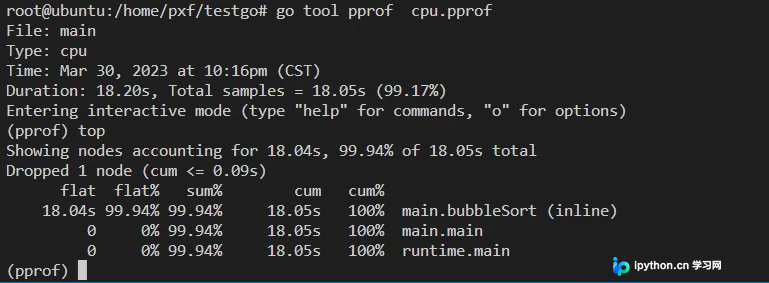
go tool pprof cpu.pprof
在交互界面中,使用 top 命令可查看占用 CPU 最高的函数。从图中可见 bubbleSort 函数因双重循环导致较高的 CPU 消耗:
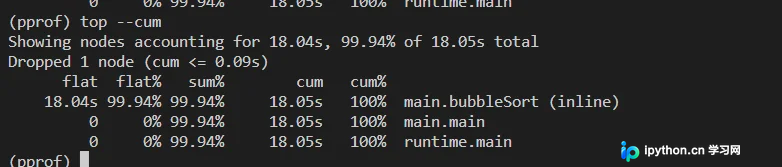
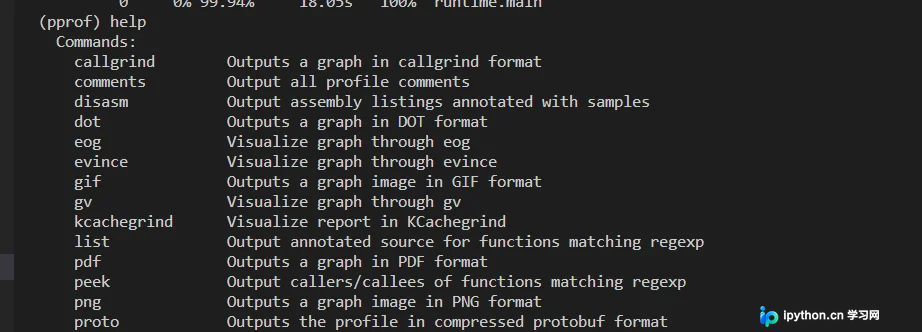
若需按累计消耗排序,可使用 top --cum。此外,输入 help 可查看所有支持的命令:
三、内存性能分析与优化
字符串处理是 Go 程序中常见的性能瓶颈点。由于 Go 的字符串是不可变的(immutable),使用 + 进行拼接会创建新的字符串对象,导致频繁的内存分配。
1. 问题复现与分析
使用第三方库 github.com/pkg/profile 可以简化内存分析的植入过程。它封装了 runtime/pprof,仅需一行代码即可开启:
defer profile.Start(profile.MemProfile, profile.MemProfileRate(1)).Stop()
这段代码会将内存 Profile 写入 /tmp 目录下的临时文件中。随后通过以下命令启动分析服务:
go tool pprof -http=:9999 /tmp/profile575547387/mem.pprof
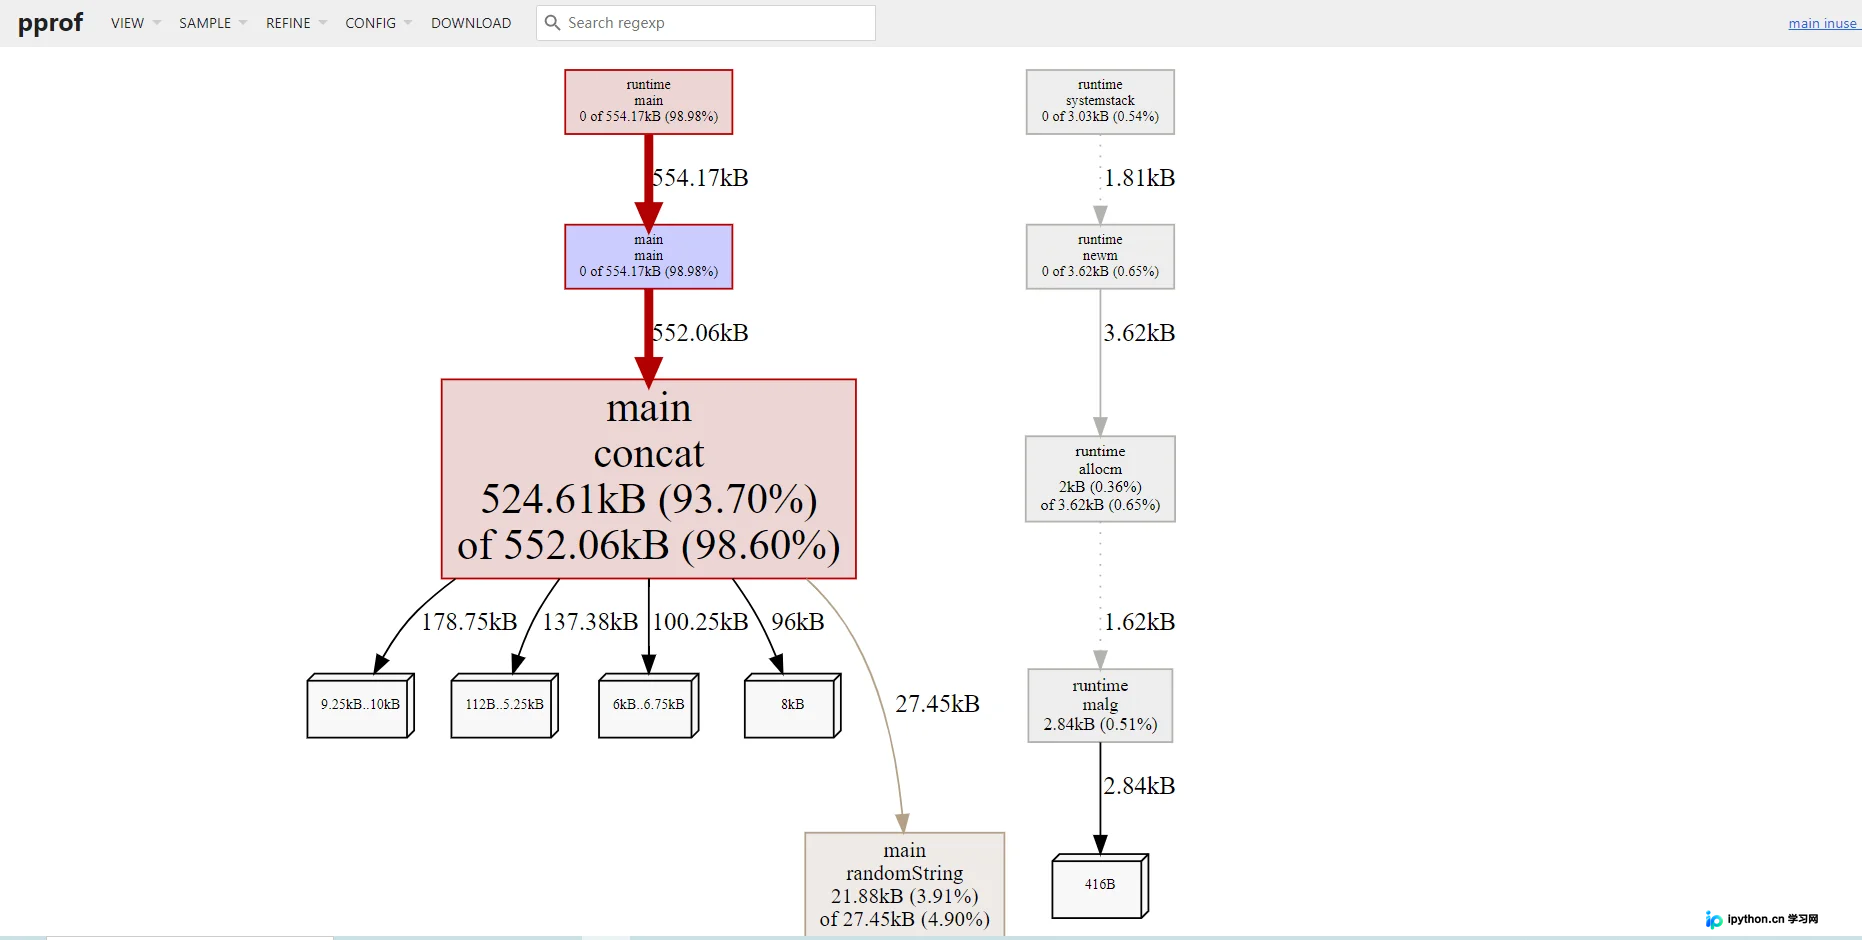
分析结果显示,负责拼接的 concat 函数消耗了约 524 KB 内存,远高于生成随机字符的 randomString(21 KB)。这是因为每次 s += ... 操作都会重新分配内存并拷贝旧内容。
2. 使用 strings.Builder 优化
针对频繁字符串拼接的场景,推荐使用 strings.Builder。它是一个可变缓冲区,内部预先分配空间,仅在必要时扩容,从而大幅减少内存分配次数。
优化后的代码如下:
package main
import (
	"math/rand"
	"strings"
	"github.com/pkg/profile"
)

const letterBytes = "abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ"

func randomString(n int) string {
	b := make([]byte, n)
	for i := range b {
		b[i] = letterBytes[rand.Intn(len(letterBytes))]
	}
	return string(b)
}

func concat(n int) string {
	sb := new(strings.Builder) // 使用 Builder
	for i := 0; i < n; i++ {
		sb.WriteString(randomString(n))
	}
	return sb.String()
}

func main() {
	defer profile.Start(profile.MemProfile, profile.MemProfileRate(1)).Stop()
	concat(100)
}
再次进行内存分析,观察结果:
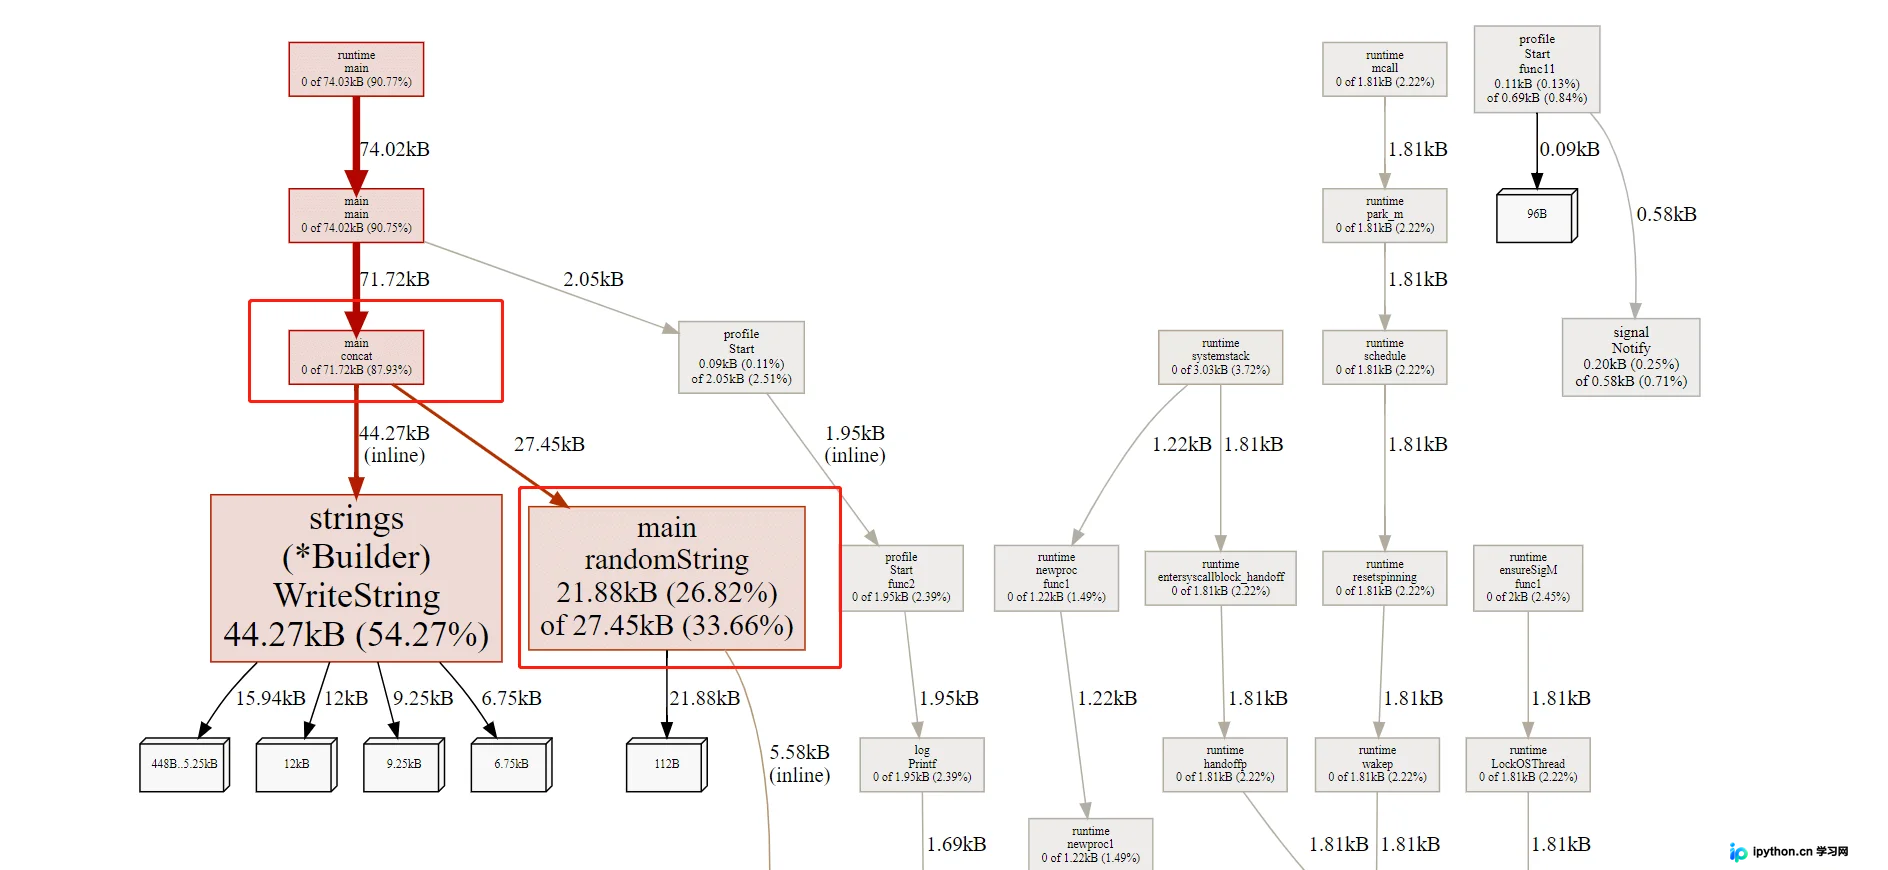
优化后,concat 函数的内存消耗降至 71 KB,显著减少了垃圾回收的压力。
四、Benchmark 生成 Profile
在进行基准测试(Benchmark)时,除了看耗时对比,还可以直接生成 Profile 文件以便后续深入分析。Go 的测试工具支持多种 Profile 生成参数:
-cpuprofile=$FILE:生成 CPU 分析文件。-memprofile=$FILE配合-memprofilerate=N:控制内存采样的密度。-blockprofile=$FILE:生成阻塞分析文件。
假设有一个斐波那契数列的测试文件 fib_test.go:
package fib
import "testing"

func fib(n int) int {
	if n == 0 || n == 1 {
		return n
	}
	return fib(n-2) + fib(n-1)
}

func BenchmarkFib(b *testing.B) {
	for n := 0; n < b.N; n++ {
		fib(30)
	}
}
执行测试并指定输出文件:
go test -bench=. fib_test.go -cpuprofile=cpu.pprof
生成的 cpu.pprof 可直接被 go tool pprof 读取。需要注意的是,对于由 Benchmark 生成的文件,通常需要加上 -test 标志才能正确解析:
go tool pprof -test cpu.pprof
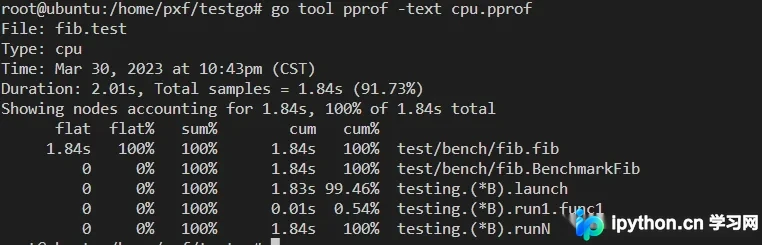
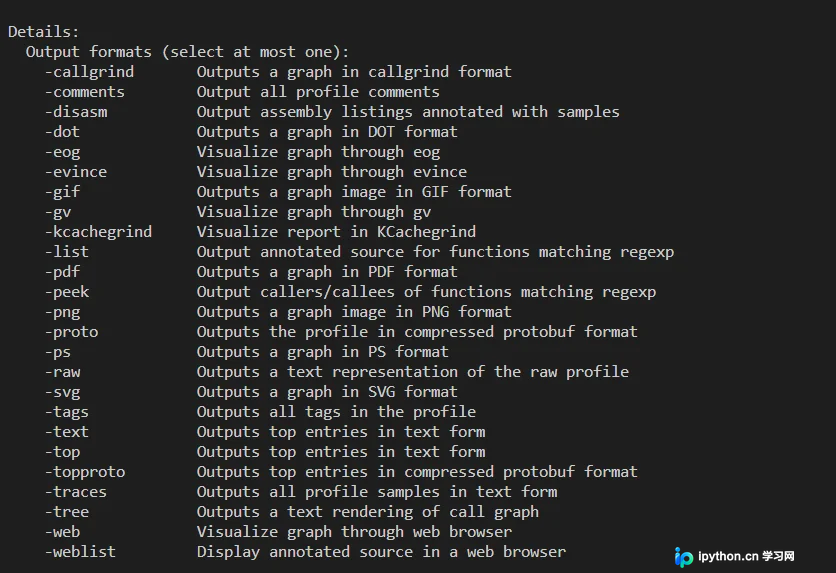
go tool pprof 支持导出多种格式(如 text, disassembly, callgrind 等),满足不同场景下的分析需求:
以上就是 Golang pprof 性能测试与分析的详细内容,更多关于 Go pprof 性能测试的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















