


深入理解Golang字符串的内存分配机制

Golang的字符串在内存中究竟如何分布?编译期的常量与运行时的拼接结果存在显著差异。本文将揭示`stringStruct`结构体的内部构成,分析只读数据段与堆栈空间的分配策略,并探讨利用`unsafe`包进行高效类型转换的原理与风险。
字符串的数据结构与内存区域
在Golang源码层面,字符串通过`stringStruct`结构体表示。要理解其内存行为,首先需明确以下核心结构:
type stringStruct struct {
   str unsafe.Pointer
   len int
}- str:类型为
unsafe.Pointer,通常8字节(64位系统)。绝大多数情况下指向.rodata(只读数据段),仅在特定运行时操作下指向堆或栈。 - len:整型变量,标识字符串长度。64位机占8字节,32位机占4字节。
综上,一个完整的字符串对象包含两部分内存资源:stringStruct结构体本身(随变量作用域位于栈或堆)以及str指针所指向的实际字符数据。
编译期确定的字符串
对于直接定义的字符串字面量,如a := "hello",编译器会在编译期处理其存储方式。
内存分配逻辑
- 结构体分配:
stringStruct作为变量的一部分,遵循标准的逃逸分析规则。若被外部引用则分配在堆上,否则分配在栈上。 - 内容分配:指针
str固定指向程序的.rodata区。该区域存放所有纯字面量字符串,是只读的。
相同字面量的合并机制
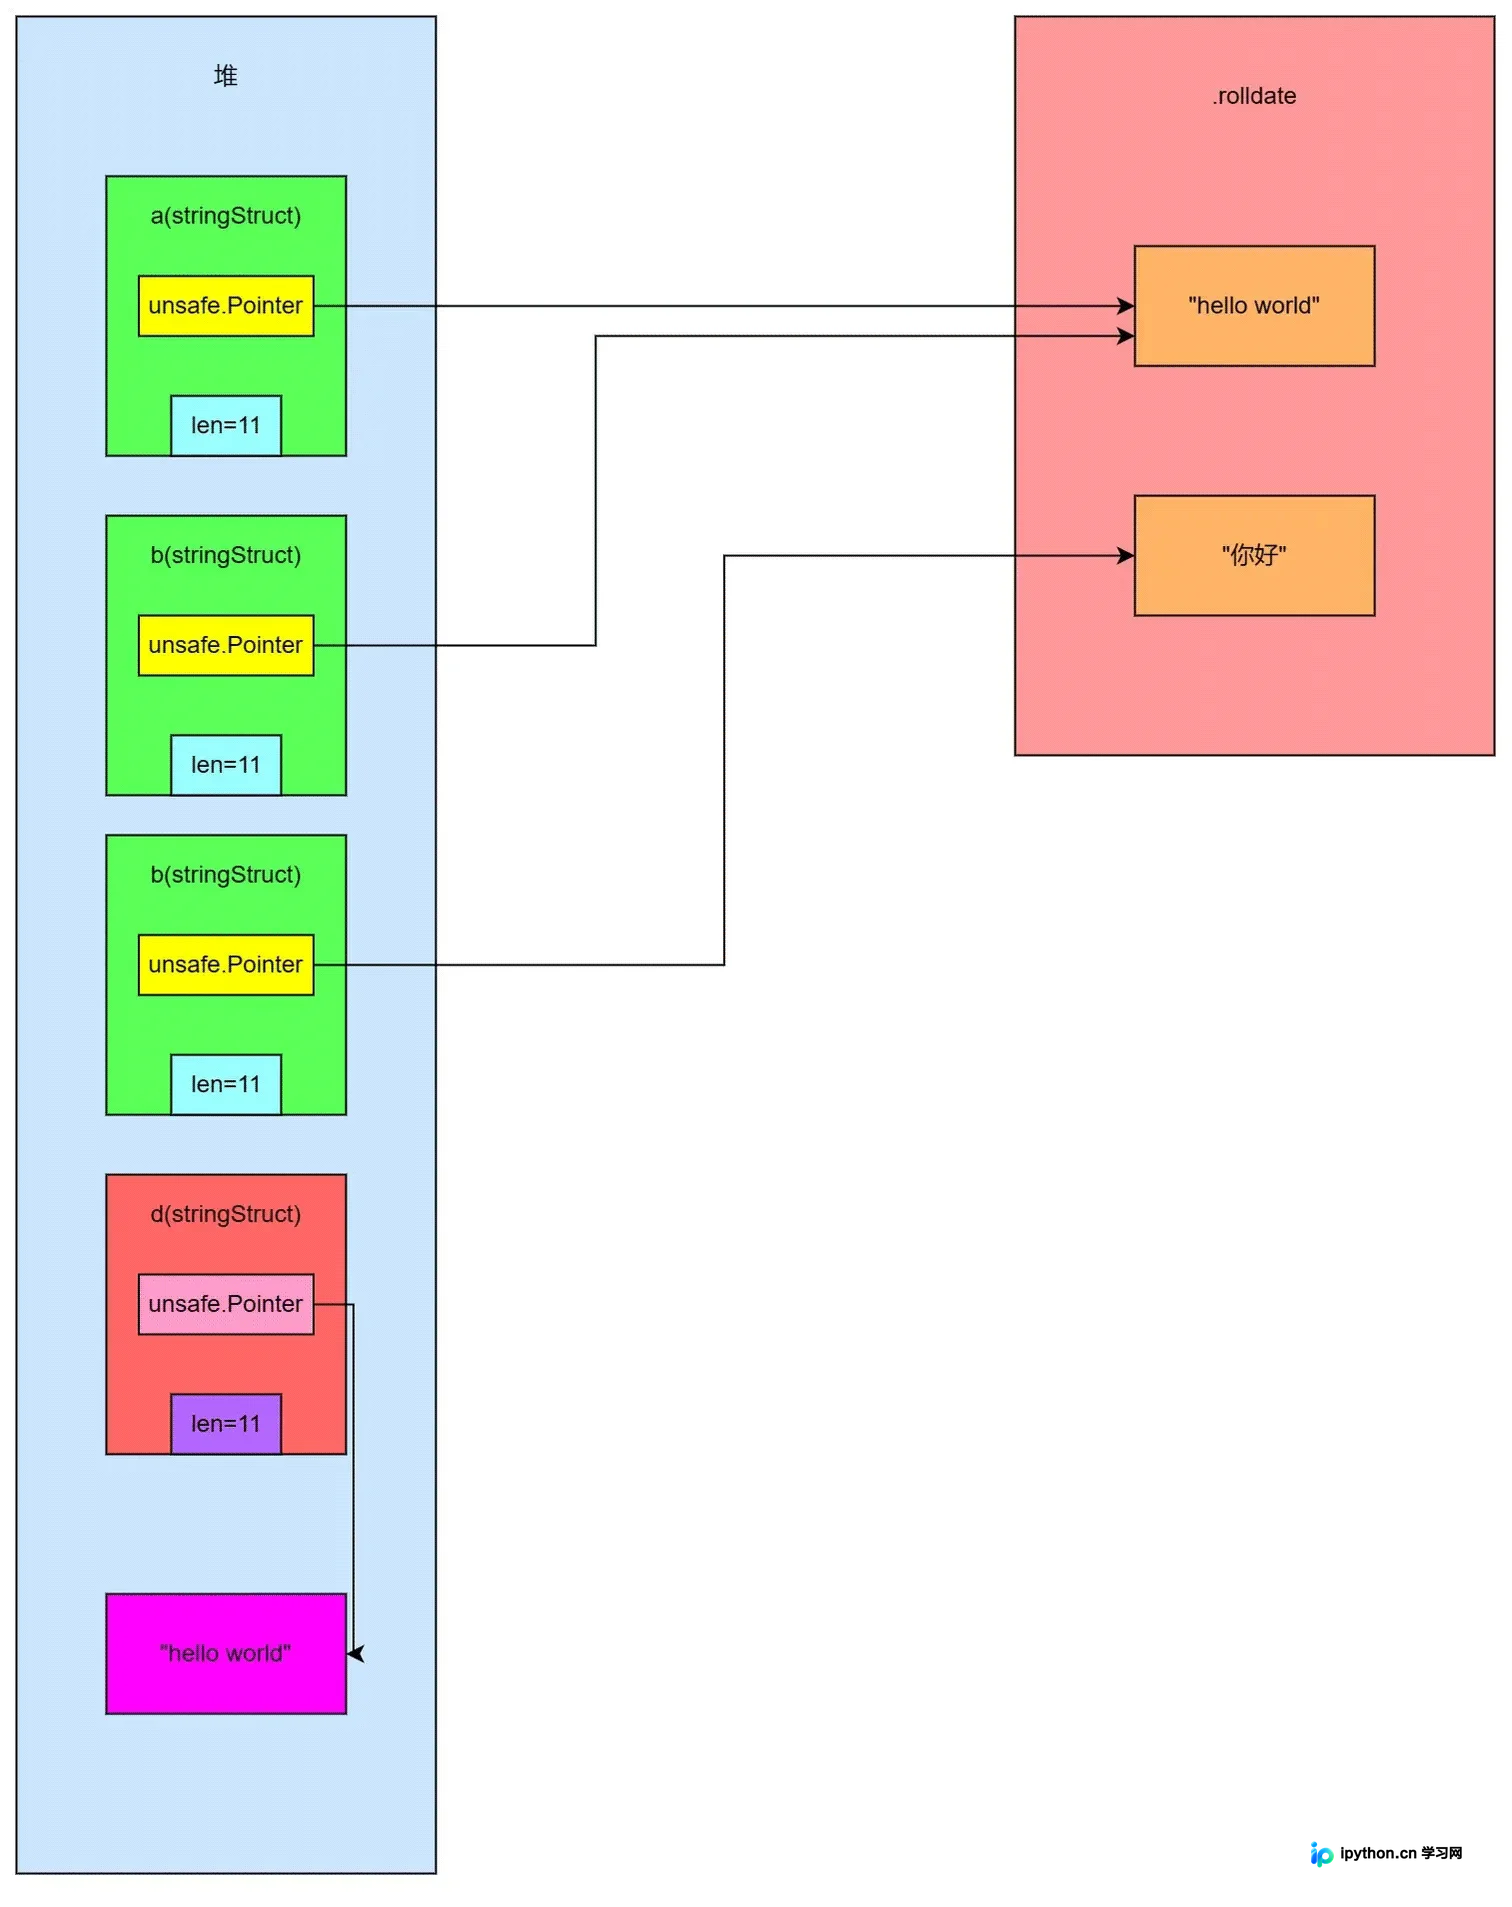
如果代码中出现多次相同的字符串字面量(如a := "hello world"和b := "hello world"),它们的stringStruct结构体会在不同地址创建,但str指针会复用.rodata中的同一块内存。
验证如下:获取两个变量的指针地址不同,但解析出的str指向完全一致。
//定义接收数据结构,镜像匹配stringStruct
type Reception struct {
   p unsafe.Pointer
   len int
}

func main() {
   a := "hello world"
   b := "hello world"

   //反射解析结构体
   rA := *(*Reception)(unsafe.Pointer(&a))
   rB := *(*Reception)(unsafe.Pointer(&b))

   fmt.Println(&a) // 输出不同的栈地址
   fmt.Println(&b)
   fmt.Println(rA.p) // 相同的.rodata地址
   fmt.Println(rB.p)
}
字面量拼接的合并情况
字符串常量的合并取决于编译器的优化策略。例如:
func main() {
   he := "hello"
   // 右值含变量,不合并
   str1 := he + "li" + "hua"
   // 纯字面量相加,编译器可能合并
   str2 := "ni" + "hao"
}使用go tool compile -m main.go分析可见,仅当表达式右侧全部为纯字面量时,编译器才可能在编译期将其合并为一个常量字符串,使其归入.rodata;否则将按运行时字符串处理。
运行时的字符串拼接
当字符串涉及变量运算或显式拼接时(如b := a + "world"),行为发生本质变化。
拼接后的内存归属
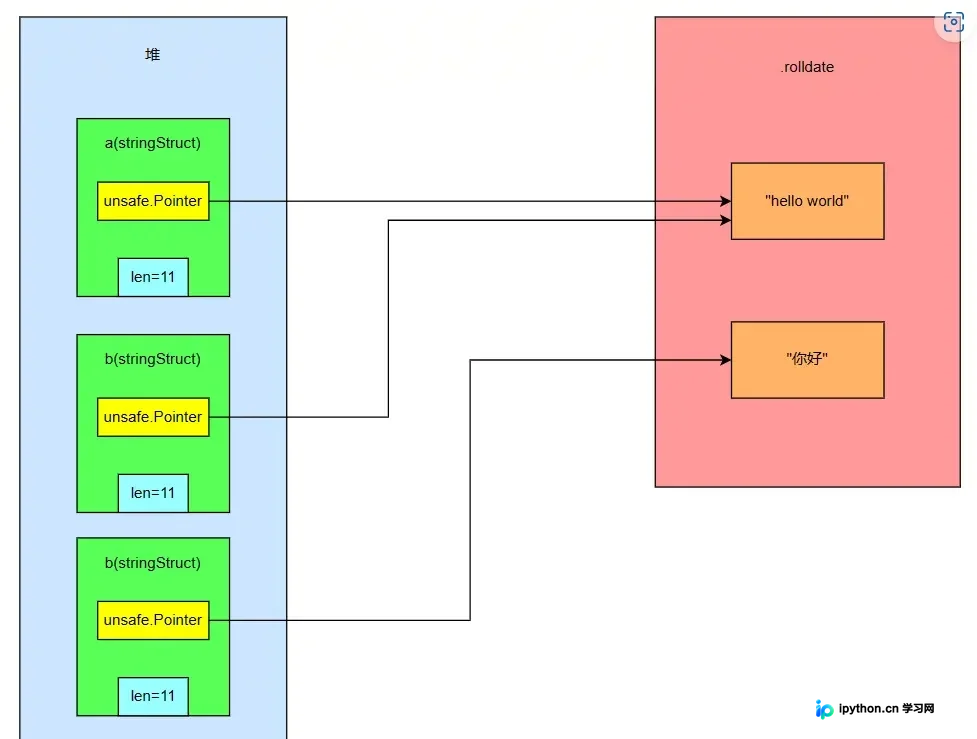
结论:stringStruct分配在栈或堆,其对应的内容数据(str指向处)同样被分配到堆或栈中,而不再是指向全局只读段。
编译器在汇编阶段会将+操作替换为内置函数concatstrings(buf *tmpBuf, a []string) string。执行流程如下:
- 计算长度:遍历参数数组,计算所有源字符串的总长度。
- 分配空间:调用
rawstringtmp。若传入栈缓冲区(buf != nil)则在栈分配,否则调用mallocgc在堆上开辟新内存。 - 拷贝数据:将各个源字符串的内容
copy到新分配的内存空间中。
因此,即使是相同的拼接组合,每次运行也会产生独立的str指针,它们互不共享内存。
关键函数 rawstring 剖析
rawstring负责在堆上分配内存并初始化字符串结构:
func rawstring(size int) (s string, b []byte) {
   p := mallocgc(uintptr(size), nil, false)
   stringStructOf(&s).str = p
   stringStructOf(&s).len = size
   // 让切片b指向同一片内存
   *(*slice)(unsafe.Pointer(&b)) = slice{p, size, size}
   return
}这里利用unsafe.Pointer强制将string类型的指针按照stringStruct的结构去解释,从而修改内部的str字段;同时也让返回的字节切片[]byte与字符串共享同一块堆内存。
字符串的可变性与修改
Golang规定字符串语义上不可变。尝试修改字符串内容通常会引起异常,具体表现取决于其存储位置。
修改 .rodata (致命错误)
若直接修改编译期字面量所在的只读区,程序将触发panic:
str := "hello world"
// 强行转为 byte slice 获取内存地址
byteArr := *(*[]byte)(unsafe.Pointer(&str))
byteArr[0] = 'w' // panic: segmentation fault
修改运行时分配的内存(可成功)
对于由拼接生成的、驻留在堆或栈上的字符串,由于内存是可写的,利用上述unsafe技巧可以篡改数据:
str := "hello"
str += "world" // 此时 str 指向堆内存
byteArr := *(*[]byte)(unsafe.Pointer(&str))
byteArr[0] = 'w'
fmt.Println(str) // 输出: wello world
高效的类型转换实践
常规转换会导致一次深拷贝,在高并发或高性能场景下可能成为瓶颈。利用unsafe可做到零拷贝转换,但需谨慎使用。
string 转 []byte
byteArr := *(*[]byte)(unsafe.Pointer(&str))
风险警告:
- 此方法极不安全。对byteArr的任何写操作都将直接影响原字符串。
- 创建的切片容量cap是不确定的(依赖内存布局残余数据),极易导致扩容越界崩溃。
[]byte 转 string
str := *(*string)(unsafe.Pointer(&byteArr))
相较于反向转换,这种方式更为安全。只要保证原始的byteArr在字符串生命周期内不被外部改变即可。实际上,strings.Builder的内部实现正是基于此原理。
func (b *Builder) String() string {
   return *(*string)(unsafe.Pointer(&b.buf))
}
总结建议
- 不要将Java的字符串常量池概念生搬硬套到Golang。
- 日常开发请使用标准库函数
string(bytes)避免内存问题。 - 仅在确认无性能问题且深刻理解内存模型的前提下,方考虑使用
unsafe优化。
 以上就是深入string理解Golang是怎样实现的的详细内容,更多关于Golang string实现原理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















