


Python 实现 DBSCAN 密度聚类算法详解与代码示例

DBSCAN(Density-Based Spatial Clustering of Applications with Noise)是一种基于密度的聚类算法。与需要预设簇数量的传统方法不同,它能自动发现任意形状的密集数据区域,并将低密度散点识别为噪声。本文梳理该算法的运行机制,并提供 Python 标准库调用、手写核心逻辑及可视化验证的完整实操步骤。
DBSCAN 密度聚类核心原理
DBSCAN 算法依靠空间点的分布密度进行分组。其运作依赖于两个关键参数:eps(邻域半径)和 min_samples(形成核心对象所需的最小样本数)。算法遍历数据集中的每一个点,计算其在 eps 范围内的邻居数量:
- 核心点:邻域内样本数大于等于
min_samples的点。 - 边界点:在核心点的邻域内,但自身未达到核心点标准的点。
- 噪声点:既不是核心点也不在任何核心点邻域内的孤立点。
算法从任意核心点出发,将其密度可达的所有点合并为一个簇,直到所有数据点都被扫描完毕。这种基于连通性的扩展方式使其天然支持非凸形状的聚类结构。
适用场景与参数调节逻辑
由于依赖密度阈值而非质心迭代,DBSCAN 在以下场景中表现突出:
- 不规则几何形态:能有效分离交叉、环形或月牙形等非线性排列的数据集。
- 含噪声数据:自动过滤异常值,避免将其强制归入某个簇导致轮廓扭曲。
- 未知簇数量:无需预先指定类别数,适合探索性数据分析。
需要注意的是,eps 过小会导致多数点被标记为噪声,过大则会将多个独立簇错误合并。当特征量纲差异较大时,建议先进行标准化处理,否则距离计算会受大数值维度主导。
第1步:调用 scikit-learn 快速生成标准聚类结果
在实际开发中,通常直接使用成熟的机器学习库完成建模。以下为使用 sklearn.cluster.DBSCAN 的基础流程:
from sklearn.cluster import DBSCAN
import numpy as np

# 创建二维样本数据
X = np.array([[1, 2], [2, 2], [2, 3], [8, 7], [8, 8], [25, 80]])

# 实例化模型并执行拟合
db = DBSCAN(eps=3, min_samples=2).fit(X)

# 提取每个点对应的簇标签(-1 代表噪声)
labels = db.labels_
print("Labels:", labels)
代码运行后,labels_ 属性返回一个数组,其中整数代表所属簇的编号,-1 表示未归属任何簇的噪声点。通过调整 eps 可直观观察簇的分裂或合并趋势。
第2步:还原核心逻辑手动编写聚类函数
为深入理解算法内部状态流转,可以使用纯 numpy 实现基础版聚类逻辑。该实现展示了距离计算、邻域筛选与标签分配的过程:
import numpy as np

def euclidean_distance(x, y):
    return np.sqrt(np.sum((x - y)**2))

def dbscan_manual(X, eps, min_samples):
    m = X.shape[0]
    labels = [0] * m  # 初始化标签数组
    cluster_id = 0

    for i in range(m):
        # 已处理的点跳过
        if labels[i] != 0:
            continue

        neighbors = []
        for j in range(m):
            if euclidean_distance(X[i], X[j]) < eps:
                neighbors.append(j)

        # 判断是否为核心点
        if len(neighbors) < min_samples:
            labels[i] = -1  # 标记为噪声
        else:
            cluster_id += 1
            labels[i] = cluster_id
            # 将邻域内所有未处理点纳入当前簇
            for j in neighbors:
                if labels[j] == 0:
                    labels[j] = cluster_id
    return labels

X = np.array([[1,2],[2,2],[2,3],[8,7],[8,8],[25,80]])
print(dbscan_manual(X, 3, 2))
此脚本仅用于教学演示。实际工程中数据量较大时,嵌套循环会导致性能瓶颈,建议改用 KD-Tree 或 Ball-Tree 进行空间索引加速。
第3步:处理复杂几何形态并可视化验证
验证 DBSCAN 处理非线性结构的最佳方式是引入具有明确簇边界的合成数据集。以下代码使用 make_moons 生成双半月形分布,并完成训练与绘图展示:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
from sklearn.cluster import DBSCAN

# 生成带噪声的月牙形数据集
X, y_true = make_moons(n_samples=200, noise=0.05, random_state=0)

# 初始化并训练模型
dbscan = DBSCAN(eps=0.3, min_samples=5)
y_pred = dbscan.fit_predict(X)

# 绘制聚类效果
plt.scatter(X[:, 0], X[:, 1], c=y_pred, cmap='viridis')
plt.title('DBSCAN Moon Dataset Clustering')
plt.show()
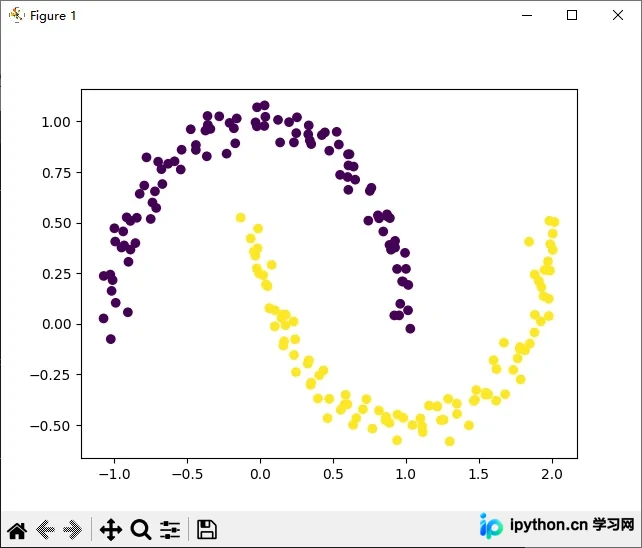
从图中可以清晰看出,算法成功沿着密度路径切分了两个月牙状簇,而未将两簇之间的空白区域强制填充。若调高 eps 至 0.5 以上,中间桥梁变宽,两簇可能会意外连通合并。
运行结果核对与常见问题排查
完成模型拟合后,可通过以下方式确认输出是否符合预期:
- 检查标签分布:使用
np.unique(labels, return_counts=True)统计各类别样本量。若-1占比超过30%,说明eps设置过小或数据稀疏度过高。 - 验证噪声隔离:人工挑出已知离群点坐标,确认其标签是否为
-1,以检验边界判定灵敏度。 - 维度灾难应对:当特征维度较高时,距离度量易失效。可配合 PCA 降维后再传入
DBSCAN,通常能将min_samples设置为维度数的两倍以获得更稳定的聚类。
总结
DBSCAN 凭借密度连通性机制,在处理任意形状簇与异常值检测方面具备显著优势。掌握 eps 与 min_samples 的物理含义,并结合业务数据的分布特征进行微调,是发挥该算法效能的关键。以上就是 Python 实现 DBSCAN 密度聚类算法详解与代码示例的详细内容,更多关于 Python 数据聚类与机器学习实战的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















