


深入解析Java ConcurrentHashMap存储流程与源码实现

ConcurrentHashMap是Java并发编程中的核心组件,面试与实战中常需深入理解其内部结构。本文聚焦于put操作的执行链路,从初始化的参数校验、Hash值的扰动处理,到具体的数组插入、链表挂载以及红黑树转化逻辑进行逐层剖析,阐明多线程环境下如何保证数据一致性与高效访问。
ConcurrentHashMap基础使用与存储特性
在构建高性能的后端应用时,面对多线程共享数据读取的场景,ConcurrentHashMap因其优异的并发性能成为首选方案。其基本API与HashMap保持一致,但在底层实现上采用了分段锁(JDK 1.7)或CAS配合synchronized(JDK 1.8+)等技术来实现线程安全。
以下为标准的创建与增删改查操作:
public class Test {
    public static void main(String[] args) {
        ConcurrentHashMap map = new ConcurrentHashMap<>();
        // 存放键值对
        map.put("key1", "value1");
        map.put("key2", "value2");
        // 修改现有Key对应的值
        map.put("key1", "newValue1");
        // 删除指定元素
        map.remove("key1");
        System.out.println(map.get("key2"));
    }
}
源码级存储流程详解
ConcurrentHashMap的`put`方法调用的是内部的`putVal`方法。整个流程可划分为几个关键阶段:入参校验与Hash计算、表(Table)的懒加载初始化、定位桶位并插入节点、处理冲突(链表或红黑树),以及在特定阈值下的结构转换。
第1步:初始化与Hash扰动计算
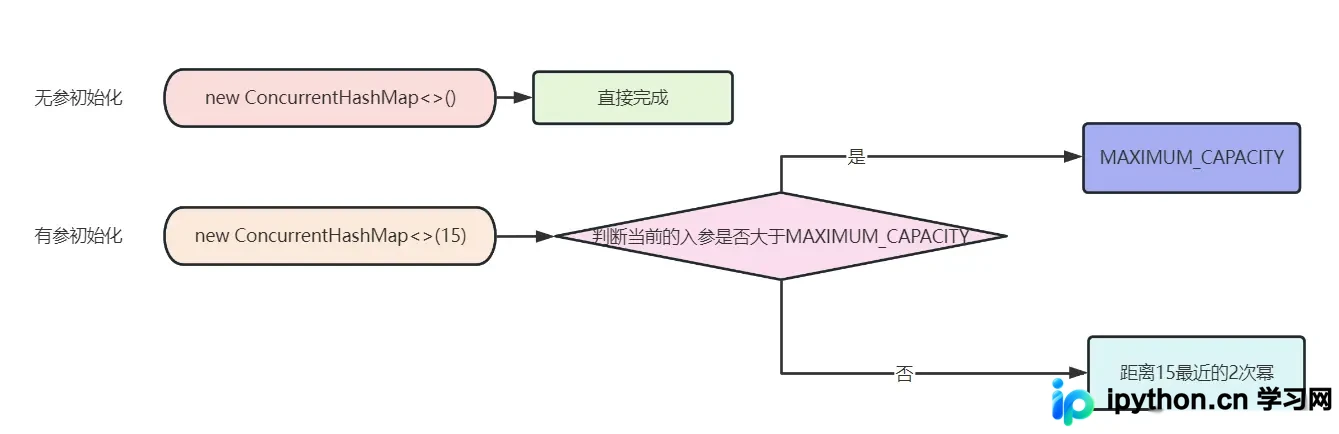
如果未传入构造参数,则默认使用空构造函数,此时不分配内存,仅在首次写入时初始化。
若显式指定了容量参数,系统会校验输入值是否为负数,并通过算法计算出大于等于目标容量的最小2的N次方幂(例如传入5,实际分配为8),并将其赋值给控制变量 `sizeCtl`。
当调用`put(key, value)`时,首先需要对Key的Hash值进行处理。由于部分对象的`hashCode()`返回值高位全为0,直接使用低位参与取模运算会造成Hash碰撞率过高。因此,ConcurrentHashMap采用了一个经典的散列函数(扰动处理):
(h ^ (h >>> 16)) & HASH_BITS。
这一操作让Hash值的高16位与低16位进行异或,使高低位特征都参与到最终下标的计算中,同时按位与 `HASH_BITS` 确保结果始终为正整数,避免与保留的特殊状态码(如MOVED=-1)冲突。
第2步:数组懒加载与初始化
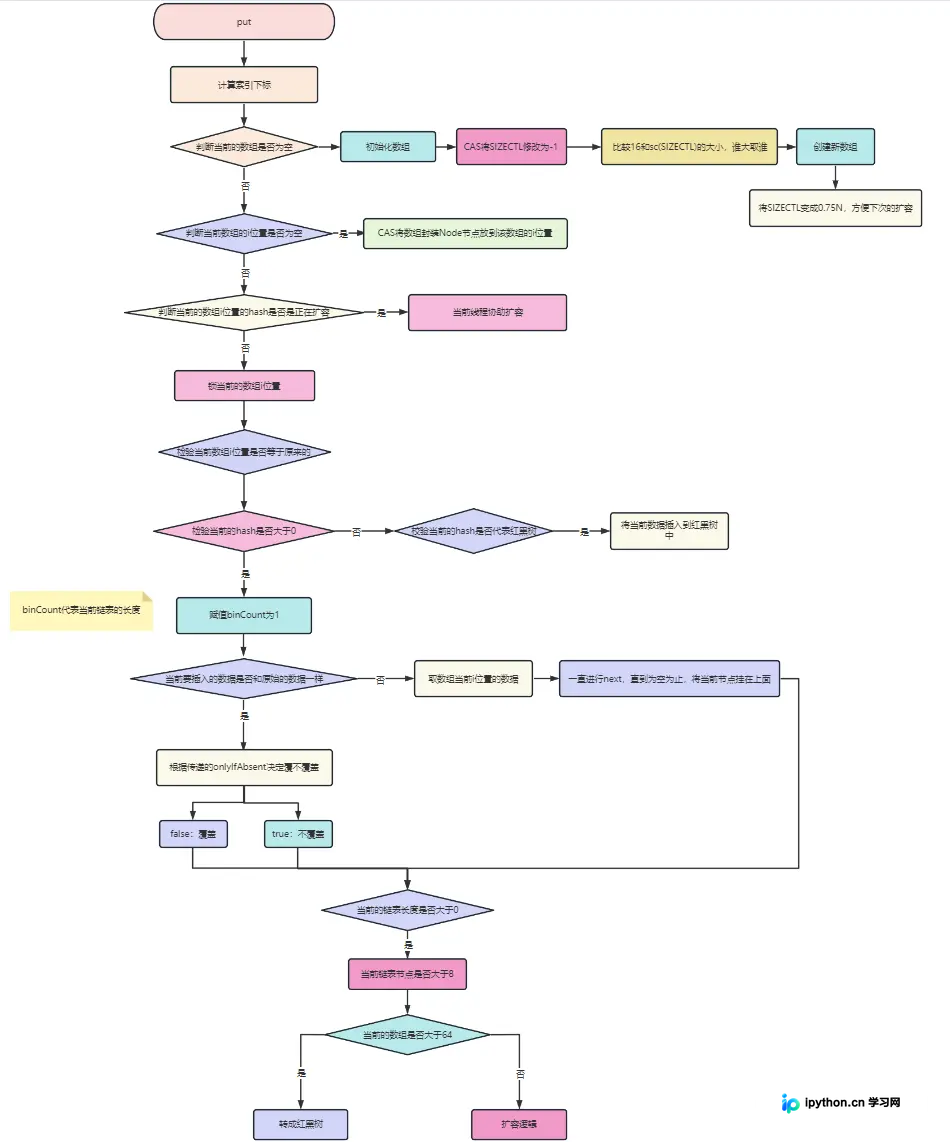
ConcurrentHashMap遵循“懒初始化”原则。在尝试存入第一个元素前,它会检查全局变量 table 是否为空。如果为空,则进入`initTable()`方法启动单线程初始化流程:
- 使用CAS操作将 `sizeCtl` 从当前值(通常为0或正数)修改为 -1。若修改失败,说明已有其他线程正在初始化,当前线程挂起等待。
- 初始化成功后,根据之前计算的容量创建 `Node
- 设定新的 `sizeCtl` 阈值为容量的0.75倍,这预示着后续的扩容红线。
节点插入与冲突解决策略
完成初始化后,程序根据 `(tab.length - 1) & hash` 运算得到具体的数组索引 `i`。随后进入核心的插入逻辑判断。
第3步:直接插入与自旋查找
如果指定位置 `tab[i]` 目前为空(即没有发生Hash碰撞),则无需加锁,直接利用CAS操作将新构建的Node节点替换到该位置。这一步体现了其细粒度的并发控制思想。
第4步:链表遍历与同步锁获取
若目标桶位已被占用,说明发生了碰撞。代码会通过自旋(while循环)不断检查当前节点的Hash状态:
1. 如果节点Hash值为 `MOVED (-1)`,表示正在进行扩容迁移,当前线程会调用 `helpTransfer` 协助扩容。
2. 若非上述特殊状态,说明是一个普通节点,程序会对该位置的节点头 `f` 施加 synchronized 锁。在JDK 1.8中,锁的粒度被缩小到了数组的单个桶(Bucket),从而实现了极高的并发效率。
4.1 链表挂载逻辑
在持有锁的状态下,顺着链表逐一比对Hash值和Key:
- 若发现相同的Key,且参数 onlyIfAbsent 为false(即常规put),则直接覆盖旧Value值。
- 若链表中找不到匹配的Key,则在尾部追加一个新的Node节点。
第5步:红黑树转换与TreeBin处理
随着数据量增加,单个桶位下的链表可能变得过长,导致查询性能退化至O(N)。为此引入了红黑树机制(TreeNode):
- 在插入链表的同时,会统计该链表的长度 `binCount`。
- 若 binCount >= TREEIFY_THRESHOLD (8),并不立即转为红黑树,而是先检查当前哈希表总容量。若总容量小于 MIN_TREEIFY_CAPACITY (64),优先选择扩容(双扩一倍)来降低碰撞率。
- 只有当容量达到64以上且链长持续超过8时,才会执行 `treeifyBin` 方法,将当前桶位的链表重构为红黑树结构,以提升检索速度。
总结与核心要点回顾
ConcurrentHashMap 的存储流程并非简单的添加数据,而是一套严密的并发调度体系。其核心特点在于:通过Hash扰动平衡分布、基于CAS无锁插入减少竞争、利用 synchronized 锁定最小组件处理复杂碰撞,以及结合容量阈值动态决定扩容还是树化。这套机制完美兼顾了读多写少场景下的高吞吐量与数据安全性。
以上就是深入解析Java ConcurrentHashMap存储流程与源码实现的详细内容,更多关于Java并发容器底层原理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















