


SQL语句执行顺序详解:图解核心逻辑

发布时间:2026-10-14 |
2人浏览过
本文深入解析 SQL 语句的核心执行顺序,重点剖析 SELECT 语句的逻辑处理流程。通过可视化的流程图,揭示代码书写顺序与实际运行顺序的差异,解答“为何 WHERE 中不能使用聚合函数”等经典问题,助你理解数据过滤与聚合的时间节点。
理解 SQL 的执行顺序
在学习数据库的过程中,我们常常按照 SELECT → FROM → WHERE → GROUP BY → HAVING → ORDER BY 的顺序来书写 SQL 查询语句。这种书写的直觉符合人类的阅读习惯,但数据库引擎在执行时,却是严格按照一套固定的逻辑顺序进行的。
准确理解这套执行顺序,对于编写正确的复杂查询、避免语法错误以及优化查询性能至关重要。下面我们通过一张图来看看它真实的运作方式:
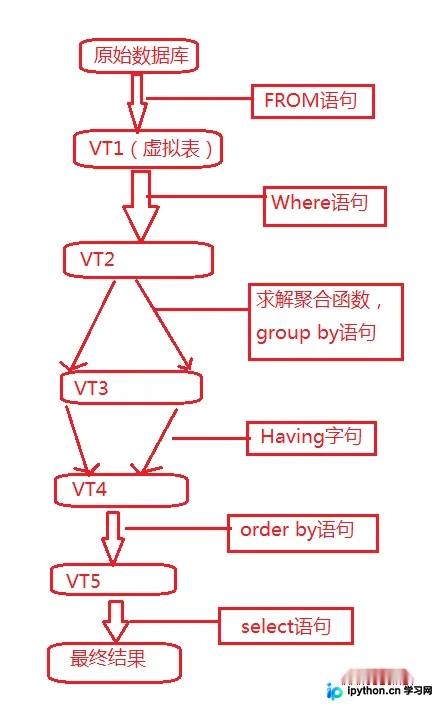
为什么 WHERE 里不能有聚合函数?
这是很多初学者遇到的一个经典难题。当我们尝试在 WHERE 子句中使用如 COUNT()、SUM() 等聚合函数时,数据库通常会报错。究其根本,就在于上述的执行顺序:
- 第一阶段:数据处理基础。
FROM确定数据来源,JOIN进行表关联。此时数据还未清洗或分组,完全是原始的表数据状态。 - 第二阶段:数据初步筛选 (WHERE)。系统根据
WHERE子句的条件,对原始数据行进行过滤。此时,数据尚未进入分组阶段,聚合操作还没有发生。 - 第三阶段:数据分组与再筛选 (GROUP BY & HAVING)。经过
WHERE过滤的数据才会被送入GROUP BY进行分组。聚合函数正是在这个阶段计算得出的。
由此可以清晰看出,WHERE 的执行时机远早于聚合函数的计算。如果在 WHERE 中出现聚合函数,由于此时这些函数的值尚未生成且不存在,数据库自然无法提供结果供判断使用。
正确应对分组后过滤的方法
如果你需要根据聚合结果(例如“找出员工数大于 5 的部门”)来过滤数据,应该使用 HAVING 子句而非 WHERE。
WHERE:在分组前过滤单行数据。HAVING:在分组后过滤分组统计的结果。
掌握这一逻辑,你就能彻底避开常见的语法陷阱,写出更加严谨的 SQL 查询。以上就是 SQL 语句执行顺序的详细内容,更多关于数据库原理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















