


Linux C语言中fork()函数原理与执行流程详解

发布时间:2026-10-14 |
4人浏览过
本文深入解析 Linux 系统中 C 语言的 fork() 函数,从函数原型、返回值机制到内存空间复制,结合代码示例阐明父进程与子进程的独立性及输出顺序差异,解决对进程创建过程的常见困惑。
fork() 函数基础定义
在 Linux 中进行多进程编程时,fork() 是最核心的系统调用。要正确使用该函数,首先需要了解其基本声明和返回值规则:
- 所需头文件:需包含
<unistd.h>和<sys/types.h>。 - 函数原型:
pid_t fork( void );。其中pid_t是在<sys/types.h>中定义的宏,本质为整型。 - 返回值逻辑:这是一个“一次调用,两次返回”的特殊函数。
- 父进程:返回新创建子进程的进程 ID(PID),且 PID > 0。
- 子进程:返回 0。
- 错误情况:若创建失败,返回 -1。
核心原理:内存空间的复制
理解 fork() 的关键在于明确“子进程是父进程的副本”。操作系统并不共享数据空间,而是进行拷贝。
在执行 fork() 调用前,系统中仅存在一个主进程。fork() 执行成功后,内核会在内存中分配一份新的页表和数据副本给子进程。这意味着父子进程虽然代码段相同,但堆、栈等数据空间是独立的。这种独立性保证了父子进程间的变量互不影响。
代码执行流程分析
通过一段典型的测试代码,可以直观地观察进程创建后的行为变化。
第1步:编写并运行基础测试代码
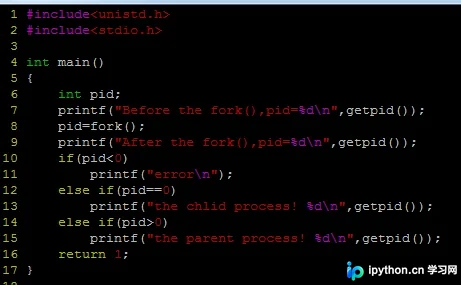
以下代码演示了如何通过判断返回值来区分父子进程,并观察输出语句的执行次数:
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>

int main() {
    printf("Before the fork ...\n"); // 步骤 A

    pid_t pid = fork();            // 步骤 B:创建子进程

    if (pid > 0) {                 // 步骤 C:父进程分支
        printf("After the fork (Parent: %d)...\n", pid);
    } else if (pid == 0) {         // 步骤 D:子进程分支
        printf("After the fork (Child: 0)...\n");
    }
    return 0;
}
第2步:追踪进程创建瞬间
当代码执行到 fork() 行时,内核完成资源复制。此时系统中存在两个几乎完全相同的进程实体:
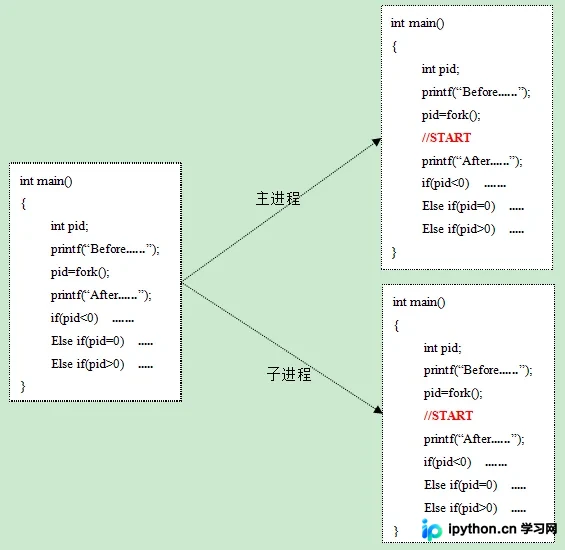
随后,这两个进程都会从 fork() 的下一行开始继续执行。由于返回值不同,它们将进入不同的分支:
- 父进程:
fork()返回子进程 PID(大于0),执行if (pid > 0)块。 - 子进程:
fork()返回 0,执行else if (pid == 0)块。
第3步:验证输出结果与执行顺序
运行上述程序后,屏幕输出的结果通常如下所示:
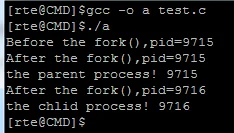
从中可以得出两个关键结论:
- 执行次数翻倍:“Before the fork ...”仅在父进程中执行一次;而随后的两行打印分别由父进程和子进程各执行一次,因此总共出现了两次“After the fork”。这证实了
fork()之后,后续代码是并行执行的。 - 调度不确定性:虽然第一条打印必然最先出现,但父进程和子进程谁先执行完最后的
printf取决于操作系统的调度策略。如果看到顺序互换,属于正常现象。
总结
fork() 函数通过将当前进程的数据空间原样拷贝,生成了一个新的子进程。它通过唯一的返回值让调用者能够区分自己是谁(父还是子),从而执行不同的业务逻辑。掌握这一机制是理解 Linux 多进程并发编程的第一步。以上就是Linux系统中C语言fork()函数执行解析的详细内容,更多关于C语言多进程编程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















