


Java对象深度克隆:基于序列化实现完全独立副本

在Java中,直接赋值仅拷贝引用,导致对象间数据耦合。虽然Cloneable接口可提供克隆能力,但默认仅为浅度克隆,嵌套对象依然共享。为解决深层依赖导致的引用污染问题,本文将演示如何利用Java原生的对象序列化机制,简单、可靠地实现真正的深度克隆。
对象引用的基本特性
在Java内存模型中,对象的引用变量存储在栈(Stack)中,而对象的具体实例数据存储在堆(Heap)中。当将一个非基本类型对象的引用赋值给另一个引用变量时,仅仅是栈中的指针地址被复制,两者最终都指向堆内存中的同一个对象实例。
例如以下代码逻辑:
public class CloneTest {
    private Long myLong = new Long(1);
}

// 测试代码片段
CloneTest ct1 = new CloneTest();
CloneTest ct2 = ct1;

ct2.myLong = 2L;
// 此时打印 ct1.myLong,结果同样为 2
这一现象表明,ct1 和 ct2 操作的是同一块内存数据。若业务场景要求两个变量相互独立,互不影响,简单的赋值操作无法满足需求。
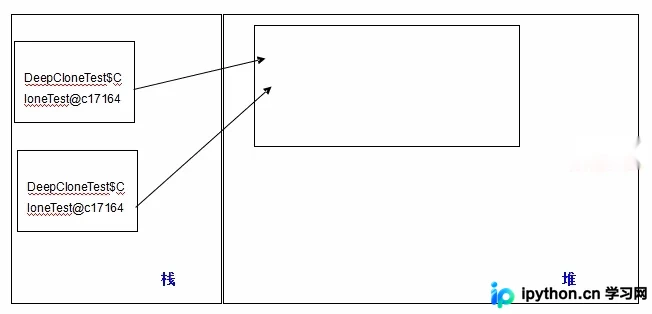
图1:栈区引用指向堆区同一对象示意图
传统克隆的局限性
为了实现对象的复制,Java提供了Cloneable接口及Object.clone()方法。只要类实现了Cloneable并重写clone()方法,即可生成新的对象实例。然而,这种方法存在一个致命缺陷:它执行的是浅度克隆。
对于含有内部对象属性(如List、自定义对象等)的类,super.clone()仅会复制这些内部对象在栈上的引用地址,而不会递归地创建内部对象的副本。这意味着新旧对象内部的子对象依然是同一个实体。
private class CloneTest implements Cloneable {
    private Object o = new Object();

    public CloneTest clone() throws CloneNotSupportedException {
        return (CloneTest) super.clone();
    }
}

// 输出验证
CloneTest ct1 = new CloneTest();
CloneTest ct2 = ct1.clone();
// ct1.o == ct2.o 返回 true
如图所示,虽然外层对象ct1和ct2是两个不同的内存地址,但它们所持有的成员变量o却指向了堆中同一个对象。如果需要克隆的对象层级很深,逐一编写每个子对象的克隆逻辑不仅繁琐,还极易遗漏。
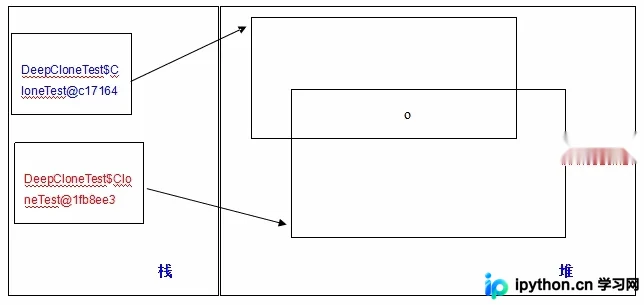
图2:浅度克隆后,内部对象依然共享
基于序列化的深度克隆方案
要实现彻底的“深度克隆”,即让新对象及其包含的所有内嵌对象都在堆上拥有独立的内存空间,最高效且不易出错的方法是借助对象的序列化与反序列化。
核心原理在于:当我们将一个对象序列化到字节流中时,JVM会将该对象及其引用的所有可达对象的状态完整抓取;随后从流中反序列化恢复时,JVM会从头开始在堆中重建整个对象树。因此,恢复后的对象与原对象不仅在顶层引用不同,其内部的每一层引用也均为全新的独立实例。
第1步:定义支持序列化的目标类
需要参与深度克隆的类必须实现Serializable接口。通常建议声明serialVersionUID以保持版本兼容性,防止因类结构微调导致反序列化失败。
第2步:封装深度克隆方法
利用ByteArrayOutputStream和ObjectInputStream/OutputStream完成一次完整的内存流转。代码如下:
import java.io.ByteArrayInputStream;
import java.io.ByteArrayOutputStream;
import java.io.IOException;
import java.io.ObjectInputStream;
import java.io.ObjectOutputStream;
import java.io.Serializable;

public class DeepCloneUtil {

    // 定义需克隆的类,必须实现 Serializable
    private class CloneTest implements Serializable {
        private static final long serialVersionUID = 1L;
        private Object o = new Object();
        // 其他字段...

        /**
         * 通过IO流进行深度克隆
         */
        public CloneTest deepClone() {
            CloneTest ct = null;
            try {
                // 1. 创建输出流并写入当前对象
                ByteArrayOutputStream baos = new ByteArrayOutputStream();
                ObjectOutputStream oos = new ObjectOutputStream(baos);
                oos.writeObject(this);

                // 2. 创建输入流并读取对象
                ByteArrayInputStream bais = new ByteArrayInputStream(baos.toByteArray());
                ObjectInputStream ois = new ObjectInputStream(bais);
                ct = (CloneTest) ois.readObject();
            } catch (IOException e) {
                e.printStackTrace();
            } catch (ClassNotFoundException e) {
                e.printStackTrace();
            }
            return ct;
        }
    }
}
第3步:使用与效果验证
调用上述deepClone()方法后,生成的新对象与原对象之间的所有关联都被切断。
CloneTest ct1 = new CloneTest();
CloneTest ct2 = ct1.deepClone();

System.out.println("ct1: " + ct1);       // 内存地址 A
System.out.println("ct2: " + ct2);       // 内存地址 B
System.out.println("ct1.o: " + ct1.o);   // 内存地址 C
System.out.println("ct2.o: " + ct2.o);   // 内存地址 D (C != D)
验证结果显示,不仅顶层对象不同,连内部的o对象也被独立克隆出来。至此,完成了真正的深度克隆。
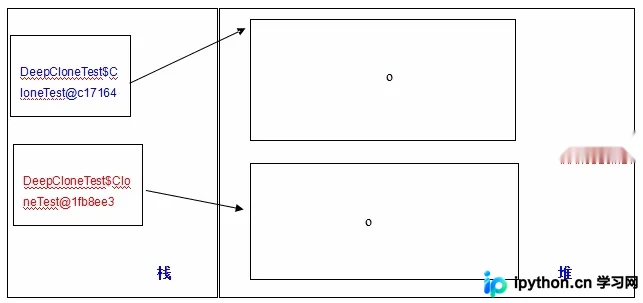
图3:序列化深度克隆后,内外对象均相互独立
注意事项
- 性能开销:相较于
clone()方法,序列化涉及大量的I/O操作和反射处理,性能较低。适用于对性能不敏感但对数据安全性要求高的场景,或者对象结构极其复杂难以手动遍历的情况。 - 静态变量限制:序列化只会保存非静态、非瞬态(transient)的成员变量状态。
static字段属于类级别而非对象级别,不会被序列化保存,反序列化后恢复为类的初始值或最新值。 - 线程安全问题:序列化过程中涉及的流对象并非线程安全,建议在局部作用域内创建和使用。
以上就是基于序列化存取实现java对象深度克隆的详细内容,更多关于java高级应用与面向对象设计的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















