


PHP利用Simple_html_dom实现LOL玩家数据远程抓取

发布时间:2026-10-14 |
1人浏览过
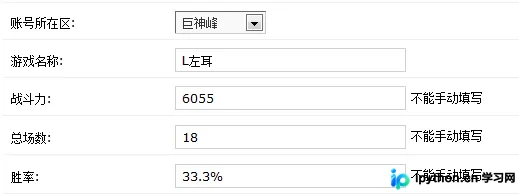
在Web开发中,前端JavaScript常受限于同源策略无法直接跨域获取第三方网站数据。本文演示如何利用PHP作为后端代理,结合Simple_html_dom库解析HTML结构,从多玩游戏盒子接口获取英雄联盟玩家的战斗力、胜率及排位场次信息。
核心思路与准备工作
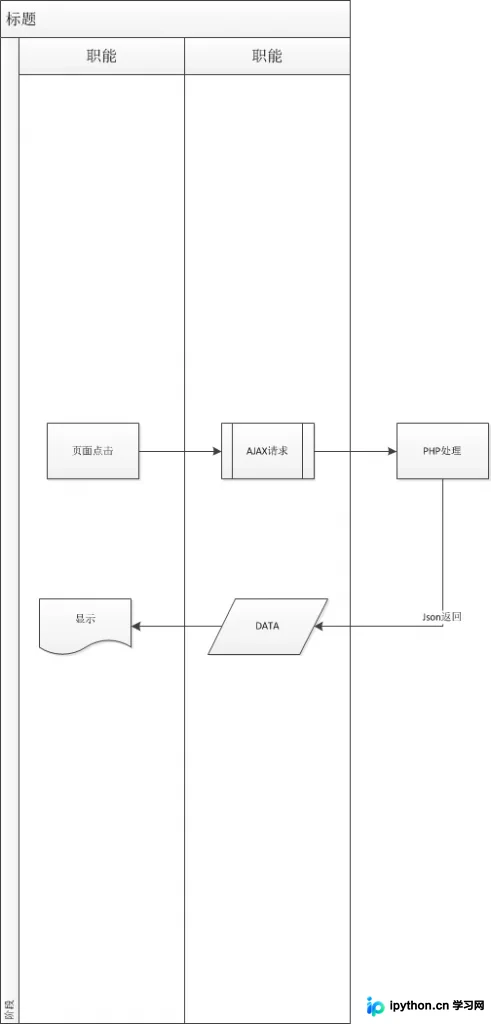
由于浏览器端的AJAX请求受同源策略保护,无法直接向非本站域名发送请求。解决方案是让PHP脚本作为服务器端代理:PHP向目标URL(如多玩LOLBX)发起HTTP GET请求,获取原始HTML内容,然后提取所需数据并返回给前端JSON格式结果。
所需工具:
- 运行环境:支持PHP的Web服务器(如Nginx/Apache)。
- 核心库:
simple_html_dom.php,一个用于解析HTML的PHP类库。 - 输入参数:游戏大区名称(如“艾欧尼亚”)和玩家昵称。
业务执行流程
整个数据采集过程的逻辑顺序如下:
- 接收请求:前端传递大区ID和用户名至PHP接口。
- 拼接URL:将参数拼接到多玩玩家详情查询页面URL中。
- 抓取HTML:使用
file_get_html下载目标页面的完整HTML源码。 - DOM解析:通过CSS选择器定位特定的数据元素(如战斗力数值、统计表格)。
- 清洗数据:剥离HTML标签,提取纯文本,并按规则整理成数组或对象。
- 返回结果:将处理后的结构化数据以JSON格式输出。
以下是该业务流程的示意图:
第1步:安装与引入Simple_html_dom
目的:加载HTML解析库以简化DOM操作。
操作:
- 下载
simple_html_dom.php文件。 - 在项目中将其放置在公共目录(如
@.ORG.SimpleHtmlDom对应路径)。 - 通过框架导入或直接require引入。
第2步:构建API接口代码
入口:PHP控制器方法(假设为 getData)。
动作:
以下是一个标准的抓取实现示例,展示了如何从多玩盒子接口获取玩家战力与排位数据:
public function getData() {
    // 1. 获取输入参数:游戏大区与玩家名字
    $server = isset($_POST['gameserver']) ? trim($_POST['gameserver']) : NULL;
    $name   = isset($_POST['gamename']) ? trim($_POST['gamename']) : NULL;

    if (!$server || !$name) {
        // 简单校验,实际需更严谨的错误处理
        return 'Parameter missing';
    }

    // 2. 引入解析库
    import("@.ORG.SimpleHtmlDom");

    // 3. 构造请求URL
    // 注意:URL可能随官方接口更新而变化
    $url = "http://lolbox.duowan.com/playerDetail.php?serverName=" . urlencode($server) . "&playerName=" . urlencode($name);

    // 4. 远程获取HTML内容
    $html = file_get_html($url);

    if ($html === false) {
        return 'Failed to fetch page';
    }

    try {
        $result = [];

        // 5. 解析战斗力数据
        // 假设 .fighting 是包含战斗力的容器
        $dom_zdl = $html->find('.fighting', 0);
        if ($dom_zdl) {
            $result['zdl'] = strip_tags($dom_zdl->innertext);
        }

        // 6. 解析排位综合数据 (通常位于 .J_content 下的特定结构中)
        $doms = $html->find('.J_content', 0)->children(1);
        if ($doms) {
            $temp = $doms->plaintext;
            // 清理空白字符并分割
            $tempArray = explode(" ", trim($temp));

            $cleanArr = [];
            foreach ($tempArray as $value) {
                if (!empty($value)) {
                    $cleanArr[] = trim($value);
                }
            }

            // 根据实际HTML结构索引调整以下数字
            // 此处仅为示例逻辑,需根据实际页面DOM结构调整
            if (count($cleanArr) > 14) {
                $pwtype = $cleanArr[8];  // 例如:“5v5单双排”
                $pwtotal = $cleanArr[12]; // 总场次
                $pwsl = $cleanArr[14];    // 胜场或其他指标

                if ($pwtype == "5v5单双排") {
                    $result['pw'] = $pwtotal;
                    $result['pwsl'] = $pwsl;
                } else {
                    $result['pw'] = "0";
                    $result['pwsl'] = "0";
                }
            }
        }

        // 7. 输出结果
        $this->ajaxReturn($result);

    } catch (Exception $e) {
        // 记录日志以便排查
        error_log($e->getMessage());
        return 'Parse error';
    } finally {
        // 8. 释放内存
        if (isset($html)) {
            $html->clear();
        }
    }
}
第3步:调试与DOM元素定位
完成状态判断:接口能稳定返回正确的JSON数据,且无PHP警告。
在开发过程中,最大的难点在于目标网站的DOM结构变化导致选择器失效。建议使用浏览器的开发者工具(如Chrome DevTools或Firebug)进行分析:
- 打开浏览器控制台,观察网络请求发出的真实URL。
- 检查返回的HTML源码,定位包含数据的具体Class或ID(如
.fighting,.J_content)。 - 使用
$html->find('class_name', index)验证是否能准确选中节点。
数据结构的内部逻辑梳理:
注意事项与局限性
- 反爬机制:多玩等大型网站可能会实施反爬虫策略(如Token校验、User-Agent检测)。若发现频繁抓取被禁,需增加
CURLOPT_USERAGENT或模拟Cookies。 - 动态渲染:部分数据如果是通过Ajax异步加载而非静态HTML,上述直接抓取HTML的方法将失效,此时需要逆向分析其内部API接口。
- 数据维护:上游网站的HTML结构一旦改版(如修改了class名),所有基于CSS选择器的解析代码都需要重新适配。
以上就是利用PHP和Simple_html_dom实现LOL玩家数据远程获取的详细内容,更多关于PHP网页爬虫技术的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















