


C语言KMP算法原理与实现:从暴力匹配到高效子串查找

KMP(Knuth-Morris-Pratt)算法是解决字符串模式匹配问题的经典高效算法。相比于朴素的暴力匹配方法,KMP通过预处理模式串生成部分匹配表(通常称为 Next 数组或 Prefix 函数),在主串与模式串失配时,利用已知的匹配信息跳过不必要的比较,从而避免主串指针的回溯,将时间复杂度从 O(mn) 降低至 O(m+n)。
朴素模式匹配的局限性
模式匹配的核心任务是:在主串 $A$ 中找到模式串 $B$ 首次出现的位置。朴素算法采用“暴力匹配”策略:
- 从主串的第一个字符开始,与模式串逐字符比较。
- 如果字符相同,继续比较下一个;如果不同,主串回溯到起始位置的下一个字符,模式串重置回首位,重新开始比较。
虽然实现简单,但当遇到大量局部匹配成功但最后失配的情况时,主串指针会反复回溯,导致最坏时间复杂度达到 $O(m \times n)$,其中 $m$ 为主串长度,$n$ 为模式串长度。
/*
 * 朴素模式匹配 C语言示例
 * 时间复杂度: O(m*n)
 */
#include <iostream>
#include <string>
using namespace std;

int index(char *a, char *b)
{
    int tarindex = 0;
    while(a[tarindex]!='\0')
    {
        int tarlen = tarindex;
        int patlen;
        for(patlen=0;b[patlen]!='\0';patlen++)
        {
            if(a[tarlen++]!=b[patlen])
            {
                break;
            }
        }
        // 如果模式串遍历完未提前跳出,说明找到匹配
        if(b[patlen]=='\0')
        {
            return tarindex;
        }
        tarindex++;
    }
    return -1;
}

int main()
{
    char *a = "abcdef";
    char *b = "cdf";
    cout<<index(a,b)<<endl;
    return 0;
}
KMP算法的核心思想
KMP算法的优化关键在于:当发生失配时,主串指针不回溯,仅移动模式串指针。这意味着,一旦主串的某个字符与模式串不匹配,我们不需要重新从主串的前一个位置开始比较,而是利用之前已经匹配成功的部分信息,确定模式串应该滑动到的新位置。
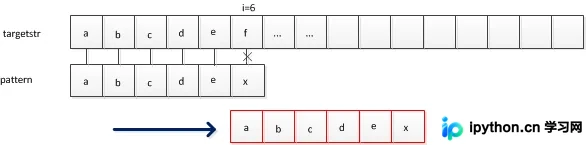
如上图所示,假设模式串前缀 `abc` 与主串匹配后,在下一位失配。由于模式串内部存在重复结构(如前面的 `a` 和当前的 `a` 或其他重复子串),我们知道主串中刚刚匹配过的部分不需要再比较。KMP的目标就是计算出在每次失配时,模式串指针 `j` 应该跳转到的新位置。
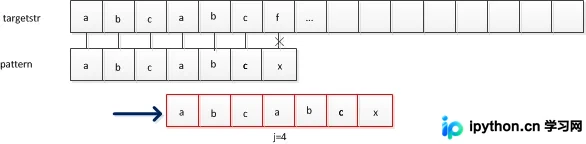
模式串指针 `j` 的新位置取决于模式串自身的前缀和后缀的相似程度。具体来说,它依赖于部分匹配值(即最长相等前后缀的长度)。如果模式串的前 `k` 个字符构成的前缀,与即将对齐的后缀相同,那么这些字符无需再次比较。
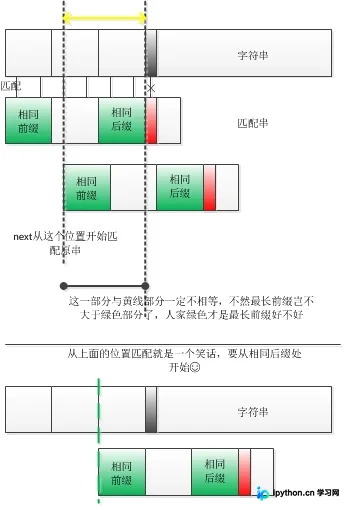
为了快速查询这个“跳跃”位置,我们需要预先计算并存储一个数组,通常称为 `next` 数组或 `pi` 数组(前缀函数)。该数组记录了模式串每个位置之前的子串中,最长相等前后缀的长度。
构建前缀函数(Next数组)
在实现 KMP 匹配之前,必须先构建模式串 $P$ 的前缀函数。伪代码如下:
// 伪代码:计算前缀函数 pi
compiter-prefix-function(P)
    m <- length[P]
    pi[1] <- 0
    k <- 0
    for q <- 2 to m
        do while k > 0 and P[k+1] != P[q]
                 k <- pi[k] // 回溯到前缀的前缀
        if P[k+1] == P[q]
            then k <- k + 1
        pi[q] <- k
    return pi
在实际C/C++实现中,通常对索引进行微调以适配 0-based 索引体系。核心逻辑一致:对于模式串的每一个位置,寻找其前面子串的最长相等前后缀长度。
KMP完整匹配实现
结合前缀函数,KMP 匹配过程的伪代码如下:
// 伪代码:KMP匹配器
kmp-matcher(T, P)
    n <- length[T]
    m <- length[P]
    pi <- compiter-prefix-function(P)
    q <- 0 // 当前匹配的字符数
    for i <- 1 to n
        do while q > 0 and P[q+1] != T[i]
                 q <- pi[q] // 失配时,q回退到pi[q]所指位置
        if P[q+1] == T[i]
            then q <- q + 1
        if q == m
            print “Pattern occurs with shift” i-m
            q <- pi[q] // 继续寻找下一次匹配
C语言实战代码如下(适配标准数组下标):
#include <stdio.h>
#include <string.h>

// 辅助函数:构建 next 数组
void compute_next(const char* pattern, int* next) {
    int m = strlen(pattern);
    next[0] = -1; // 或者根据实现习惯设为0
    int k = -1;
    for (int q = 1; q < m; q++) {
        while (k > -1 && pattern[k+1] != pattern[q]) {
            k = next[k];
        }
        if (pattern[k+1] == pattern[q]) {
            k++;
        }
        next[q] = k;
    }
}

// KMP 搜索函数
int kmp_search(const char* text, const char* pattern) {
    int n = strlen(text);   // 主串长度
    int m = strlen(pattern); // 模式串长度

    if (m == 0) return 0;

    int* next = (int*)malloc(m * sizeof(int));
    compute_next(pattern, next);

    int i = 0; // 主串索引
    int j = 0; // 模式串索引

    while (i < n) {
        if (pattern[j] == text[i]) {
            i++;
            j++;
        } else if (j == 0) {
            i++; // 模式串已到首部仍不匹配,主串后移
        } else {
            j = next[j-1] + 1; // 利用next数组跳跃
        }

        if (j == m) {
            free(next);
            return i - m; // 返回匹配起始位置
        }
    }

    free(next);
    return -1; // 未找到
}
性能分析与总结
KMP 算法的优势在于其线性时间复杂度 $O(n+m)$。然而,需要强调的是,KMP 算法仅在模式串与主串之间存在大量部分匹配的情况下才能体现出显著优势。如果模式串非常短,或者字符分布极其随机导致部分匹配极少,KMP 的 overhead(额外开销)可能使其表现与普通暴力算法无异甚至略慢。
总体而言,掌握 KMP 算法有助于深入理解字符串处理机制,是进阶数据结构与算法设计的必修内容。
以上就是C语言KMP算法原理与实现的详细内容,更多关于C语言字符串搜索与算法优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















