


C#中动态函数创建与闭包机制深度解析

本文详解C#动态创建函数的进化历程,涵盖从C# 1.0委托、2.0匿名函数到3.0 Lambda表达的演变。深入剖析强类型推断限制下的变量声明陷阱,并重点解释闭包的底层实现机制。通过编译器生成的匿名类代码实例,揭示跨作用域访问变量的原理及闭包在保护变量和保持逻辑连续性方面的优势,帮助开发者避免常见错误。
动态创建函数的演进
C#作为一门强类型语言,其支持动态创建或引用函数的能力经历了多次迭代优化。回顾这一过程,有助于理解现代C#简洁语法的由来及其背后的约束。
第1步:C# 1.0 基础委托定义
在早期版本中,开发者需要显式定义 delegate 并将其指向具体的方法实现。这种方式虽然功能完整,但代码结构相对繁琐,类似于C语言的函数指针概念。
public delegate string DynamicFunction(string name);
public static DynamicFunction GetDynamicFunction()
{
    return GetName;
}
static string GetName(string name)
{
    return name;
}
var result = GetDynamicFunction()("mushroom");
第2步:C# 2.0 引入匿名函数
C# 2.0 引入了匿名函数(Anonymous Methods),使得在不需要单独命名方法时,可以直接在代码块中定义函数逻辑。这减少了代码量,但仍保留了一定的语法开销。
public delegate string DynamicFunction(string name);
DynamicFunction result2 = delegate(string name)
{
    return name;
};
第3步:C# 3.0 Lambda 表达式的华丽转身
C# 3.0 引入的 Lambda 表达式彻底简化了匿名方法的写法,配合泛型委托 Func<T, TResult>,极大地提升了代码的可读性和编写效率。这是目前最常用的动态函数定义方式。
public static Func<string, string> GetDynamicFunction()
{
    return name => name;
}
var result = GetDynamicFunction()("mushroom");
Lambda 表达式的类型推断限制
尽管 Lambda 表达式简化了开发,但在强类型语境下直接使用 var 进行定义时会遇到编译错误。这是因为编译器无法仅凭右侧表达式推断出明确的委托类型。
错误示例与原因分析
当尝试直接为 Lambda 赋值给 var 时,由于缺少上下文,编译器不知道 name 的类型以及返回值的预期类型:
// 编译报错:无法推断 Lambda 参数类型
var result = name => name;
正确的类型声明方式
要解决这个问题,必须显式指定类型或使用兼容的强类型变量。以下是几种可行的方案:
- 指定参数类型:明确告诉编译器参数的具体类型。
Func<string, string> result2 = (string name) => name;- 使用 Expression 树:适用于动态查询场景。
Expression<Func<string, string>> result3 = (string name) => name;- 使用 dynamic 关键字:推迟类型检查至运行时。
dynamic result = name => name;
// 或者显式转换
dynamic result1 = (Func<string,string>)(name => name);- 委托兼容性注意:即使参数和返回值相同,自定义委托(如
DynamicFunction)与系统泛型委托(Func<...>)之间不能隐式转换,必须显式绑定或通过中间变量处理。
Func<string, string> function = name => name;
DynamicFunction df = function; // 此时可能需要适配或显式转换
理解 C# 中的闭包机制
闭包是指内部函数能够访问外部作用域中变量的现象。在 C# 中,这不仅涉及语法层面的允许,更涉及编译器如何重新组织内存布局以支持这种“携带状态”的行为。
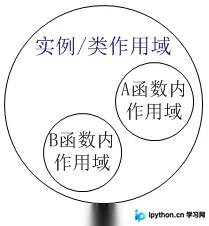
闭包的底层实现原理
编译器为了实现闭包,会将包含局部变量的函数上下文升级为一个匿名类实例。原函数内的变量被提升为该类的公共字段,而 Lambda 表达式则成为该类的一个实例方法。这样就打破了原有的栈帧隔离,实现了跨作用域的变量共享。
以下是一个典型的闭包示例及其编译后的等效伪代码:
源代码示例
Func<Func<int>> A = () =>
{
    var age = 18;
    return () =>
    {
        return age;
    };
};
var result = A()();
编译器生成的等效代码
编译器检测到内部匿名函数使用了外部变量 age 后,会自动生成一个类似 DisplayClass 的密封类来承载这些变量:
sealed class DisplayClass
{
    public int age; // 原局部变量被提升为字段
    public int A()  // 内部 Lambda 变成实例方法
    {
        return this.age;
    }
}

// 外部函数执行流程
static Func<int> B()
{
    DisplayClass cl = new DisplayClass();
    cl.age = 18; // 初始化上下文
    return new Func<int>(cl.A); // 返回绑定了实例的方法委托
}
作用域遮蔽与跨函数访问
值得注意的是,C# 的作用域规则较为严格。如果在同一函数内先使用后声明局部变量,会触发编译错误,因为新声明的变量会遮蔽(Shadow)外层同名变量。此外,闭包只能捕获父作用域(Enclosing Scope)的变量,同级其他函数的私有变量不可直接访问。
变量更新与生命周期
闭包不仅捕获变量值,而是捕获对变量的引用。这意味着如果外部修改了该变量,内部 Lambda 获取到的将是更新后的值。看下面的例子:
static Func<int, int> GetClosureFunction()
{
    int val = 10;
    Func<int, int> interAdd = x => x + val;
    Console.WriteLine(interAdd(10)); // 输出 20
    val = 30; // 修改外部变量
    Console.WriteLine(interAdd(10)); // 输出 40
    return interAdd;
}
Console.WriteLine(GetClosureFunction()(30)); // 输出 60
这个行为证明了 val 在闭包机制下不再是独立的栈上变量,而是一个持久化的实例字段。
闭包的实际应用优势
1. 数据保护与封装
在面向对象编程中,为了减少公共属性被误修改的风险,可以使用私有字段。而在函数式编程或脚本逻辑中,闭包提供了一种轻量级的封装手段:你可以暴露一个执行计算的方法,而不必暴露支撑计算的中间状态变量。这使得状态只能通过受控的操作进行修改。
2. 维持逻辑连续性
在处理异步任务或回调链时,闭包允许将当前上下文的状态自动传递给下一个环节,无需手动构建复杂的上下文对象或全局单例。无论是在 JavaScript 还是 C# 中,这种“带着数据的行为”都是构建复杂业务逻辑流的基石。
通过对比 JavaScript 的同名实现,我们可以看到闭包作为一种跨语言的通用模式,其核心在于函数对象的扩展性:函数不再仅仅是代码指令的集合,更是环境与状态的载体。
以上就是C#中动态函数创建与闭包理解的详细内容,更多关于C#高级特性与函数式编程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















