


PHP/JS中UTF-8与Unicode编码区别及字数计算实现

UTF-8采用1至3字节的不定长格式,而Unicode通常定义为2字节的定长格式。在前后端分离的开发场景中,常需在前端基于Unicode验证输入,在后端基于UTF-8计算存储长度。本文通过剖析两者的位运算转换规则,提供JavaScript和PHP环境下精确计算UTF-8字节数的核心代码。
UTF-8与Unicode的底层逻辑差异
理解两者的关系是解决长度校验问题的基础。UTF-8是一种针对Unicode码位的可变长度字符编码,而Unicode规定了字符的抽象编号。
核心转换对照表
| Unicode (Hex) | UTF-8 (Binary Pattern) |
|---|---|
| 0000 - 007F | 0xxxxxxx |
| 0080 - 07FF | 110xxxxx 10xxxxxx |
| 0800 - FFFF | 1110xxxx 10xxxxxx 10xxxxxx |
从UTF-8还原Unicode (解码)
解码的本质是将连续的二进制位剥离掉UTF-8固定的引导标记(如1110、10等),拼接回完整的Unicode数据位。
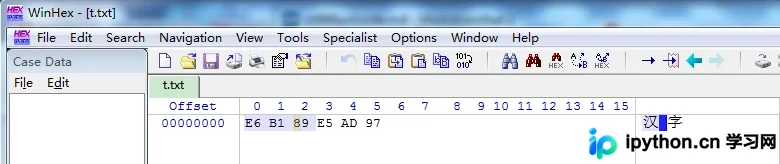
以汉字“字”为例:
- 获取字节:UTF-8十六进制为
E5AD97,对应二进制11100101 10101101 10010111。 - 匹配模式:首位符合
1110xxxx模式,确定为3字节字符。 - 提取有效位:去除前导位后提取
x部分,得到0101101、101101、010111。 - 重组字节:右对齐合并并补全左侧零位,得到16进制
5B57,这正是“字”的Unicode值。
从Unicode生成UTF-8 (编码)
反之,若要将Unicode转换为UTF-8,则是将16位二进制数据拆分填入预设的模板中。仍以 5B57 为例:
- 确定长度:
5B57落在0800 - FFFF区间,需占用3个字节。 - 拆分二进制:
5B57的二进制为0101 1011 0101 0111(16位)。 - 填充模板:按从高到低的顺序填入
1110xxxx 10xxxxxx 10xxxxxx。
最终得出的二进制序列即为 11100101 10101101 10010111,转化为十六进制即 E5AD97。
前端与后台的长度校验实现
当业务要求限制“单词最多30个字节”时,前端通常使用Unicode逻辑计算,而后端接收的是UTF-8字节流。为确保一致性,需在两端采用相应的计算策略。
第一步:前端 JS UTF-8 字节数计算
目的:在用户输入阶段预估字符串在传输到服务器后的UTF-8存储大小。
// 遍历每个字符的charCode进行判断
function utf8_bytes(str) {
 var len = 0, unicode;
 for(var i = 0; i < str.length; i++) {
  unicode = str.charCodeAt(i);
  // ASCII字符占用1字节
  if(unicode < 0x0080) {
   ++len;
  }
  // 基本多文种平面字符占用2字节
  else if(unicode < 0x0800) {
   len += 2;
  }
  // 其余字符(含大部分中文)占用3字节
  else if(unicode <= 0xFFFF) {
   len += 3;
  } else {
   throw "characters must be USC-2!!";
  }
 }
 return len;
}示例结果:utf8_bytes('燕睿涛') 返回 12 字节。
第二步:后端 PHP 长度计算
目的:准确计算数据库或日志存储所需的实际字节长度。注意区分源编码是否为GBK。
# 情况A:若原始字符串为 UTF-8 编码
$len = ceil(strlen(bin2hex($word))/2);

# 情况B:若原始字符串为 GBK 编码,先转UTF-8再计算
$len = ceil(strlen(bin2hex(iconv('GBK', 'UTF-8', $word)))/2);
上述方法利用 bin2hex 将二进制流转为16进制字符串(每个字节变为2个字符),除以2即可还原字节数,配合 ceil 处理整数计算,确保精度。
总结
掌握UTF-8与Unicode的位映射关系,有助于开发者在处理跨语言数据交互时规避乱码与长度错误。前端利用 charCodeAt 预判,后端通过 strlen + 编码转换确权,是实现精准控制的有效手段。以上就是PHP/JS中UTF-8与Unicode编码区别及长度计算实现的详细内容,更多关于技术趋势和开发规范的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















