


Python struct模块数据格式转换实战指南

本文详细讲解Python标准库struct模块的核心功能,涵盖pack与unpack的数据打包解包流程、calcsize长度计算以及pack_into内存直接写入方法。通过完整代码示例与格式符对照表,帮助开发者实现Python对象与二进制字节流的高效互转,解决跨平台或网络通信中的类型对齐问题。
Python结构体与字节流的转换需求
Python内置了字符串、整数、浮点数等基础数据类型,但在进行网络通信、文件读写或与C/C++等底层语言交互时,必须处理不同平台间的内存布局差异。例如,C++客户端发送的4字节整型数据到达Python服务器后,需要按特定规则解析为Python整数。stdlib提供的struct模块正是为此设计,它负责在Python原生数据类型与固定长度的字节流(bytearray)之间进行双向转换。
核心函数与代码实操
第1步:使用 struct.pack 将值转为字节流
目的:将多个Python数值按照指定格式转换为二进制字符串(字节流),便于网络传输或持久化存储。
入口与参数:struct.pack(fmt, v1, v2, ...),其中fmt为格式字符串,v1/v2为待转换的Python值。
import struct

a = 20
b = 400

data = struct.pack("ii", a, b)
print(f"Length: {len(data)}")
print(repr(data))执行后将返回长度为8的字节串。由于包含不可见控制字符,终端直接打印会显示乱码,推荐使用repr()查看十六进制表示(如'\x14\x00\x00\x00\xb0\x01\x00\x00',分别对应20和400的底层二进制编码)。
第2步:使用 struct.unpack 还原为Python类型
目的:将接收到的二进制字节流还原为原始的Python数据类型元组。
入口与参数:struct.unpack(fmt, string),返回解包后的元组。
val1, val2 = struct.unpack("ii", data)
print(val1, val2)运行结果将严格输出原始传入的数值:20 400。
第3步:计算格式字符串占用长度
目的:提前获知序列化后的字节总长,适用于缓冲区预分配。
入口与参数:struct.calcsize(fmt)。
size = struct.calcsize("ii")
print(size)默认情况下标准int(i)占用4字节,因此上述调用返回8。若格式符中包含填充字符或修改了对齐方式,计算结果可能因平台编译标准而略有变化。
第4步:在预分配内存中直接读写
目的:避免频繁创建新字符串对象,直接在已分配的内存缓冲区中进行原地打包与解包,提升高频场景性能。
入口与参数:struct.pack_into(fmt, buffer, offset, ...) 与 struct.unpack_from(fmt, buffer, offset=0)。
from ctypes import create_string_buffer

buf = create_string_buffer(12)
struct.pack_into("iii", buf, 0, 1, 2, -1)
print(struct.unpack_from('iii', buf, 0))上述代码首先在内存中开辟12字节空间,随后从偏移量0处连续写入三个整数。解包读取时将正确返回(1, 2, -1)。注意缓冲区容量需大于或等于格式要求的总字节数,否则引发索引越界报错。
常用格式符对照说明
格式符决定了数据的类型、大小及内存排列顺序。下表列出了C语言常见类型与Python的映射关系:
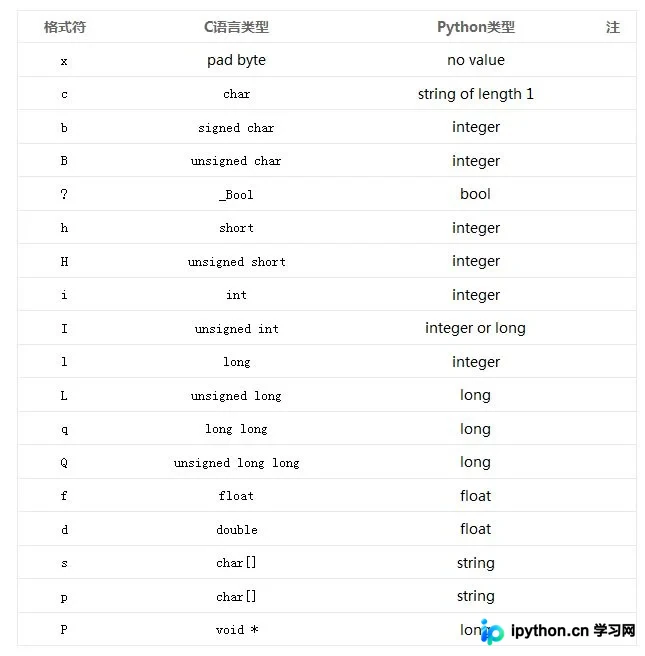
在实际应用中,建议固定使用网络字节序(大端)标识符!或本机对齐标识符@作为前缀,例如"!ii",以保证不同CPU架构机器间的数据兼容性。
注意事项与排错指引
若在执行打包时遇到struct.error,通常由以下原因导致:一是传入的参数数量与格式符位数不匹配;二是变量类型超出格式符指定范围(如向i传入超出32位有符号整数范围的超大数值)。此外,部分老旧教程使用的Python 2语法(如无括号print)在Py3环境中已失效,请统一升级至现代语法并留意bytes与str的类型隔离。跨语言通信时务必确认两端使用的格式化前缀一致,避免因大小端差异导致解析错位。
以上就是Python struct模块数据格式转换的详细内容,更多关于Python网络编程与内存管理的相关资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















