


跨机器将SQL Server数据同步至Access数据库

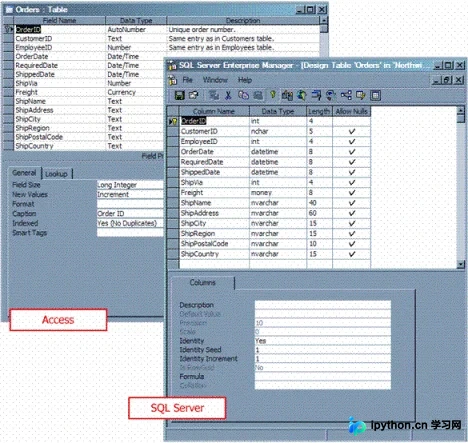
在使用ADO进行数据库开发时,有时需要将SQL Server中的数据迁移到本地或另一台机器上的Access文件。由于两者物理位置分离,直接使用的SQL链接服务器或OpenRowset方案不可行。这里介绍一种基于代码逻辑的稳健方法:通过创建双向Recordset对象,在内存中读取SQL数据并逐个写入Access,确保数据结构一致性。
核心思路
要实现这一操作,关键在于模拟“查询-插入”的过程。我们需要维护两个独立的数据库连接状态:
- 读取端:连接SQL Server,获取目标数据的Recordset对象。
- 写入端:连接Access文件,准备接收数据的Recordset对象。
由于表结构相同但字段数量可能较多,采用自动化循环遍历字段值是最灵活且不易出错的方式,避免手动编写冗长的INSERT语句。
环境准备
- 运行环境:支持COM组件调用的Windows环境(如C/C++ MFC环境)。
- 依赖库:需要引入ADO库支持,确保能够处理
_variant_t类型的数据转换。 - 网络/路径权限:应用程序需有权限访问远程SQL Server实例及本地的Access文件路径。
具体操作步骤
第1步:初始化双Recordset对象
目的:分别为SQL Server和Access建立数据指针。
入口:数据库连接字符串配置。
动作:实例化 m_pRecordset_sql 用于读取源数据,实例化 m_pRecordset_access 用于指向目标表。
第2步:构建数据同步循环
目的:将SQL Server中的每一行数据完整映射到Access中。
参数:m_pRecordset_sql->Fields->Count 决定循环次数。
动作:遍历所有字段,提取值并写入新记录。
参考以下核心逻辑代码,展示如何自动处理多字段的复制:
while (!m_pRecordset_sql->adoEOF)
{
    // 1. 在Access中新建一行记录
    m_pRecordset_access->AddNew();

    // 2. 遍历SQL端的每一个字段
    for (int i = 0; i < m_pRecordset_sql->Fields->Count; i++)
    {
        // 获取SQL当前行的字段值
        vValue = m_pRecordset_sql->GetCollect(_variant_t((long)i));
        // 将该值赋给Access的新建行对应字段
        m_pRecordset_access->PutCollect(_variant_t((long)i), vValue);
    }

    // 3. 提交当前记录到Access
    m_pRecordset_access->Update();
    // 4. SQL指针移至下一行
    m_pRecordset_sql->MoveNext();
}
第3步:异常处理与资源释放
在实际工程应用中,建议在循环外包裹 try-catch 块以捕获OLEDB错误。同时,确保在同步完成后正确调用 Release() 方法关闭Recordset和Connection对象,防止内存泄漏或文件锁定。
完成判断
当 while 循环结束,即 m_pRecordset_sql->adoEOF 为真时,表示源数据已全部处理。此时检查Access文件中记录条数是否与SQL Server查询结果一致,即可确认同步成功。
排错指南
- 类型不匹配错误:如果某些特定字段(如日期或长文本)复制失败,通常是因为VARIANT类型转换隐式转换出错。建议针对特殊字段进行显式类型判断(如检查
vValue.vt)。 - 并发冲突:确保在写入Access期间,没有其他进程正在占用该MDB/ACCDB文件。
简要总结
通过上述步骤,我们利用编程手段绕过了数据库层面的直连限制,实现了稳定的跨平台数据搬运。这种方法虽然比直接的SQL语句稍慢,但其适应性强,能完美处理异构数据库间的结构映射问题。以上就是跨机器将SQL Server数据同步至Access的详细解决方案,更多关于数据库开发与优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















