


C语言实现矩阵乘法:基础算法与斯特拉森优化

掌握C语言中的矩阵乘法不仅涉及基础的行列对应规则,更关乎算法对内存访问效率的优化。本文将拆解标准算法、内存友好型改进算法以及用于加速大块计算的斯特拉森(Strassen)算法,提供可直接参考的代码实现。
矩阵相乘的基本条件与规则
在编程进行矩阵运算前,必须明确两个矩阵能够相乘的前提条件。假设矩阵A与矩阵B相乘得到结果矩阵C,需满足以下逻辑:
- 维度匹配:矩阵A的列数必须严格等于矩阵B的行数。
- 结果维度:结果矩阵C的行数等于矩阵A的行数,列数等于矩阵B的列数。
- 元素计算:C中第i行第j列的元素,等于A的第i行所有元素与B的第j列对应元素乘积之和。
这一过程通常通过公式 C[i][j] = Σ(A[i][k] * B[k][j]) 来表示。为了直观理解,可以参考下方图示展示的矩阵结构关系:
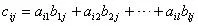
例如,当两个特定矩阵进行运算时,具体的数值变换过程如下所示:
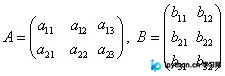
经过计算后,得到的最终结果矩阵示意如下:
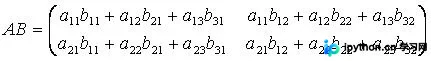
常用矩阵相乘算法:按列访问
最直观的算法是严格按照定义,用A的第i行分别和B的第j列的各个元素相乘求和。这种写法逻辑清晰,但在C/C++等语言中,二维数组按内存布局通常是连续的行存储。因此,直接按照 B[k][j] 的方式访问会导致跨行跳跃,降低缓存命中率。
操作目的:实现标准的三重循环矩阵乘法。
入口参数:矩阵A (a[4][5])、矩阵B (b[5][3])、结果矩阵C (c[4][3])。
核心动作:
void arymul(int a[4][5], int b[5][3], int c[4][3]) {
    int i, j, k;
    int temp;
    // 遍历结果矩阵的行
    for(i = 0; i < 4; i++){
        // 遍历结果矩阵的列
        for(j = 0; j < 3; j++){
            temp = 0;
            // 累加对应元素的乘积
            for(k = 0; k < 5; k++){
                temp += a[i][k] * b[k][j];
            }
            c[i][j] = temp;
            printf("%d\t", c[i][j]);
        }
        printf("%d\n");
    }
}完成状态:矩阵C被正确填充,且输出格式整齐。
改进算法:按行访问优化内存效率
为了提高存储器访问效率,建议让A、B、C都按行顺序访问数据。由于C语言中数组元素在内存中是按行优先存储的,连续的内存读取速度远快于随机跳跃。
操作目的:优化缓存命中,将B的访问改为按行模式。
核心逻辑:对于A的第i行,第j列的元素,不再去乘B的第j列,而是参与B的第j行所有元素的计算。具体来说,利用一个临时数组 temp 来累加当前行各列的结果。
void arymul1(int a[4][5], int b[5][3], int c[4][3]) {
    int i, j, k;
    int temp[3] = {0}; // 用于暂存当前行的计算结果

    for(i = 0; i < 4; i++){
        // 初始化当前行的临时累加器
        for(k = 0; k < 3; k++)
            temp[k] = 0;

        // 遍历A的当前行元素
        for(j = 0; j < 5; j++){
            // A的第i行第j个元素,乘以B的第j行所有元素,累加到temp
            for(k = 0; k < 3; k++){
                temp[k] += a[i][j] * b[j][k];
            }
        }
        // 将累加结果存入C,并输出
        for(k = 0; k < 3; k++){
            c[i][k] = temp[k];
            printf("%d\t", c[i][k]);
        }
        printf("%d\n");
    }
}完成状态:结果与标准算法一致,但B的访问模式变为连续的 b[j][k],更适合现代CPU缓存机制。此外,这种思路极易扩展到稀疏矩阵的乘法优化中。
斯特拉森(Strassen)算法实现
对于大规模矩阵,传统的分块算法需要进行8次子矩阵乘法和4次加法。斯特拉森在1969年提出了一种算法,只需7次乘法即可合成更大的矩阵乘法,降低了时间复杂度。
二阶矩阵的斯特拉森推导
考虑两个二阶矩阵A和B:
A = | a11 a12 |
    | a21 a22 |
B = | b11 b12 |
    | b21 b22 |
我们定义7个中间变量来计算结果C=AB:
x1 = (a11 + a22) * (b11 + b22)
x2 = (a21 + a22) * b11
x3 = a11 * (b12 - b22)
x4 = a22 * (b21 - b11)
x5 = (a11 + a12) * b22
x6 = (a21 - a11) * (b11 + b12)
x7 = (a12 - a22) * (b21 + b22)
最终的C矩阵元素可以通过这些x值组合得出:
c11 = x1 + x4 - x5 + x7
c12 = x3 + x5
c21 = x2 + x4
c22 = x1 + x3 - x2 + x6
代码实现与应用
在实际工程中,通常递归应用此逻辑处理更大尺寸(如4阶、8阶)的矩阵。以下是基于此逻辑实现的2x2和4x4 C语言代码框架:
第一步:实现2x2核心计算函数
// 计算2X2矩阵乘积
void Multiply2X2(float& fOut_11, float& fOut_12, float& fOut_21, float& fOut_22,
                 float f1_11, float f1_12, float f1_21, float f1_22,
                 float f2_11, float f2_12, float f2_21, float f2_22) {
    const float x1((f1_11 + f1_22) * (f2_11 + f2_22));
    const float x2((f1_21 + f1_22) * f2_11);
    const float x3(f1_11 * (f2_12 - f2_22));
    const float x4(f1_22 * (f2_21 - f2_11));
    const float x5((f1_11 + f1_12) * f2_22);
    const float x6((f1_21 - f1_11) * (f2_11 + f2_12));
    const float x7((f1_12 - f1_22) * (f2_21 + f2_22));

    fOut_11 = x1 + x4 - x5 + x7;
    fOut_12 = x3 + x5;
    fOut_21 = x2 + x4;
    fOut_22 = x1 - x2 + x3 + x6;
}
第二步:扩展至4x4矩阵计算
将4阶矩阵划分为四个2阶块,利用上述函数并行或顺序计算块间的交互:
// 计算4X4矩阵 (假设使用自定义CLAYMATRIX结构体)
void Multiply(CLAYMATRIX& mOut, const CLAYMATRIX& m1, const CLAYMATRIX& m2) {
    float fTmp[7][4];

    // 这里调用Multiply2X2处理各个分块的运算组合
    // ... (具体索引映射依据块的位置ma11, mb12等进行偏移) ...

    // 第一块结果组合
    mOut._11 = fTmp[0][0] + fTmp[3][0] - fTmp[4][0] + fTmp[6][0];
    mOut._12 = fTmp[0][1] + fTmp[3][1] - fTmp[4][1] + fTmp[6][1];
    mOut._21 = fTmp[0][2] + fTmp[3][2] - fTmp[4][2] + fTmp[6][2];
    mOut._22 = fTmp[0][3] + fTmp[3][3] - fTmp[4][3] + fTmp[6][3];

    // 其他块的类似赋值...
}
性能对比与总结
| 指标 | 标准算法 | 斯特拉森算法 (4阶) |
|---|---|---|
| 加法次数 | 48 | 72 (含24次减法) |
| 乘法次数 | 64 | 49 |
| 额外空间 | 无 | 约28*sizeof(float) |
虽然斯特拉森算法增加了加法和减法的运算量,也消耗了额外的内存空间,但由于浮点乘法的耗时远高于加减法,因此在处理较大尺寸的矩阵时,整体运算速度会有所提高。对于C语言科学计算入门,建议先掌握基本的行/列访问优化,再根据实际场景决定是否引入复杂的分块算法。
以上就是C语言科学计算中矩阵乘法的相关计算详细内容,更多关于C语言算法优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















