


SQL Server批量生成INSERT脚本的存储过程实现

发布时间:2026-10-13 |
4人浏览过
在SQL Server数据库中,当需要将数据导出为INSERT脚本时,传统的单行插入方式在处理大量数据时性能较差。通过创建一个名为usp_GetInsertSQL的存储过程,我们可以自动生成支持多行模式(UNION ALL)或单行模式的INSERT语句。该脚本能自动识别列类型、处理NULL值并正确转义特殊字符,从而生成可直接执行的高效率批量插入代码。
核心逻辑与参数说明
该存储过程的核心在于动态拼接T-SQL字符串,根据表结构自动构建查询语句。它支持两种输出模式:
- 单行模式(默认):每行生成独立的
INSERT INTO ... VALUES (...)语句,适合数据量较小的场景。 - 多行模式:利用
UNION ALL连接多个SELECT结果,大幅减少语句数量,提升大数据量下的执行效率。
主要输入参数如下:
@chvnTable:目标数据表名称(建议不带方括号分隔符)。@chvnWhere:可选的过滤条件(不包含WHERE关键字)。@bitIsSingleRow:布尔值,0表示多行模式,1表示单行模式。
部署存储过程
首先,需要在数据库中创建该存储过程。以下代码涵盖了数字、日期、字符串及Unicode类型的特殊处理逻辑(如单引号转义):
IF OBJECT_ID(N'dbo.usp_GetInsertSQL', 'P') IS NOT NULL
BEGIN
    DROP PROCEDURE dbo.usp_GetInsertSQL;
END
GO

CREATE PROCEDURE dbo.usp_GetInsertSQL
(
    @chvnTable NVARCHAR(128),   -- 数据表名称
    @chvnWhere NVARCHAR(MAX) = N'', -- where查询条件(不带WHERE关键字)
    @bitIsSingleRow BIT = 1     -- 是否单行模式,默认为单行模式(1:单行, 0:多行)
)
AS
BEGIN
    SET NOCOUNT ON;
    SET @bitIsSingleRow = ISNULL(@bitIsSingleRow, 1);

    DECLARE
        @intTableID AS INT,
        @chvnSchemaTableName NVARCHAR(517); /*格式:[schema].[table]*/

    SELECT
        @intTableID = object_id,
        @chvnSchemaTableName = QUOTENAME(SCHEMA_NAME(schema_id)) + N'.' + QUOTENAME(@chvnTable)
    FROM sys.objects
    WHERE name = @chvnTable
      AND type = 'U';

    IF @intTableID IS NULL
    BEGIN
        RAISERROR('Table not found.', 16, 1);
        RETURN;
    END

    DECLARE
        @chvnColumnNames NVARCHAR(MAX),    -- 字段列名集
        @chvnColumnValues AS NVARCHAR(MAX); -- 字段列值拼接逻辑

    SELECT
        @chvnColumnNames = ISNULL(@chvnColumnNames + N',', N'') + QUOTENAME(T.column_name)
        ,@chvnColumnValues = ISNULL(@chvnColumnValues + N' + '','' + ', N'') + CAST(T.column_value AS NVARCHAR(MAX))
    FROM (
        SELECT
            name AS column_name,
            /*针对不同数据类型生成安全的值提取逻辑*/
            column_value = CASE
                WHEN system_type_id IN (56, 127, 106, 108, 48, 52, 59, 60, 62, 104) /*数字/货币等*/
                    THEN 'CASE WHEN '+ name + ' IS NULL THEN ''NULL'' ELSE CAST(' + name + ' AS VARCHAR)' END'
                WHEN system_type_id IN (40, 41, 58, 61, 42, 58, 58) /*日期时间类型简化判断*/
                    THEN 'CASE WHEN '+ name + ' IS NULL THEN ''NULL'' ELSE '''''''' + REPLACE(CONVERT(VARCHAR(30), ' + name + ', 121), '' ::.''', '''''') + '''''''' END'
                WHEN system_type_id IN (167) /*varchar*/
                    THEN 'CASE WHEN '+ name + ' IS NULL THEN ''NULL'' ELSE '''''''' + REPLACE(' + name + ', ''''''', '''''''''') + '''''''' END'
                WHEN system_type_id IN (231) /*nvarchar*/
                    THEN 'CASE WHEN '+ name + ' IS NULL THEN ''NULL'' ELSE ''N'''''' + REPLACE(' + name + ', ''''''', '''''''''') + '''''''' END'
                ELSE '''NULL'''
            END
        FROM sys.columns
        WHERE object_id = @intTableID
    ) AS T;

    IF @chvnColumnValues IS NULL
    BEGIN
        RAISERROR('Columns not found or unsupported types.', 16, 1);
        RETURN;
    END

    DECLARE @chvnTSQL AS NVARCHAR(MAX);
    DECLARE @chvnInsertIntoBody AS NVARCHAR(MAX) = N'''INSERT INTO '+ @chvnSchemaTableName + N' (' + @chvnColumnNames + N')''';

    IF @bitIsSingleRow = 0 -- 多行模式
    BEGIN
        SET @chvnTSQL = N'SELECT ''SELECT '' + ' + @chvnColumnValues + ' AS RowData, ROW_NUMBER() OVER(ORDER BY (SELECT NULL)) AS RowNum FROM ' + @chvnSchemaTableName;

        IF LEN(@chvnWhere) > 0
        BEGIN
            SET @chvnTSQL = @chvnTSQL + ' WHERE ' + @chvnWhere;
        END

        -- 使用ROW_NUMBER处理首行无UNION ALL,后续行添加UNION ALL
        SET @chvnTSQL = N'SELECT CASE WHEN T.rownum = 1 THEN REPLICATE(N'' '', LEN(N''UNION ALL '') + 1) + T.RowData ELSE N''UNION ALL '' + T.RowData END' +
            N' FROM (' + @chvnTSQL + N') AS T';
        SET @chvnTSQL = N'SELECT '+ @chvnInsertIntoBody + N';' + @chvnTSQL;
    END
    ELSE -- 单行模式
    BEGIN
        SET @chvnTSQL = N'SELECT ' + @chvnInsertIntoBody +
            N' + ''VALUES('' + ' + @chvnColumnValues + ' + '');'' FROM ' + @chvnSchemaTableName;
        IF LEN(@chvnWhere) > 0
        BEGIN
            SET @chvnTSQL = @chvnTSQL + ' WHERE ' + @chvnWhere;
        END
    END

    PRINT @chvnTSQL;
    EXEC sp_executesql @chvnTSQL;
END
GO
测试环境准备
为了验证效果,我们创建一个包含不同数据类型和重复数据的测试表UserLoginInfo:
IF OBJECT_ID(N'dbo.UserLoginInfo', N'U') IS NOT NULL
BEGIN
    DROP TABLE dbo.UserLoginInfo;
END
GO

CREATE TABLE dbo.UserLoginInfo (
    ID INT IDENTITY(1, 1) PRIMARY KEY,
    Name VARCHAR(50) NOT NULL,
    LoginTime DATETIME NOT NULL
);
GO

-- 插入测试数据
INSERT dbo.UserLoginInfo (Name, LoginTime) VALUES
('zhang', '2023-10-01 10:00:00'),
('li', '2023-10-01 11:00:00'),
('wang', '2023-10-01 12:00:00');
GO
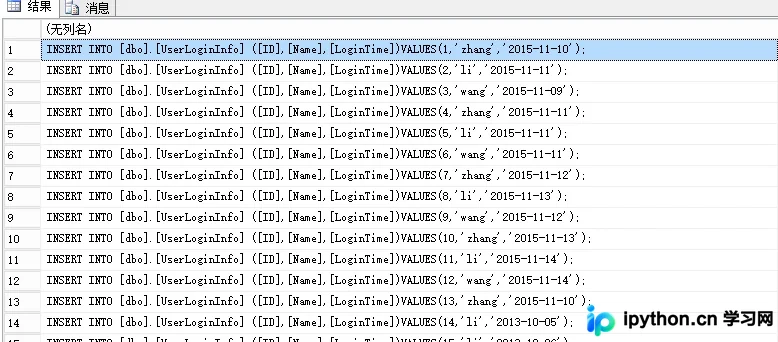
第1步:执行单行模式插入脚本
适用于少量数据调试,每条记录对应一个完整的INSERT语句。
EXEC dbo.usp_GetInsertSQL
    @chvnTable = N'UserLoginInfo',
    @chvnWhere = N'',
    @bitIsSingleRow = 1;
GO
执行结果示例如下,生成了标准的单行插入语句:
第2步:执行多行模式插入脚本
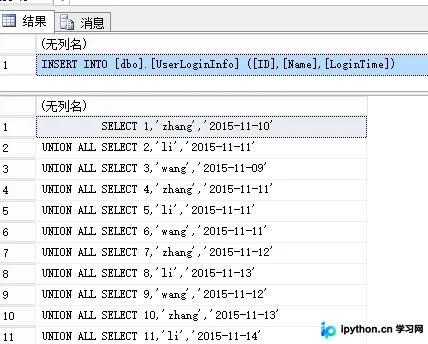
适用于生产环境数据迁移或大批量导入。生成的脚本包含UNION ALL结构,显著减少网络传输和解析开销。
EXEC dbo.usp_GetInsertSQL
    @chvnTable = N'UserLoginInfo',
    @chvnWhere = N'',
    @bitIsSingleRow = 0;
GO
执行效果如下,所有数据被合并为一个长查询块:
注意事项
- 结果合并:在多行模式下,如果数据量极大,输出可能截断。建议在实际应用中将结果重定向到文件或结合BULK INSERT使用。
- 特殊字符:存储过程已内置对单引号(')和NULL值的转义处理,但极端情况下仍需在生成后复核关键数据。
- 性能差异:对于超过数千行的表,强烈建议使用
@bitIsSingleRow = 0以获取最佳性能。
以上就是SQL Server中数据行批量插入脚本的存储实现的详细内容,更多关于SQL Server批量生成INSERT语句的技巧资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















